在线AI教程 / AI入门
[Amazon Bedrock] 可插拔 agentic AI 框架:Amazon Bedrock AgentCore 上的七层可组合企业级 agenti…
可插拔 agentic AI 框架:Amazon Bedrock AgentCore 上的七层可组合企业级 agentic AI 参考架构 「我们如何在生产环境中大规模运行我们的
可插拔 agentic AI 框架:Amazon Bedrock AgentCore 上的七层可组合企业级 agentic AI 参考架构
「我们如何在生产环境中大规模运行我们的 AI agents?」这是每个客户最终都会问的问题。它还附带着一连串问题:我们如何安全且有把握地处理数千个并发用户请求?我们如何确保 agents 在真实流量下保持可靠,而不是悄无声息地失败?我们如何知道一个 agent 是否仍然满足它在测试期间通过的质量与安全标准?agent 安全的最佳实践是什么?它应该是确定性的还是非确定性的?等等许多问题。概念验证(proof-of-concept)回答不了其中任何一个,因为它的构建目的是展示 agent 模型能完成任务,而不是在生产流量、成本压力和安全审查下存活。
从一个能跑的原型,到一个在规模之上可靠、安全、节俭且负责任地运行的系统,两者之间的落差正是大多数 agentic AI 项目停滞的地方,而这很少是模型的错。每个构建 agent 的团队往往都从零重建同一套脚手架:自己的路由逻辑、自己的 guardrails、自己的可观测性,而且都是事后补上,而不是从一开始就内建。团队需要一个共享的、生产就绪的架构,让每个 agent 都能在其上构建。
本文介绍一个七层可组合参考架构,旨在将多 agent AI 应用从原型带到生产规模。
可组合架构
Pluggable Agentic AI Framework 是一个面向多 agent 应用的参考架构,组织为七层,每层都有明确的职责和稳定的契约。每层中展示的服务与技术反映的是参考实现,而非强制选择。组织可以替换为与其现有基础设施和需求相符的替代方案。这些层共同提供了一份在生产规模上构建、保护和运营 agentic AI 应用的蓝图。
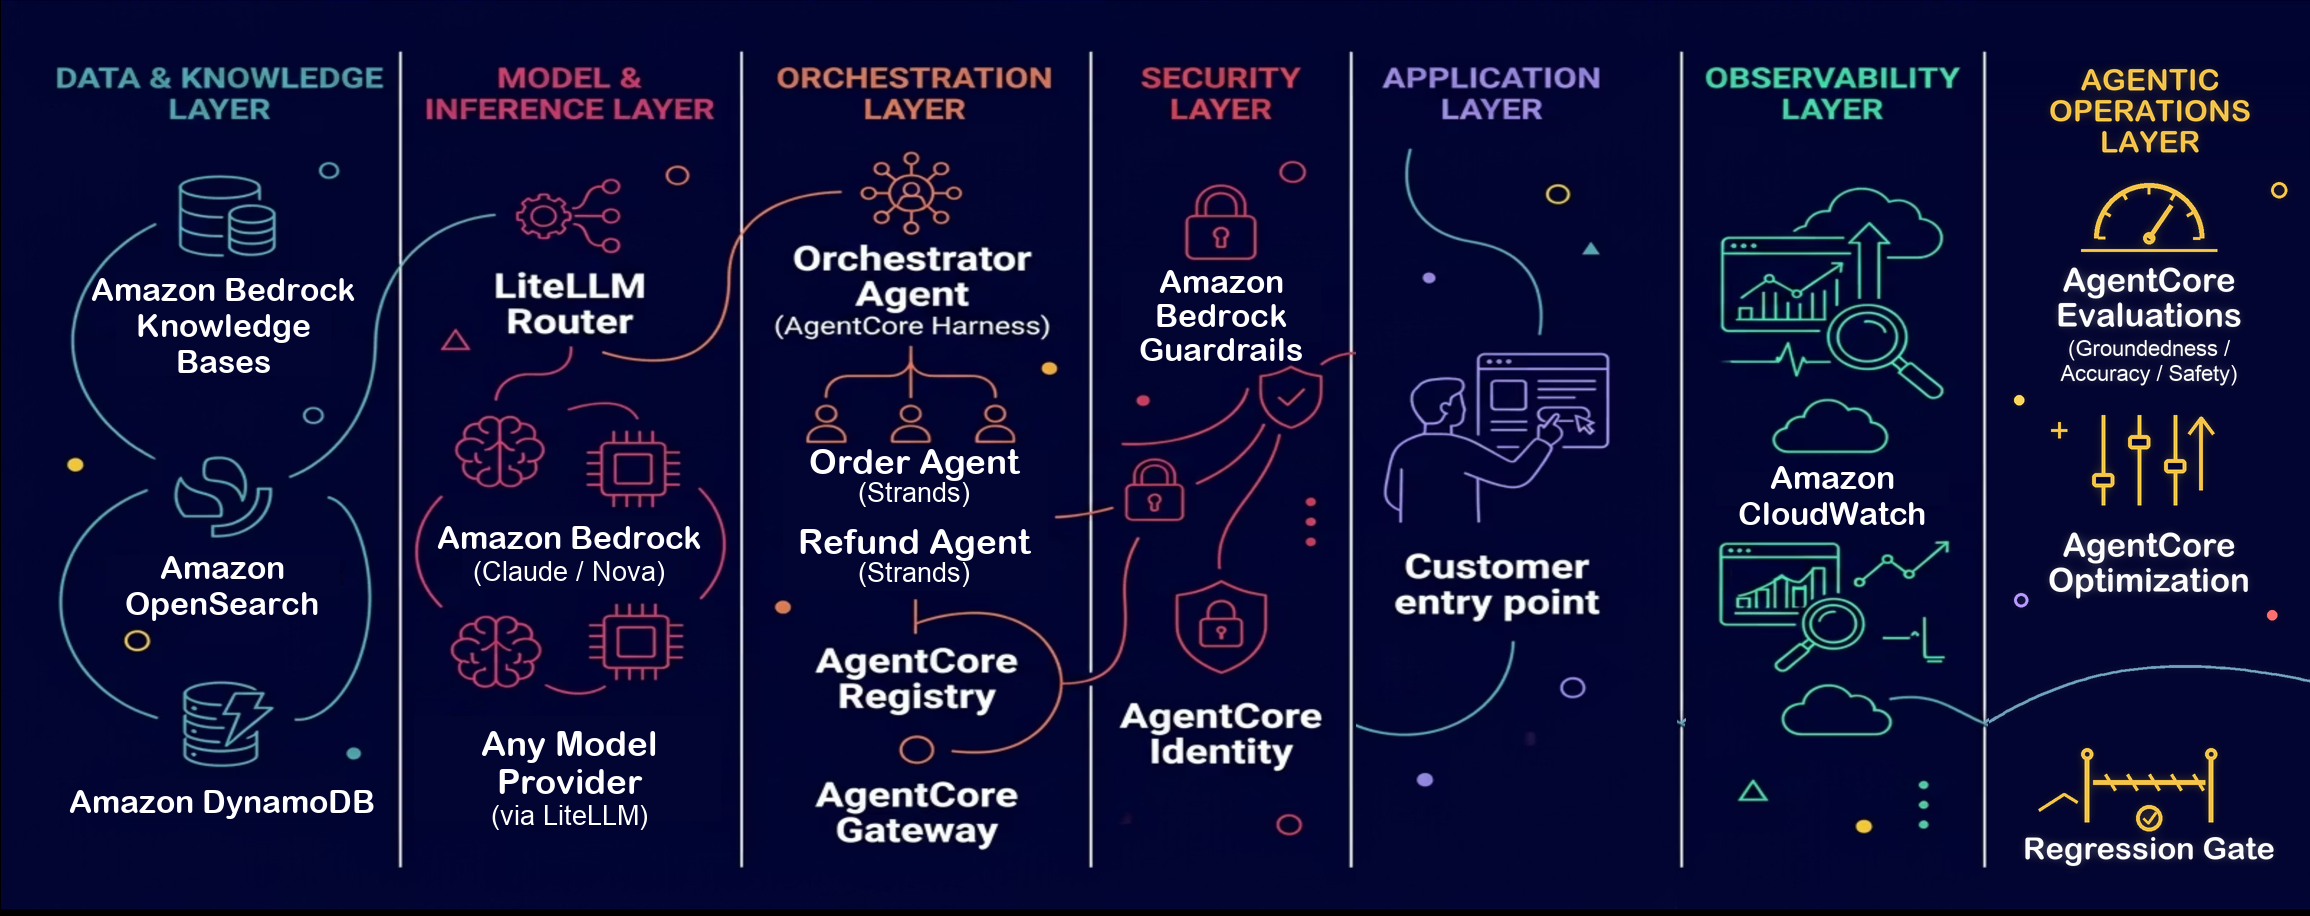
图 1:Pluggable Agentic AI Framework 的七层
数据与知识是 Agentic AI 的基础。一个 agent 的好坏取决于它能访问的数据。无论 agent 是在查询医疗药品目录、跟踪库存,还是解读合规规则,它都需要相关且最新的信息才能正确回答。这一层通过清晰的契约和协议负责检索、embeddings 以及对结构化与非结构化数据的访问:接受一个查询,返回最相关的信息,作为 agent 的上下文。Amazon Bedrock Knowledge Base、Vector Engine for Amazon OpenSearch Serverless、Amazon S3 Vectors 和 Amazon DynamoDB 是这一基础的示例构建块。
模型与推理的选择应由配置驱动,而不是硬编码进 agent 或应用逻辑。简单任务用更小、更快的模型,需要更细致推理的请求用更大的模型。重要的是针对你正在构建的用例,用真实且有代表性的业务数据开展彻底的模型评估。模型路由层依靠一致的请求-响应契约,让 AI agents 与模型托管环境和提供商特定的 API 解耦。像 LiteLLM 这样的 proxy 提供了跨提供商的统一接口,因此你可以基于评估结果切换模型,而无需重写应用逻辑。
编排决定工作如何分配,选择正确的方式至关重要。对于简单直接的任务,用单个 agent 端到端处理工作。对于复杂的跨域工作流,用一个 supervisor 委派专家 agents,每个专家 agent 限定于特定能力,并绑定特定的工具集。避免构建一个包办一切的 agent。随着工具、指令和上下文不断累积,context window 会增长,延迟会上升,准确性可能受损。工具泛滥随之而来,这可能把 agents 推出其预期边界,导致非预期的操作和安全漏洞。拆分职责让每个 agent 的上下文保持聚焦,也让延迟更可预测。你还可以独立测试每个 agent 的行为、独立扩展它、独立定义它的安全模型。强制实施有界自治:专家 agents 应严格在其被授予的工具范围内执行,不做任何超出之事。
除了分解为具体的专家 agents 并设定其边界之外,还要把专家 agents 与 supervisor agents 解耦。让 supervisor 从一个集中式 agent registry 发现专家 agents,并通过 MCP (Model Context Protocol) 和 A2A (Agent to Agent) 这样的标准化协议调用它们。维护一个集中式 agent registry,编目每个 agent 的工具、技能和负责人。这为你的组织提供了大规模治理所需的可见性,通过可复用性提升 AI agent 的实现速度,并避免重复开发的成本。可以考虑用 Strands Agents 构建专家 agents,用 Amazon Bedrock AgentCore harness 作为 orchestrator,用 AWS Agent Registry 和 Amazon Bedrock AgentCore Gateway 实现集中式发现与路由。
安全与 guardrails 应是首要关切,从第一天起就内建于设计之中。Agentic AI 让组织暴露于一类新型风险之下,而传统安全框架并不是为应对它们而构建的——从 prompt injection、工具滥用,到记忆与数据投毒。默认把所有外部内容视为不可信。通过 Amazon Bedrock AgentCore Identity 这样的服务认证每一个请求,无论它来自用户、另一个 agent 还是自动化工作流。然后使用细粒度访问控制,在执行前判定每个工具调用是否被允许。授予 agents 临时的、范围受限的凭证,而不是持久密钥。在数据保护方面,对 agent 与工具的请求和响应中的敏感数据进行掩码处理,例如 PHI (Personal Health Information) 和 PII (Personally Identifiable Information),使敏感客户信息不会出现在 agent 输出中,也不会残留在记忆里。为了可问责,把每个重大决策记录进防篡改的审计轨迹,让高影响操作经过人工审批关卡,并部署 circuit breakers,在异常行为升级之前将其制止。可以考虑用 Amazon Bedrock Guardrails 处理用户输入,用 Amazon Bedrock AgentCore Identity 和 Policy in Amazon Bedrock AgentCore 做认证与访问控制,再配合 AWS 安全与治理控制,带来纵深防御的安全。
应用是最终用户体验所在之处,无论是聊天界面、API 接口还是嵌入式 widget。刻意保持这一层薄。它唯一的职责应该是呈现对话,并把请求传递给下面的编排层。抵制在这里嵌入业务逻辑的冲动。分离越干净,你就越容易迭代用户体验而不破坏后端的稳定。一个决策模型可以坐镇这个边界,作为快速、低成本的检查:一次调用就能给请求打分——判断它是否在范围内、是否需要人工、是否紧急——返回概率而不是自由文本。你的代码用简单的阈值对这些分数采取行动,直接回答离题请求并标记需要升级处理的情况,使完整的 agentic 循环只在它有价值时才运行。构建应用层时,想一想另一个 AI agent 要与人类一起消费你的 AI agents 并与之交互,需要什么。据此构建你的外部接口。
可观测性应从第一天起就监看每一层,而不是等到第一次事故之后。除了日志和指标,端到端的 agent traces 对于度量 agent 是否正确执行了任务至关重要。伴随 trace,收集每个请求的成本与 token 用量、time to first token、调用是否安全,并在上线前呈现延迟、错误率和支出的仪表盘。主动监控比被动救火更便宜。可以考虑用 Amazon CloudWatch 配合 OpenTelemetry,再加上 Amazon CloudWatch Omni 做 tracing 与指标,获得对整个技术栈的全面可见性。
Agentic 运维通过持续评估闭合这个循环,所以从第一天起就把它搭建好。对每个生产会话的 groundedness、准确性和安全性打分,并设置回归关卡,在质量下降到达客户之前抓住它。没有它,你只知道 agent 在发布时能用。有了它,你能证明它在之后的每次发布后仍然能用。可以考虑用 Amazon Bedrock AgentCore Evaluations 打分,用 Amazon Bedrock AgentCore optimization 做持续的性能调优。
零售客户支持 agent 的参考实现
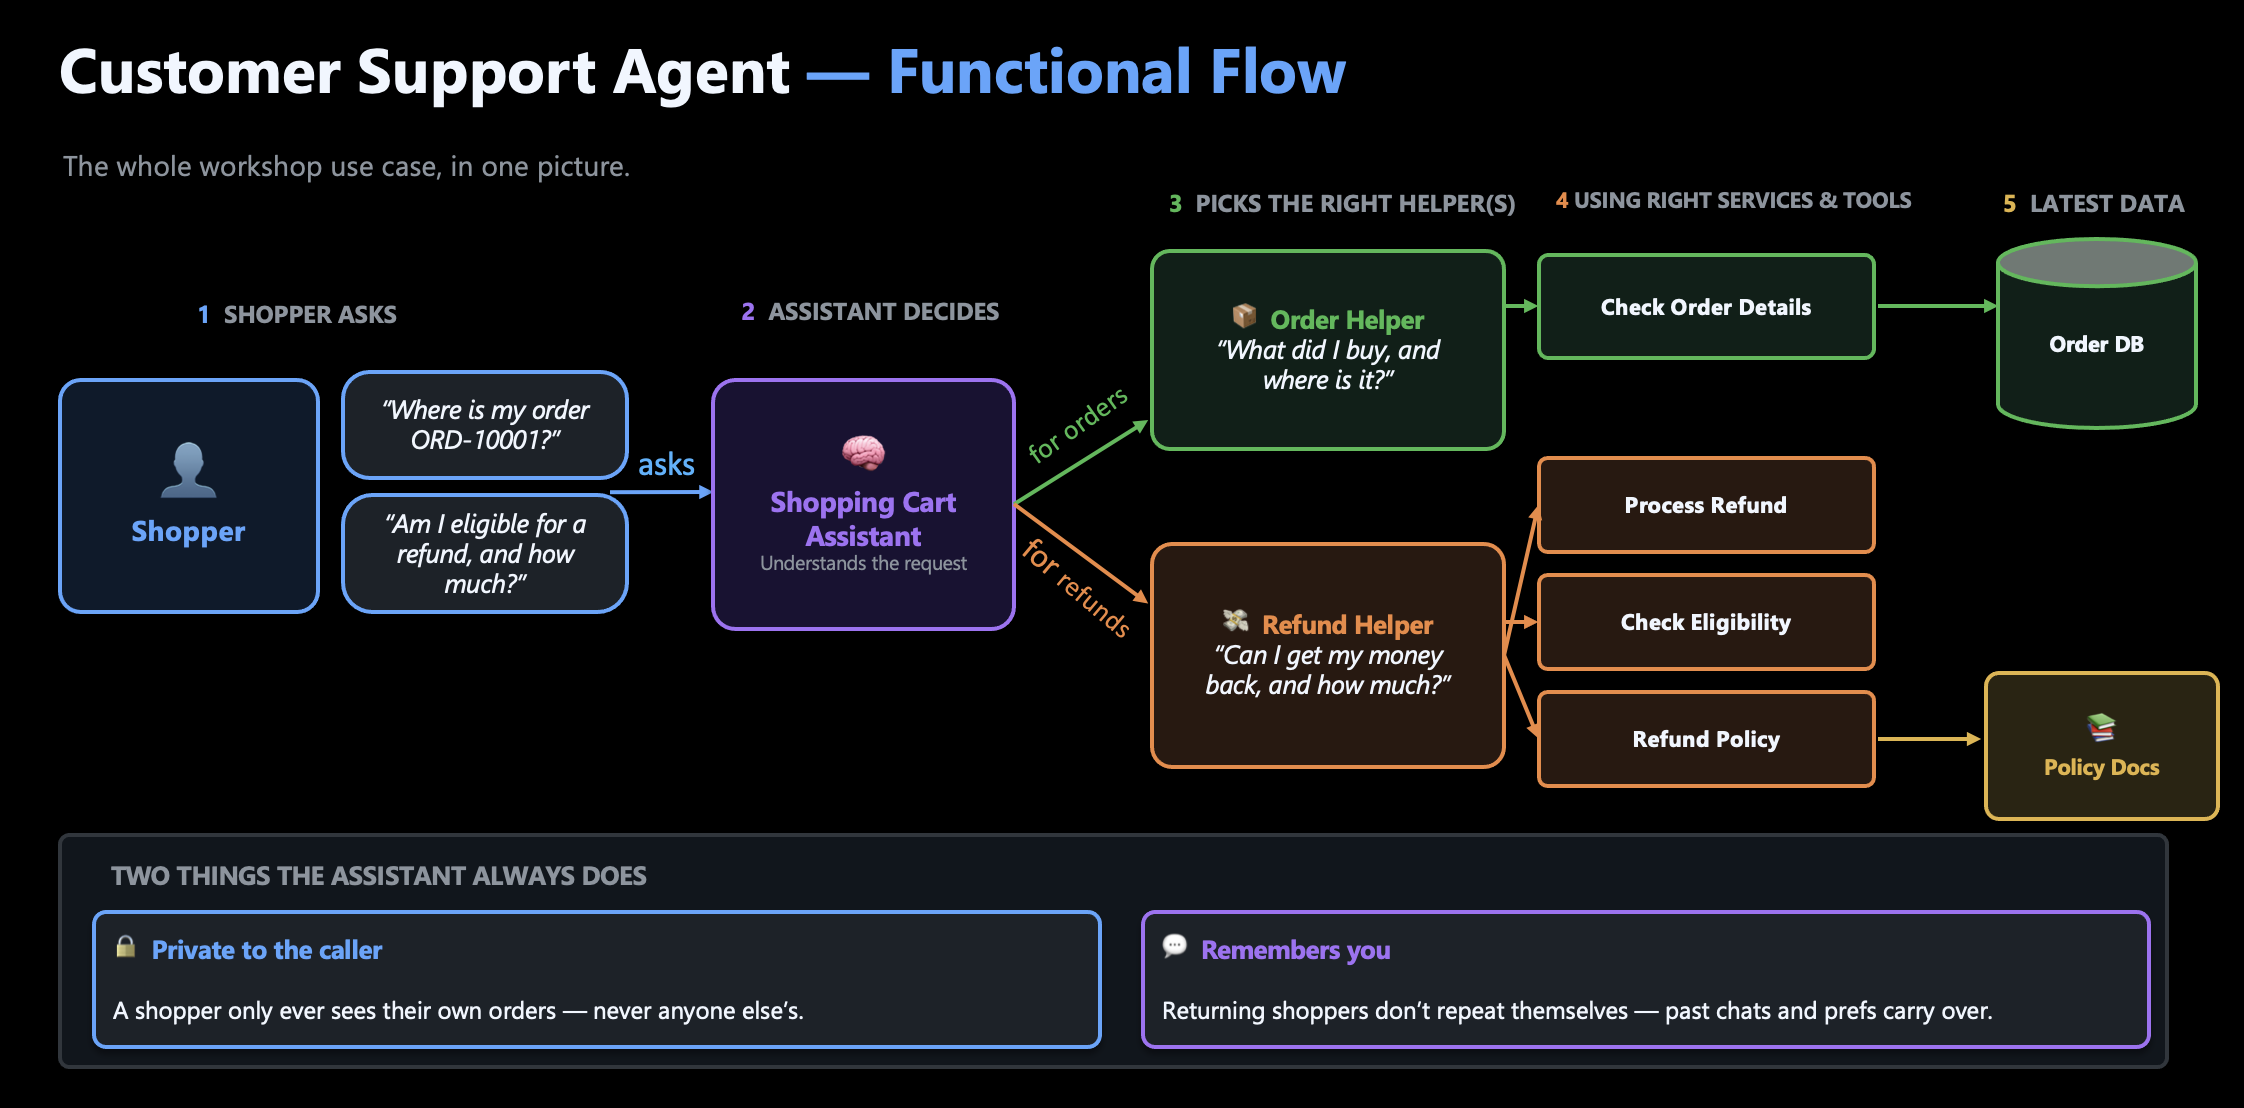
图 2:零售客户支持参考实现的功能流程
为了让架构落地,框架包含一个开箱即跑的参考实现,基于覆盖订单状态与退款资格的零售客户支持场景。我们选择这个用例,是因为它演练了技术栈的每一层,同时又足够直观,团队可以跟进并适配到自己的需求。
一个 supervisor agent 接收客户的退款请求,并委派给一个 Order agent 和一个 Refund agent,两者都是拥有范围受限工具集的专家。Order agent 从 Amazon DynamoDB 查询配送与购买详情。Refund agent 从知识库检索基于等级的政策规则,并用配送日期、当前日期和客户的忠诚度等级计算资格。这些调用中的每一个都经过 AgentCore Gateway,它在工具执行之前用 Policy in AgentCore 强制实施细粒度访问控制;每个调用都通过可观测性层被端到端追踪,因此当计算出错时,trace 能准确显示是哪一层、哪个决策点导致的。
任何构建类似 supervisor-专家模式的人,都可以克隆这个参考实现,逐层换入自己的领域逻辑。
为什么可插拔性与各层本身同样重要
七层架构的价值不仅在于它如何分离职责,还在于每一层能多快演进。可插拔性让这成为可能。层边界上的稳定契约——从身份检查和访问策略到遥测接口——让你更换底层技术而无需重新设计技术栈的其余部分。本质上,构建 agentic AI 系统要采取架构优先的方式,而不是技术驱动的方式。
框架通过跨层与第三方提供商的集成来演示可插拔性,从而把这一点付诸实践:推理层的模型与托管提供商、编排层的搜索能力、应用层的决策 API、安全层的 guardrails,以及可观测性层的 agent tracing 与监控方案,外加业务价值与成本跟踪。它在每一层都支持行业标准的提供商,因此你可以组合出满足你特定需求的解决方案。
对企业而言,灵活性保护既有投资。团队可以保留他们已经信任的可观测性、安全与推理工具,在需要的地方填补缺口,并增量式地采用新能力。这个架构提供一致的基础,而不要求每个技术决策都来自同一供应商。
结论
一个能跑的原型证明 agent 能做什么。一个设计良好的架构决定你的企业能否依赖它。迈向 AI 运营意味着从第一天起就把安全、治理、可见性、成本控制、可靠性和适应性设计进系统,而不是在系统建成之后再添加。
Pluggable Agentic AI Framework 把这些关切纳入一个架构,其原则清晰:构建稳定的基础,同时不把每个技术选择都锁死。模型会变。工具会演进。业务需求会转移。你的架构应该让这些变化可控,而不是把每一次变化都变成一次重建。
把这个原则付诸实践。从 Workshop Studio 体验 开始,探索公开示例仓库,并把这个动手实现作为你自己架构的起点。它不能替代生产环境的安全加固、测试与审查。
构建你今天需要的能力,以及你明天将需要的灵活性。
关于作者