在线AI教程 / AI入门
[Amazon Bedrock] 使用 Amazon Bedrock Managed Knowledge Base 进行单次与 agentic 检索
使用 Amazon Bedrock Managed Knowledge Base 进行单次与 agentic 检索 一位银行运营员工早上开始工作时,先问内部 AI 助手:开设企业账
使用 Amazon Bedrock Managed Knowledge Base 进行单次与 agentic 检索
一位银行运营员工早上开始工作时,先问内部 AI 助手:开设企业账户需要哪些文件。答案就在一份清单里。几小时后,同一位员工又问:这些要求在独资企业、LLC 和拥有多位所有者的合伙企业之间有何不同。这个答案分散在几份政策指南里。同一个助手必须处理这两个问题:第一个要又快又省,第二个要详尽。应用需要一种方式,把检索投入与每个请求匹配起来,而不必为简单问题和复杂问题分别构建两套系统。
Amazon Bedrock Managed Knowledge Base 现在通过 AgenticRetrieveStream 支持 single-shot Retrieval Augmented Generation(RAG)和 retrieval-only 请求。使用 single-shot RAG 时,服务只检索一次你的知识库,并用一个 foundation model(FM)基于找到的段落生成答案。使用 retrieval-only 请求时,服务返回匹配的段落而不生成答案,你的应用或用户可以直接处理源文本。这两种模式与已有的 agentic retrieval 并列——后者由服务先规划并执行多次检索,再作答。现在,你可以用同一个 API 处理这位员工的两个问题:查清单用 single-shot RAG,跨政策比较用 agentic retrieval。
在本文中,我们解释这些新设置如何工作,以及每种模式该在什么时候使用。我们用一个示意性的内部银行政策助手,展示 single-shot RAG 如何处理直接的问题、agentic retrieval 如何支持跨政策文档的比较。我们还会展示:当员工需要审阅源段落而不是生成的答案时,如何配置 retrieval-only 请求。
主要优势
Agentic retrieval 帮助助手回答需要不止一次检索的问题。foundation model 把问题拆成子查询,检索相关的知识库,并评估结果是否提供了足够的信息来回答原始问题。如果发现缺口,它可以在配置的迭代上限内细化检索、获取更多证据。
对应用构建者来说,这带来几项好处:
更好地支持多部分问题 – 有针对性的检索可以为问题的每个部分找到证据,而不是指望一次检索覆盖所有内容。在银行示例中,助手可以先分别查询独资经营者和 LLC 的要求,再进行比较。 信息缺失时追加检索 – 规划器可以根据已找到的内容决定下一步检索什么。当某个段落提供的上下文不足时,它还可以检索整份文档,帮助弥补单次检索可能遗留的缺口。 带支持证据的答案 – 启用响应生成时,服务把检索到的信息整合成带引用的答案。trace 事件展示规划与检索步骤,帮助开发者检查答案是如何产生的。 更少的自定义编排 – 服务通过一个 API 管理规划、检索、评估和响应生成的整个工作流。应用不必自己实现循环来协调这些步骤。
这些 agentic 能力对复杂问题依然有价值。对于直截了当的查询,应用也需要一种无需额外规划就能检索并作答的方式。扩展后的 maxAgentIteration 取值范围补上了这个缺口。只用一个参数,你就可以为每个请求选择三种模式之一:
Retrieval-only 返回段落,不生成答案。 Single-shot RAG 检索一次并生成答案,没有规划轮次。 Agentic retrieval 为复杂问题规划并执行多次检索。
Single-shot RAG 用一次 foundation model 调用生成答案,与 agentic retrieval 相比可以降低延迟和模型用量。Retrieval-only 请求不调用 foundation model。你可以为每个请求平衡速度与答案质量,无需集成第二个 API,也不必为简单查询和复杂查询维护不同的代码路径。
检索迭代如何计数
在逐一介绍新取值之前,先弄清迭代是如何计数的会很有帮助,因为正是这一点让行为可预测。
一次迭代等于一次 foundation model 调用。循环总是以一次答案生成调用结束。取值 n 最多换来 n 减 1 轮 agentic 规划,最后一次迭代留给生成响应。每轮规划是一次查询改写加一次检索。迭代越多,规划轮次越多,难题上的结果越好。迭代越少,延迟越低。
有一项不计入:speculative retrieval。在第一个规划步骤之前运行的初始检索是检索,不是迭代。它从不占用你的 maxAgentIteration 取值,只会让请求更快。阅读下面的取值时,请记住这一区别。
新增内容
取值范围现在是 0–5。
三种模式都支持多个知识库,maxAgentIteration=0 和 1 也不例外。single-shot 检索并不意味着只能用单个知识库。Agentic 模式增加的是查询分解、证据评估和迭代检索,而不是对多知识库的独占访问。
maxAgentIteration = 1:基础 RAG(主打用例)
这就是 single-shot RAG:一次检索,然后一个答案。没有 agentic 规划,没有查询改写。API 针对你的查询检索一次,并生成以这些段落为依据的响应。这正是此前无法通过这个 API 表达的检索一次,然后生成响应模式。
搭配 generateResponse=true,即可得到以检索到的段落为依据的生成答案。如果你只需要段落,请改用 maxAgentIteration=0,下一节会介绍。
如果你的大部分流量都是范围明确、直截了当的问题,这很可能就是你想要的默认设置。
maxAgentIteration = 0:仅段落,零 LLM 调用
这会执行一次保证发生的检索,不生成任何内容。不会调用 foundation model。它等价于直接调用 Retrieve API。因此,它对已经统一使用 AgenticRetrieveStream、宁愿改一个参数也不想换 API 的调用方最有用。
由于不调用 large language model(LLM),也就没有答案可生成。在这个取值下设置 generateResponse=true 是无效的,会返回 4xx 错误,因为生成答案需要一次 LLM 调用。
maxAgentIteration = 2 到 5:agentic 模式,保持不变
在 agentic 模式下,foundation model 把复杂问题拆成聚焦的子查询,分多步检索证据,包括跨多个知识库检索。它评估检索到的信息,并在证据缺失时细化检索。对于单次检索可能无法完全覆盖的多部分问题和比较类问题,这种方式可以提高检索准确性。
启用响应生成时,取值 n 允许最多 n 减 1 轮规划,然后生成以检索到的证据为依据的答案。使用 2–5 取值的现有请求保持当前行为不变。
如何选择取值
一种判断思路:
maxAgentIteration你会得到什么最适合 0一次检索,不生成,零 LLM 调用段落检索。已统一使用本 API、又想要 Retrieve 式行为的调用方 1一次检索加一个答案面向直接、范围明确问题的 single-shot RAG 2 到 5最多 n 减 1 轮规划,然后给出答案多部分、比较类、探索性以及跨知识库的问题
取值越低,调用越快、越可预测。取值越高,规划器在真正困难的问题上就越能分解和细化。简单流量从低值起步,当复杂查询的准确性比延迟更重要时再调高。
实战:内部银行政策助手
设想一家虚构的银行,其运营团队使用一个内部助手,背后是一个由开户流程、文件清单和政策指南构成的知识库。员工用这个助手查找并理解银行书面规定的各项要求。下面的示例说明应用如何为每个工作流选择检索模式。它们描述的不是客户部署,也不是实测结果。
下图展示了银行助手如何为每个请求选择检索模式。
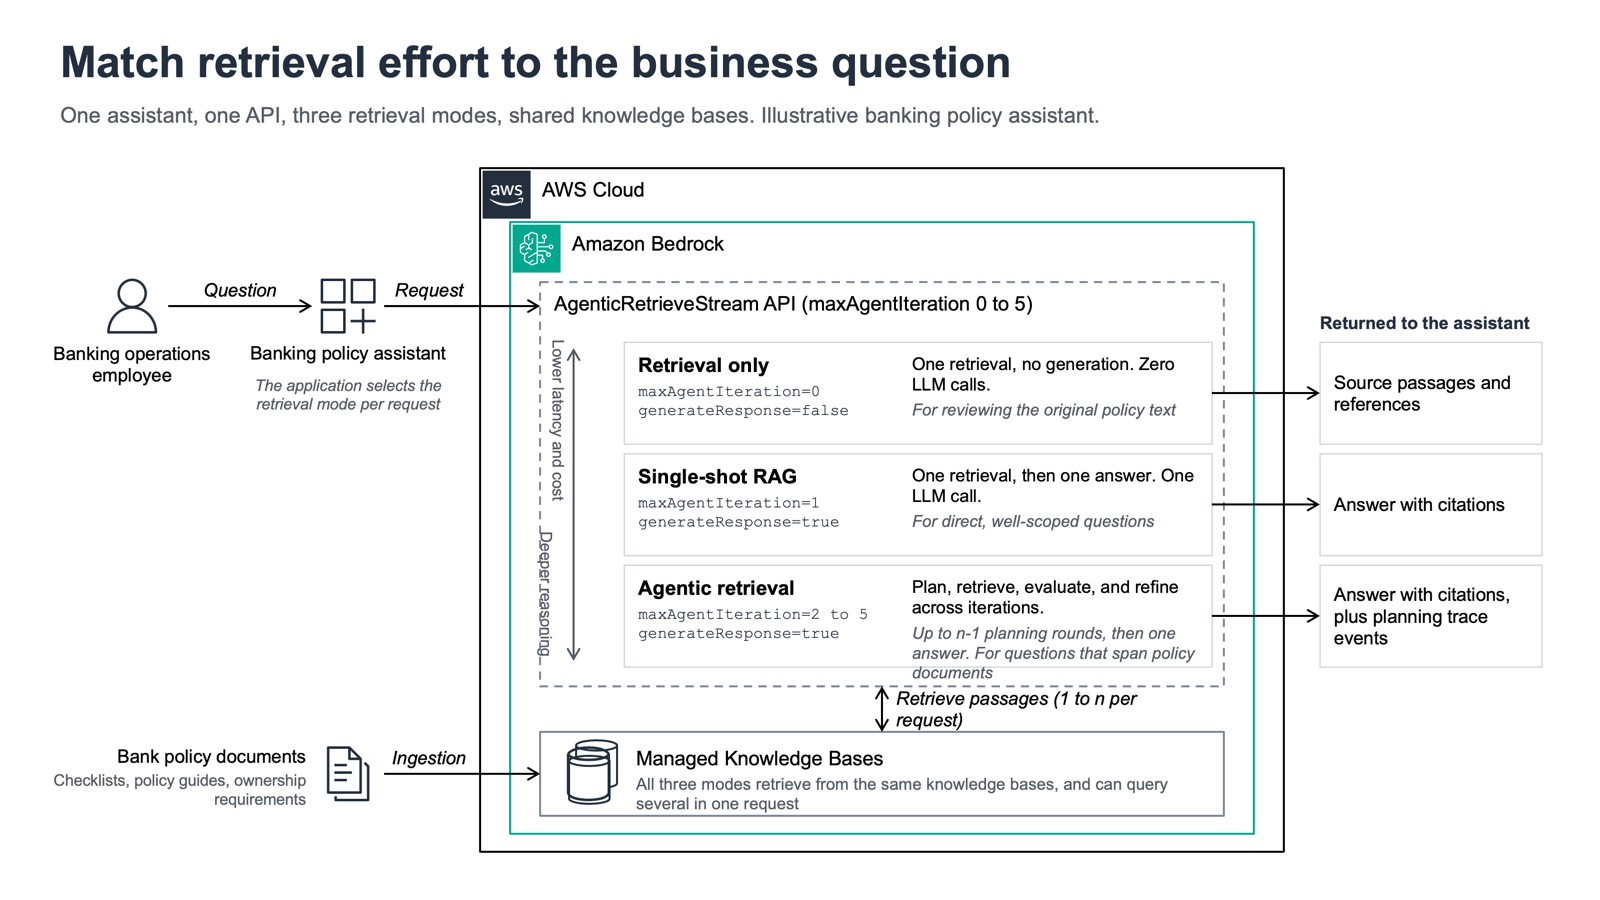
图 1:银行助手如何为每个请求选择检索模式
员工向助手提问。应用选择一种检索模式,把请求发给 AgenticRetrieveStream。使用 single-shot RAG 时,服务检索知识库一次并生成答案。使用 agentic retrieval 时,服务把问题拆成几部分,检索多次,然后生成带引用的答案。使用 retrieval-only 时,服务返回源段落,不生成答案。下面各节分别解释每种模式。
回答直接的文档问题
员工问:“为独资经营者开设企业支票账户需要哪些文件?”在这个示例中,银行维护着一份专门的清单,里面就有答案。应用设置 maxAgentIteration=1 和 generateResponse=true,检索相关段落并生成响应,不做查询改写,也不做 agentic 规划。
这就是 single-shot RAG 模式:一次检索,随后一次答案生成调用。当问题和支持内容本来就范围明确时,它省去了规划步骤。
跨政策文档比较要求
另一位员工问:“独资经营者和 LLC 的开户要求有何不同?按照我们的政策,对非居民所有者还有哪些额外审查(如果有的话)?”回答这个问题可能需要来自不同流程和所有权核验指南的信息。
对这个工作流,应用可以设置 maxAgentIteration=4 和 generateResponse=true,在生成答案前允许最多三轮规划。规划器可以把问题拆成子查询,检索相关证据,并在信息缺失时细化检索。合适的迭代上限应当用有代表性的问题来评估,而不是假定取值越高答案就一定越好。
展示源段落,不生成答案
正在审阅开户流程的员工,可能想要相关的政策原文,而不是生成的摘要。应用设置 maxAgentIteration=0 和 generateResponse=false,返回段落且不调用语言模型。然后它可以展示这些段落及其来源引用,供员工审阅。
三个工作流都使用 AgenticRetrieveStream。应用选择迭代上限,以及是否返回生成的答案。选择模式是应用逻辑,不是这个参数提供的自动路由。助手支持政策查询和比较,但它不批准账户,也不取代银行的审查与授权流程。
方案概览
下面的示例展示一个完整的 agentic 请求。其后各节把它改造成 single-shot RAG 和 retrieval-only 模式。
为银行助手选择检索模式
示例代码用虚构的政策文档演示这三个工作流。
{ "messages": [ { "content": { "text": "How do account-opening requirements differ for sole proprietors and LLCs, and what additional checks, if any, apply to nonresident owners under our policy?" }, "role": "user" } ], "retrievers": [ { "description": "Knowledge base of account-opening procedures, documentation checklists, and policy guides", "configuration": { "knowledgeBase": { "knowledgeBaseId": "KB12345678" } } } ], "generateResponse": true, "agenticRetrieveConfiguration": { "foundationModelType": "MANAGED", "rerankingModelType": "MANAGED", "maxAgentIteration": 4 } }
示例:Single-shot RAG
从 agentic 调用改成基础 RAG,只需改一行。把 maxAgentIteration 设为 1,并保持响应生成开启。
{ "messages": [ { "content": { "text": "What documents are required to open a business checking account for a sole proprietor?" }, "role": "user" } ], "retrievers": [ { "description": "Knowledge base of account-opening procedures, documentation checklists, and policy guides", "configuration": { "knowledgeBase": { "knowledgeBaseId": "KB12345678" } } } ], "generateResponse": true, "agenticRetrieveConfiguration": { "foundationModelType": "MANAGED", "rerankingModelType": "MANAGED", "maxAgentIteration": 1 } }
你消费流的方式一如既往。区别在于流里的内容:一次检索和一个有据可依的答案,中间没有规划 trace 事件。
示例:仅段落
要检索而不生成,把 maxAgentIteration 设为 0。在这个取值下,响应生成必须关闭。
{ "messages": [ { "content": { "text": "Show the policy text for the business account-opening procedure." }, "role": "user" } ], "retrievers": [ { "description": "Knowledge base of account-opening procedures, documentation checklists, and policy guides", "configuration": { "knowledgeBase": { "knowledgeBaseId": "KB12345678" } } } ], "generateResponse": false, "agenticRetrieveConfiguration": { "foundationModelType": "MANAGED", "rerankingModelType": "MANAGED", "maxAgentIteration": 0 } }
这会返回去重后的源段落,没有生成的答案。检索行为与直接调用 Retrieve 一致,但响应格式不同:段落在流的 result 事件中到达,不带 score 或 location 字段。
结论
借助 Amazon Bedrock Managed Knowledge Base,你现在可以通过 AgenticRetrieveStream 在一个助手里组合 single-shot RAG、agentic retrieval 和 retrieval-only 请求。在银行示例中,你可以用 maxAgentIteration=1 并启用响应生成来回答开户清单问题,无需规划调用就能产出答案。对于跨企业组织形式的比较,你可以设置 maxAgentIteration=4,允许在生成响应前进行额外检索。当员工需要阅读政策原文时,你可以设置 maxAgentIteration=0 并关闭响应生成,返回段落而不调用语言模型。由你的应用选择模式,员工继续使用同一个助手。
要在现有应用中采用这些新模式,先从你自己的文档中准备一组有代表性的问题和预期答案。在同一个知识库上,把 single-shot RAG 与你当前的 agentic 配置做比较。测量响应延迟和请求成本,检查答案是否正确、是否有检索到的段落支持。要纳入答案跨多份文档的问题,以及文档无法回答的问题,避免更快的响应掩盖了证据缺失或缺乏支持的结论。
用这些结果选出满足每个工作流质量要求的最低迭代上限。在额外检索能改善答案的地方保留 agentic retrieval,在一次检索就足够的地方使用 single-shot RAG,在任务是审阅源文本时关闭生成。取值为 2–5 的现有请求保持不变,因此你可以有选择地引入新模式,而不必重新设计整个应用。
要开始使用,请参照 AgenticRetrieveStream API 参考 在你的请求中配置 maxAgentIteration 和 generateResponse,然后针对你应用的问题和响应时间目标评估这些设置。要进一步了解该服务,请访问 Amazon Bedrock Managed Knowledge Base 服务页面。
关于作者