在线AI教程 / AI入门
[Amazon Bedrock] 在 Amazon Bedrock AgentCore runtime 上快速启动会话的架构模式
人工智能 在 Amazon Bedrock AgentCore runtime 上快速启动会话的架构模式 如今的 agent 会审查代码、处理理赔,还能无人值守连跑几个小时。不少
人工智能
在 Amazon Bedrock AgentCore runtime 上快速启动会话的架构模式
如今的 agent 会审查代码、处理理赔,还能无人值守连跑几个小时。不少 agent 还藏在交互式体验背后,让人等着第一个响应。Amazon Bedrock AgentCore runtime 为这些 agent 提供全托管的 serverless 环境:每个会话跑在自己隔离的 microVM 里,没活干时平台缩容到零,你只为会话实际消耗的资源付费。
把 platformVersion 设为 "V2" 后,AgentCore runtime 改变了会话的启动方式。它不再为每个会话初始化容器,而是把环境准备好一次、做一份快照,之后每个新会话都从这份快照恢复。会话启动更快,也更稳定。V2 还会回收会话没用上的内存,让账单跟着 agent 实际用量走。
对大多数 agent 来说,切到 V2 就够了。有些 agent 要重构才能吃满收益;而对聊天、语音体验来说,连 2 秒都嫌慢。本文讲清 V2 如何启动会话、怎么测量会话启动时间,以及怎么把工作从第一个请求上挪开——包括 AgentCore runtime 现已支持的构建钩子。我们覆盖四种模式,从改 agent 代码,到赶在用户需要之前就把会话启起来。
你需要哪种模式?
你的情况怎么做对应章节 新会话大约 2 秒启动可以接受切到 V2,并在 app.run() 之前完成全部初始化把工作挪离第一个请求 你的 agent 一上来就需要大文件、CLI 或浏览器,又没法把它们留在进程里加一个构建钩子,在构建快照时加载并预热它们使用钩子 你需要亚秒级,而且用户在发出首个请求之前就已进入(打开应用或聊天窗口)在用户进入时在后台启动会话用户进入时预热
V2 如何启动会话
AgentCore runtime 让每个会话跑在一个新的 microVM 里。在 V1 上,AgentCore 会先从 Amazon Elastic Container Registry (Amazon ECR) 拉取容器镜像、启动容器、跑完初始化代码,之后才能处理第一个请求。拉镜像占了大头,所以冷启动时间随镜像体积增长。
V2 把这套工作只做一次。创建或更新 runtime 时,AgentCore runtime 在一个全新的 microVM 里启动容器,等待第一个健康 ping(GET /ping),它必须在 120 秒内到达。随后平台清掉操作系统的文件缓存(好让快照小一些),冻结 microVM,把内存和磁盘存成一份快照。
与 V1 不同:现在每次创建或更新都要花几分钟,因为要构建快照。
本文里,init 指 agent 在 /ping 报健康之前做的所有事。用 AgentCore Python SDK 时,就是 app.run() 之前的全部内容。如果你自己跑 HTTP server(用 Node.js 或其他语言),要等初始化完成后才报健康。
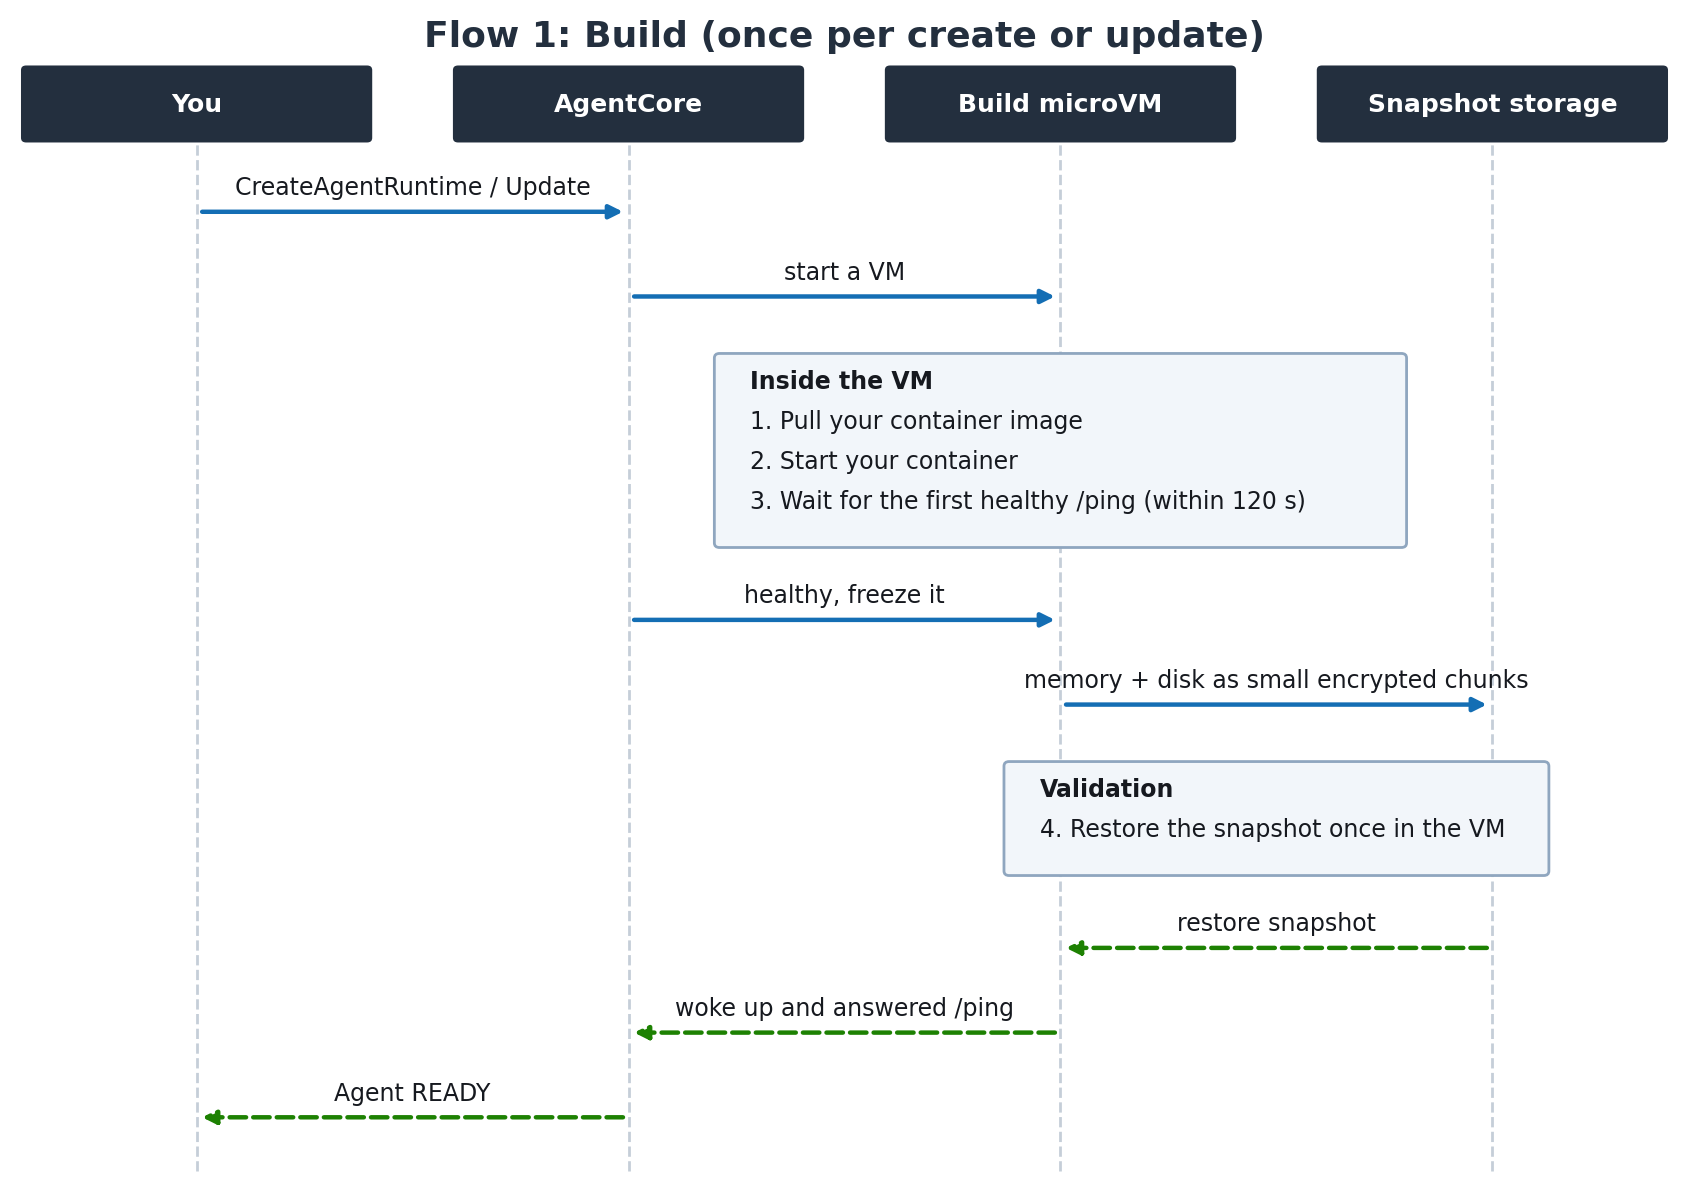
图 1:构建,每次创建或更新执行一次
新会话到来时,AgentCore 把快照恢复到新的 microVM 里。你的进程从被冻结的那一处精确续上,导入、对象、客户端都还在。镜像里的文件是懒加载的:某个数据块在会话第一次读到它时才去取。
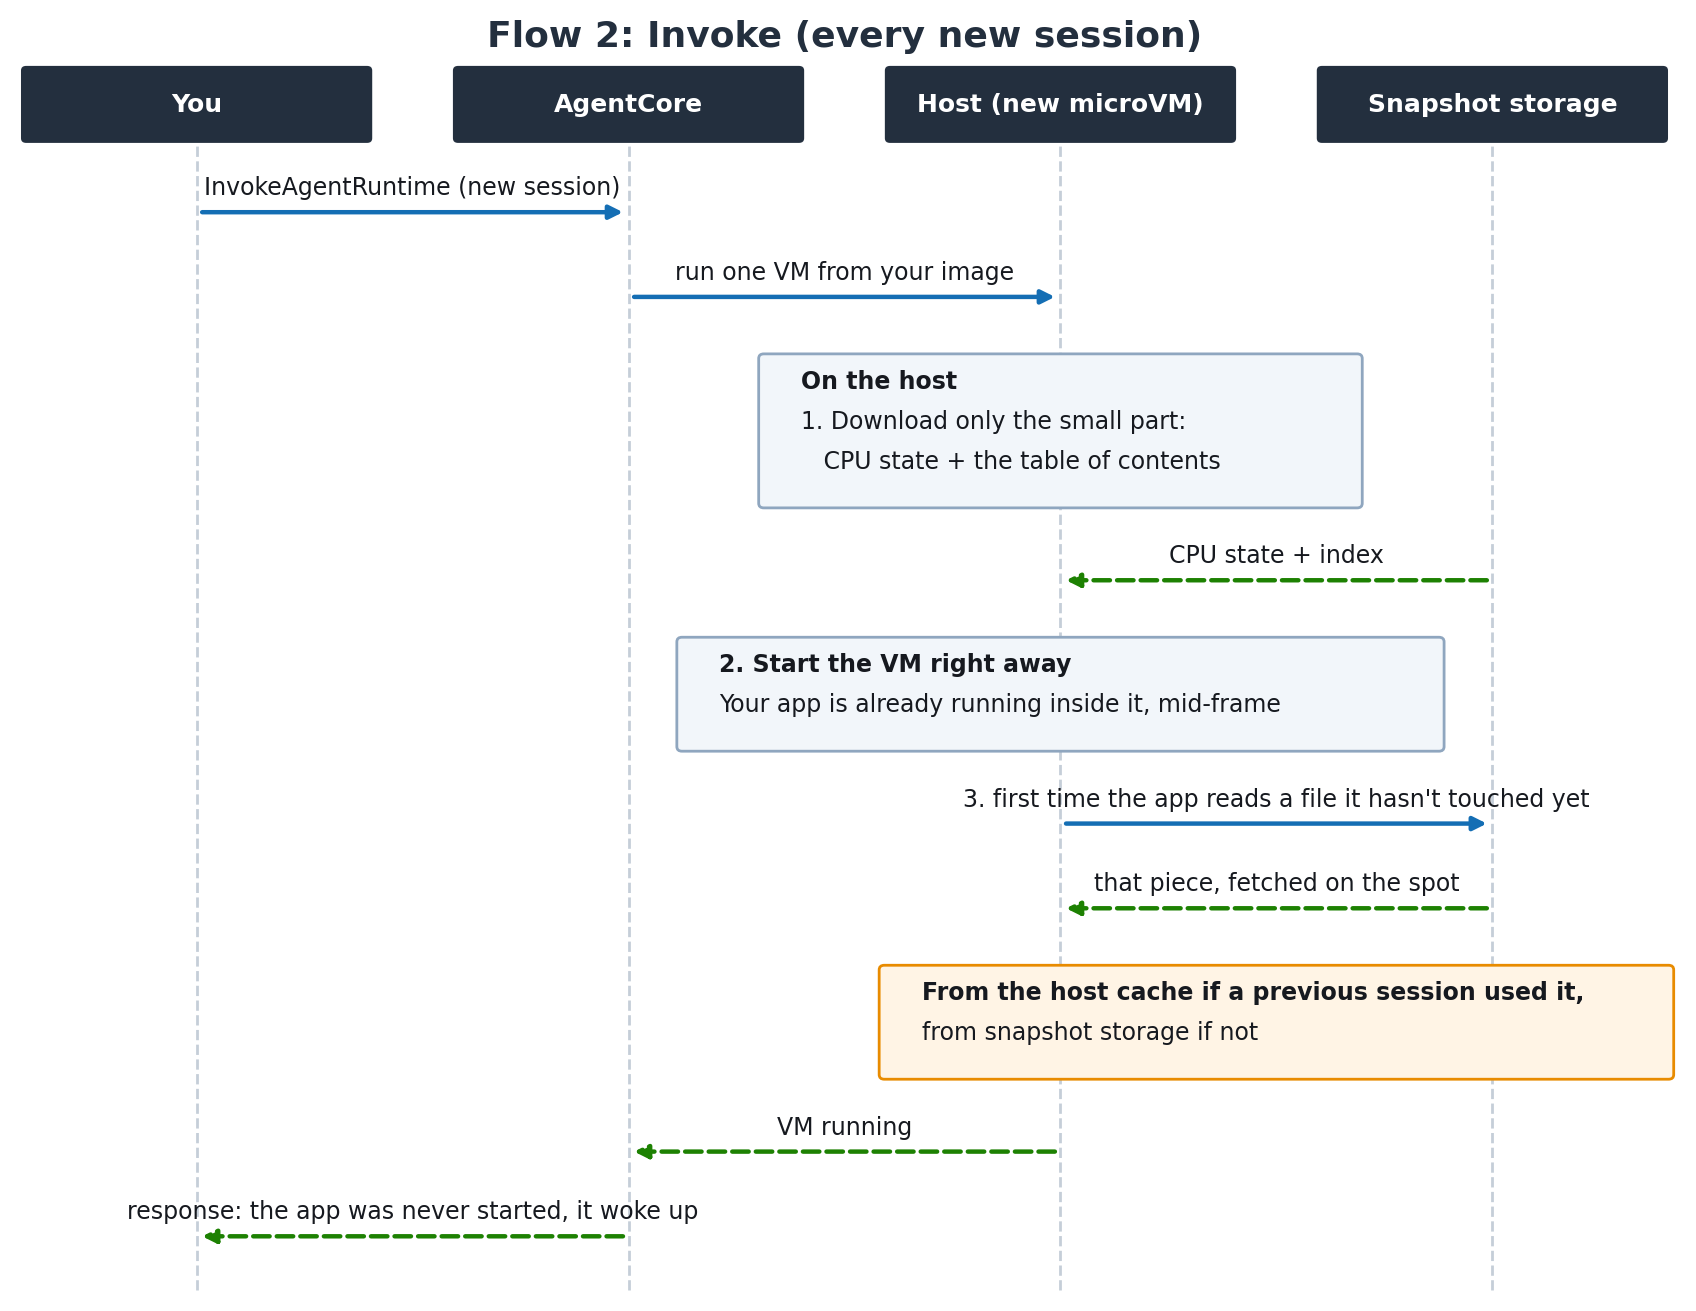
图 2:调用,每个新会话
从这两条流程能推出三个事实,本文余下内容都以此为基础:
内存原样恢复。 进程在快照那一刻持有的东西,以及 /dev/shm 这类 RAM 支撑的文件系统里的内容,从第一次访问起就以内存速度可用。 文件读取不会延续。 文件缓存在冻结前被清掉,所以 init 期间读某个文件,并不会让它在恢复后的会话里变快。 镜像文件在首次读取时获取。 某个数据块的第一次读取来自快照存储,之后才被缓存到更靠近主机的位置。
下表说明,对典型 agent 要做的各类工作,放在不同位置分别意味着什么:
工作在 init 期间完成在 handler 中完成 导入库会话启动时已在内存中每个新会话都从镜像读取 创建客户端(例如 boto3)随快照恢复,endpoint 与凭证解析已完成。套接字在首次使用时重连每个新会话从头构建 打开网络连接恢复后即失效。在快照前关闭它们重新打开 从镜像加载静态数据并保存在对象里会话启动时已在内存中每个新会话都从镜像读取 从镜像读文件但不保留数据无效,因为文件缓存被清空每个新会话都从镜像读取
如果你熟悉 AWS Lambda SnapStart,会觉得这套很眼熟。Marc Brooker 那篇讲 SnapStart 如何加载快照的文章,以及讲 SnapStart 预热策略的文章,都是不错的背景资料。
上表有个前提:agent 能把需要的东西都留在自己的进程里。这并不总能做到。作为独立进程运行、跑完就退出的 CLI,或者浏览器二进制文件,在 init 期间被读过之后就没了,恢复的会话只能再从镜像取一次。这类情况可以加一个构建钩子,「使用钩子」一节会讲。图 3 标出了它运行的位置。
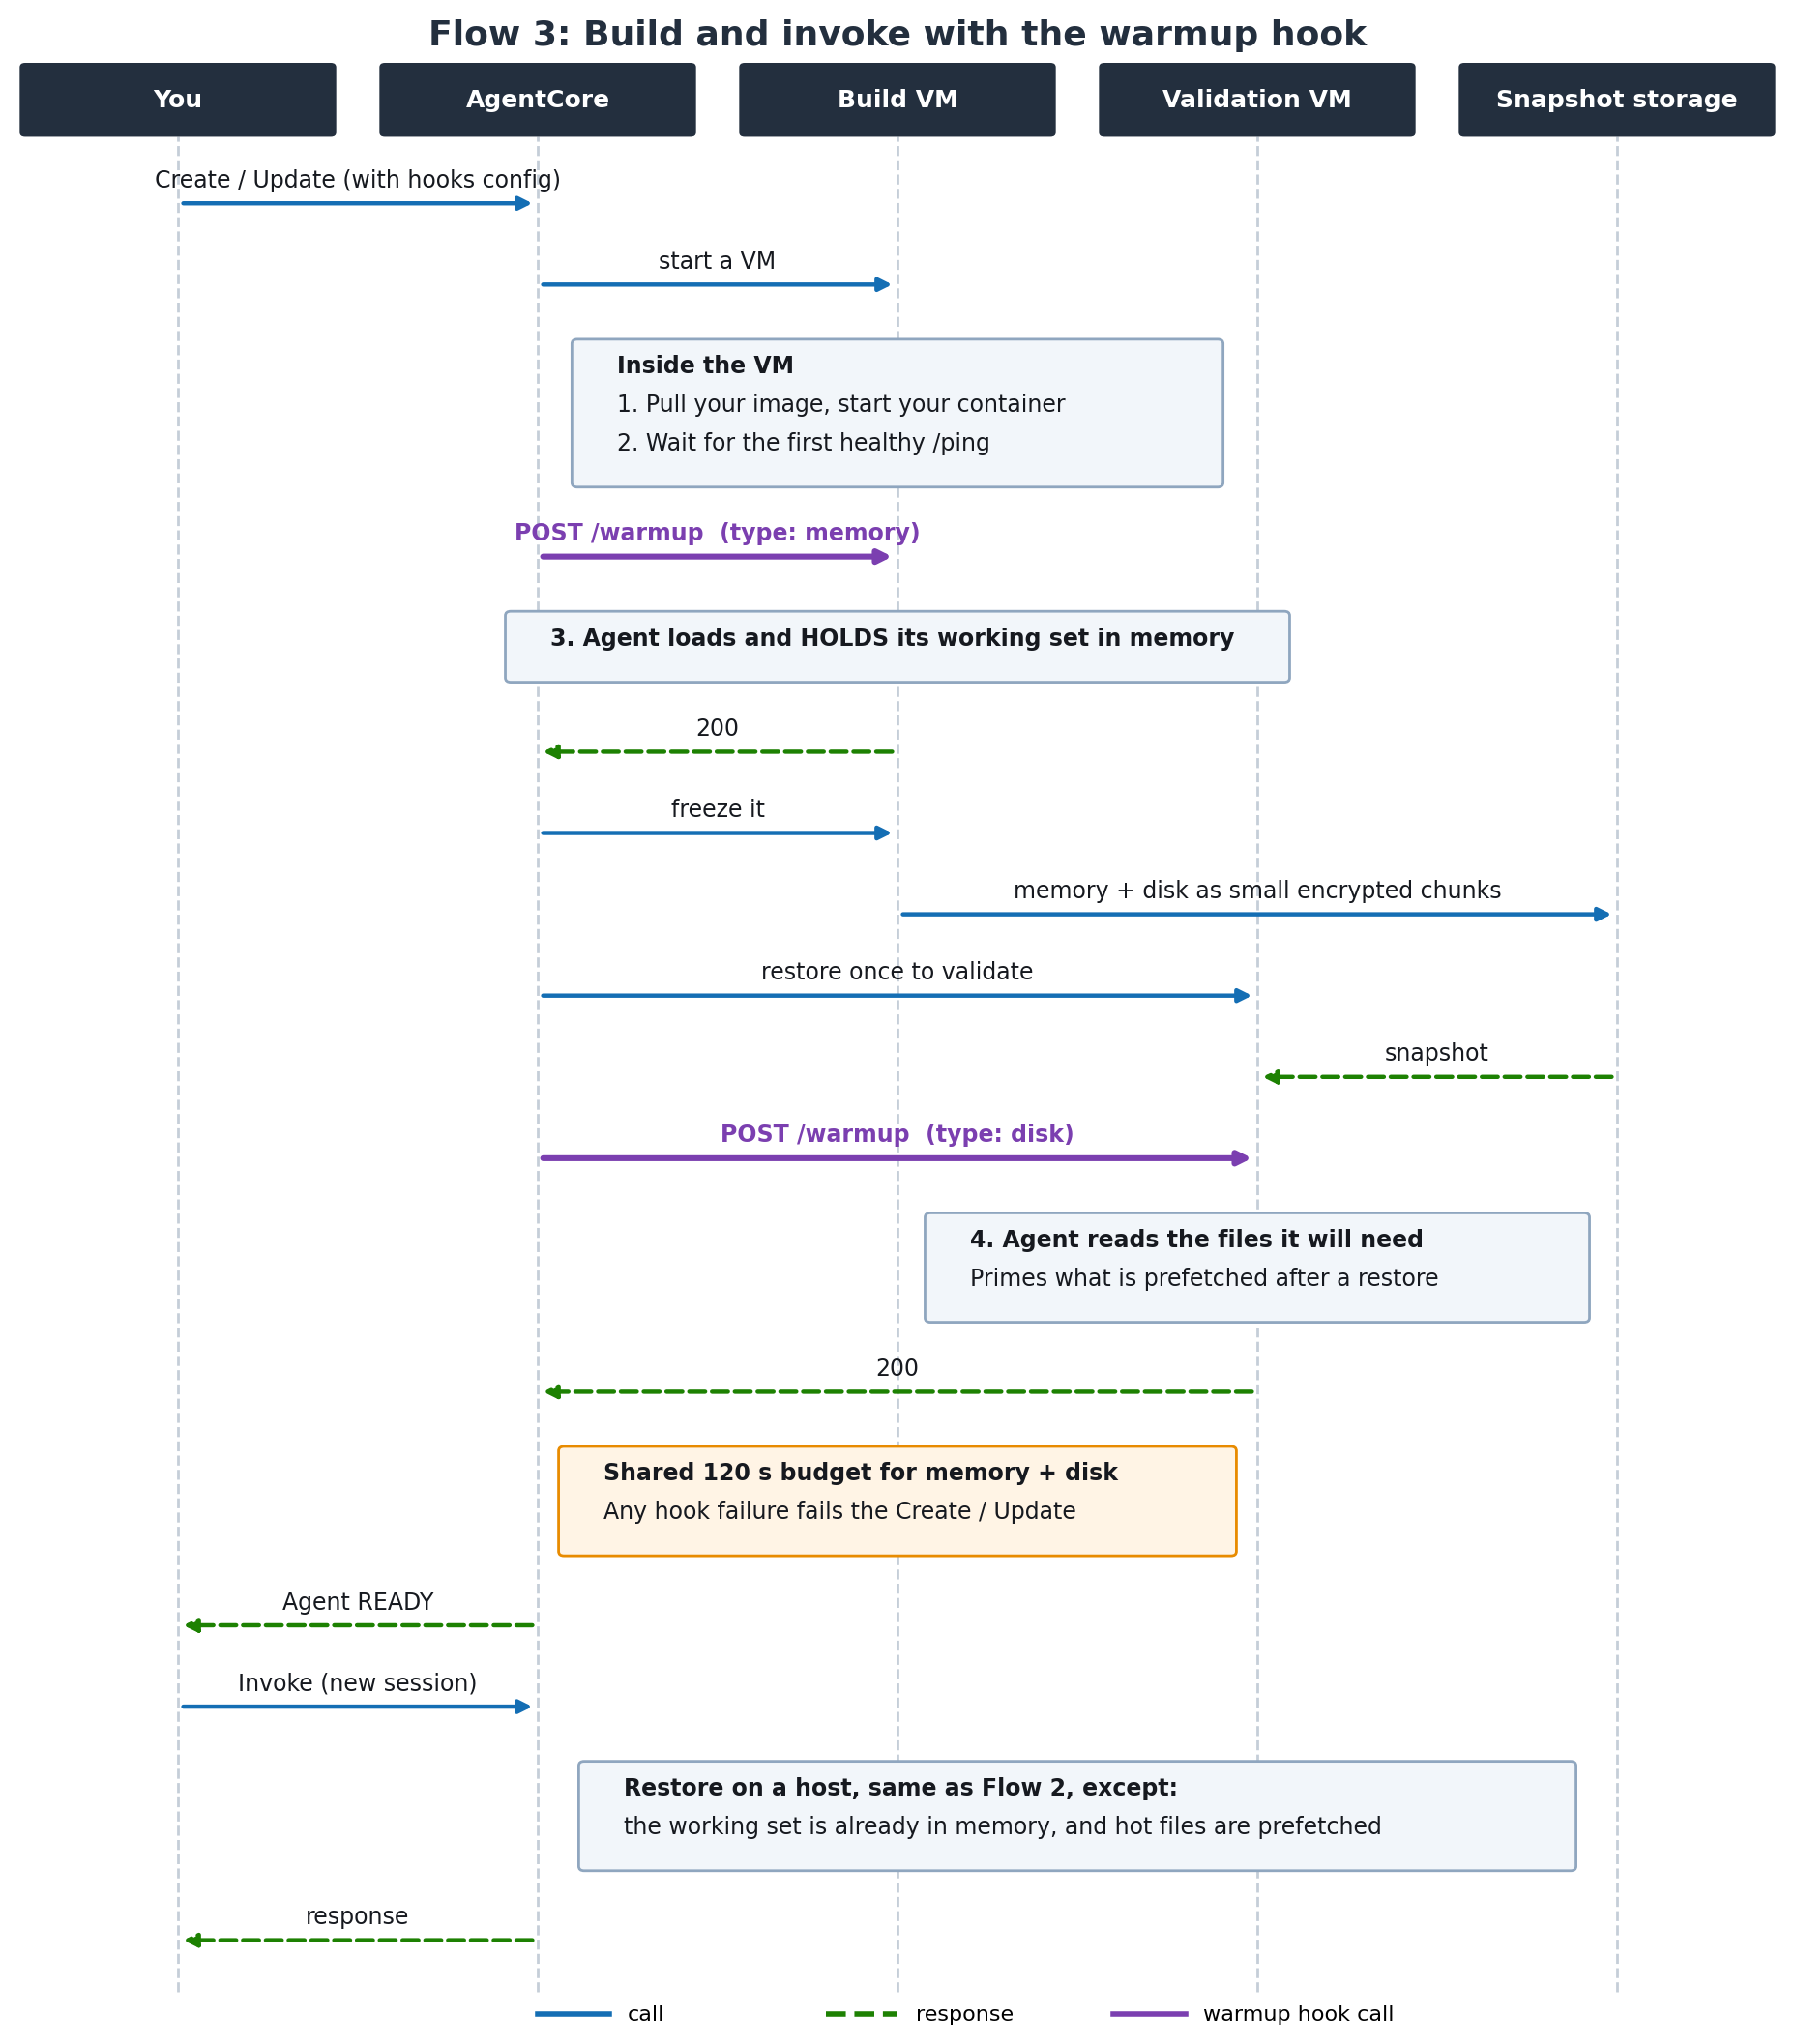
图 3:带钩子的构建与调用
优化之前先测量
agentic 应用里的延迟不是一个数字。一个请求的时间,一部分花在 AgentCore runtime 把会话准备好、好让你的代码跑起来,另一部分花在你的代码里:模型调用、工具调用、子 agent,以及把响应流式送回。这几处的修法各不相同,所以先弄清哪一块占大头。
AgentCore runtime 把这两部分都发成 AWS/Bedrock-AgentCore 命名空间下的 Amazon CloudWatch 指标。Latency 是首字节时间。OverheadLatency 是归平台的那部分,比如启动 microVM、在新会话上恢复快照。
你想得到的量怎么拿 TTFB(首字节时间)Latency Runtime 耗时OverheadLatency 你的代码耗时Latency − OverheadLatency Init 耗时在启动时由你的代码测量(见下面的示例)。在 V2 上它不属于任何请求
init 不会出现在这些指标里,因为在 V2 上它只在构建快照时跑一次,而不是每个会话都跑。它增加的是创建或更新到 READY 所需的时间,不是请求延迟。想知道它花多久,在 app.run() 前打一条日志即可。这一行会出现在 runtime 的构建日志里:
import time INIT_START = time.time() # first line of your module
imports, clients, data loading ...
print(f"init_ms={round((time.time() - INIT_START) * 1000)}") app.run()
怎么读这个拆分:
新会话上 OverheadLatency 偏高: 时间花在会话启动上。用本文后面的模式,赶在用户需要之前把会话启起来。 同一会话里,第一个请求的代码耗时远高于第二个: 本该放在 init 里的工作跑到了 handler 中。在 AgentCore Observability(Amazon Bedrock AgentCore 的一项能力)里,围绕工具装配、文件加载和延迟导入加上自定义 span 把它找出来,再挪进 init。
报百分位(比如 P90、P99),或修剪均值(比如 TM90,它对最快的 90% 请求取平均、丢掉最慢的尾部)。简单平均会把慢请求藏起来。OverheadLatency 同时覆盖对已在运行会话和新会话的请求,所以它的分布取决于有多少请求会启动新会话。比较时要选请求构成相近的几轮。
按生产环境预期的新会话速率来测,而不是部署后随手开几个会话测一测。
想把客户端那边的网络时间也算进去,就在客户端也测一次:给 invoke 调用计时,让 handler 返回它跑了多久,再相减。两个时间戳都来自同一台机器,所以客户端和 microVM 之间的时钟差不影响结果。如果用了流式,很小的事件可能被攒着,直到输出攒到几百字节才发,因此「到第一个事件的时间」读数可能比会话启动时间还高。
把工作挪离第一个请求
冷启动的老建议是延迟导入、把初始化做小。在 V2 上要反着来:init 只在构建快照时跑一次,而推给 handler 的工作,每个新会话都得付一遍。这针对的是静态工作:导入、客户端,以及镜像里的数据。动态数据没法进快照,下一节讲它。
感受最明显的 agent 是那些在请求时从镜像读大文件的:小型本地模型的权重、嵌入、数据集、大型库、用于自动化的浏览器二进制文件,或者编码 agent 当子进程跑的 CLI 工具链。读很多小文件也一样,比如编译 TypeScript 项目。而只导入几个库、调用托管模型的 agent,主要把导入和客户端弄对就行。
如何重构你的 agent
在 init 期间创建对象,而不只是导入。 创建对象会把它依赖的模块一并加载,并留在活动内存里。用到外部库的本地工具,也应在 init 期间初始化,别等 agent 第一次调用时才做。
在 init 期间创建客户端。 endpoint 解析、凭证解析和客户端的模块都会随快照回来。套接字不会,但 boto3 客户端在第一次调用时会干净地重连。另一些网络客户端会先去试那个已经失效的套接字,平白多出几百毫秒,所以要在快照前关掉它们的连接。
把静态数据留在内存里, 比如 prompt、skill front matter、配置和小索引。要把数据攥在对象里,而不只是读一遍:
INDEX = pathlib.Path("/opt/data/index.bin").read_bytes() # during init: keep the bytes
让工具常驻,而不是每个请求都启一次。 在 handler 里拉起的子进程,每个新会话都要从镜像重读它的二进制文件和库。而在 init 期间启动的常驻辅助进程(比如语言服务器,或者已经完成导入的工作进程)会作为进程内存的一部分一起恢复。用管道或套接字跟它通信。
把内存放不下的文件拷到 RAM 盘。 像 tsc 这类工具链是独立程序,会读自己的文件。init 期间把它们拷到 /dev/shm 或 ramfs 挂载点,读取就都来自内存了。
随包带上编译好的字节码。 uv pip install 默认不编译,所以延迟导入也得从源码编译。设 UV_COMPILE_BYTECODE=1,或者用 pip install --compile。
下面的示例在 init 期间就把 agent、它的模型和客户端都建好,这样每个会话都能继承:
import json, pathlib import boto3 import pandas as pd # import during init, including rarely used libraries from strands import Agent from strands.models import BedrockModel from bedrock_agentcore.runtime import BedrockAgentCoreApp
MODEL_ID = "us.anthropic.claude-haiku-5-5"
Init: runs once, before the snapshot. Every new session inherits these objects.
PROMPTS = json.loads(pathlib.Path("prompts.json").read_text()) ddb = boto3.client("dynamodb") agent = Agent(model=BedrockModel(model_id=MODEL_ID), system_prompt=PROMPTS["system"])
app = BedrockAgentCoreApp() .entrypoint def invoke(payload): return agent(payload["prompt"])
app.run() # /ping answers only after this line
权衡: 新会话的首字节时间,等于启动 microVM、恢复快照的时间,再加上 handler 的耗时。把工作挪进 init 会缩短 handler,但留在内存里的每样东西都会让快照变大,而且这份内存每个会话都要付费。改动前后都测一遍端到端的会话启动,才能确认你真的降低了延迟,而不只是把它从 handler 挪到了恢复阶段。
速查表
数据做法 第一个请求就要用的大文件,比如模型、CLI 或浏览器在 init 期间留在内存中,或用构建钩子预热它们 按需读取的大型参考数据在 init 期间通过接入点挂载 Amazon S3 Files 或 Amazon Elastic File System (Amazon EFS)(需要 virtual private cloud (VPC) 模式) agent 很少读的文件留在镜像里,或移到 Amazon Simple Storage Service (Amazon S3)、S3 Files 或 Amazon EFS 会话自己创建的文件无需改动
使用钩子
构建钩子是在 init 之上叠加,并不取代它。init 能做的都放 init,钩子只补 init 覆盖不到的部分。你在容器里暴露一个 HTTP endpoint,AgentCore runtime 在构建 runtime 时会向它发两次 POST 请求:
快照之前。 在构建用的 microVM 上,agent 报健康之后、冻结之前。agent 在这里加载并留在内存里的东西都会进快照,因此每个会话一启动就带着它。 测试恢复之后。 在另一个 microVM 上,它恢复快照做校验。这次调用里的内容不会被快照。用它去读会话将要用到的文件,从而决定恢复后的会话最先取哪些内容。
X-Amzn-Bedrock-AgentCore-Runtime-Warmup-Type 这个 header 告诉 agent 当前在处理哪次调用:第一次是 memory,第二次是 disk。两次调用共用 120 秒,所以 disk 能拿到的就是 memory 剩下的时间。只有工作做完了才返回 2xx。返回别的响应、连接失败或者超时,都会让创建或更新失败,而且 AgentCore runtime 不会重试。runtime 日志组里的 build-logs- 流会指出是哪次调用失败、为什么。
钩子在 V2 runtime 上可用。创建或更新 runtime 时用 hooksConfiguration 配置:
client = boto3.client("bedrock-agentcore-control") client.create_agent_runtime( agentRuntimeName="my_agent", agentRuntimeArtifact={"containerConfiguration": {"containerUri": IMAGE_URI}}, roleArn=ROLE_ARN, networkConfiguration={"networkMode": "PUBLIC"}, platformVersion="V2", hooksConfiguration={ "build": { "warmup": { "action": {"httpPost": {"path": "/warmup", "port": 8080}} } } }, )
端口可选,默认用 agent 的服务端口。要设的话,用 8000 到 12000 之间、平台没占用的端口。路径不能和 AgentCore runtime 在该端口上已用的路由撞上,比如 POST /invocations 或 GET /ping。UpdateAgentRuntime 会替换整份钩子配置,所以每次想保留钩子的更新都要带上 hooksConfiguration。
在 agent 里,用同一个 endpoint 处理两种调用:
import asyncio from fastapi import FastAPI, Request, Response
app = FastAPI()
Files that each session reads when it starts.
STARTUP_FILES = ["/app/models/tokenizer.json", "/app/config/agent.json"]
def load_shared_state():
Load what every session needs into memory, such as heavy imports,
model weights, and caches.
...
def read_startup_files():
Read the files that a session reads when it starts, so that new
sessions can use them faster.
for path in STARTUP_FILES: with open(path, "rb") as f: while f.read(1024 * 1024): pass .get("/ping") def ping(): return {"status": "Healthy"} .post("/warmup") async def warmup(request: Request):
Header lookup in Starlette and FastAPI is case-insensitive.
warmup_type = request.headers.get( "X-Amzn-Bedrock-AgentCore-Runtime-Warmup-Type", "" ).lower()
Run the work in a worker thread so that /ping keeps answering.
if warmup_type == "memory": await asyncio.to_thread(load_shared_state) elif warmup_type == "disk": await asyncio.to_thread(read_startup_files)
Respond only after the work is done.
return Response(status_code=200) .post("/invocations") async def invoke(request: Request): payload = await request.json()
Per-request work runs here on every session.
return {"response": payload.get("prompt", "")}
完整配置参考见为 AgentCore runtime 配置生命周期钩子。完整代码示例见示例代码。
快照的坑:哪些必须留在 handler 里
init 期间创建的一切都会冻进快照,直到下次部署为止;每个会话拿到的都是同一份副本。对大多数对象来说,这正是目的。但对下面这些值,它就是 bug;对随机值来说,更是安全问题。
动态数据放到 handler 里加载,每个会话一次。 来自 AgentCore Gateway(Amazon Bedrock AgentCore 的一项能力)的工具目录、feature flag 和价目表,部署之后还会变。把它们放在 handler 里加载、在模块级缓存,这样每个会话只取一次。会话最长能持续 8 小时,所以要给缓存加过期时间:
_tools, _loaded_at = None, 0.0
def get_tools(): global _tools, _loaded_at if _tools is None or time.time() - _loaded_at > 300: # wall clock: refresh after 5 minutes _tools, _loaded_at = load_gateway_tools(), time.time() return _tools
在 handler 里调用 get_tools(),把结果传给 init 期间创建的那个 agent。
每个会话独有的值,放到 handler 里创建。
值在哪里创建原因 随机值、nonce、机密、密钥在 handler 里,用 secrets、os.urandom() 或 uuid.uuid4()init 期间创建的库随机状态(Python 的 random、NumPy)在每个会话里都一模一样。来自操作系统的值才是唯一的 当前时间与经过时间在 handler 里,用 time.time()init 里的时间戳固定在了快照那一刻,而 time.monotonic() 不会把快照存放的那段时间算进去 计时器、限流器、TTL 缓存用挂钟时间,或在第一个请求时重置凡是用单调时钟计量经过时间的东西,恢复前后几乎看不到间隔 你自己去取的凭证和令牌过期时刷新init 期间加载的值,可能在会话启动前就过期了
记住这些限制。 会话在以下情况结束:空闲超时到期(idleRuntimeSessionTimeout:默认 15 分钟,可设 60 秒到 8 小时)、达到最大寿命(maxLifetime:默认且最多 8 小时),或者你主动停掉它。
亚秒级:在用户需要之前启动会话
假设新会话启动要花大约 2 秒,前面几节拆解的各项耗时都算在内。而一个已经在跑的会话,大约 200 ms 就能应答。对聊天或语音体验来说,做到亚秒级的办法,是确保会话在用户第一个请求到达之前就已经启动。有两种做法。
用户进入时预热
大多数交互式应用在第一个 prompt 之前就能收到信号:用户打开应用、聊天窗口或支持页面。用它。生成一个会话 ID,在后台给 agent 发一个预热请求,并把会话 ID 跟这次对话关联保存。等用户敲完第一条消息,会话已经在跑了。
Backend, when the user opens the chat (don't block the UI on it)
session_id = f"chat-{uuid.uuid4().hex}" # session IDs need at least 33 characters agentcore.invoke_agent_runtime(agentRuntimeArn=ARN, runtimeSessionId=session_id, payload=json.dumps({"action": "prime"}).encode()) save_conversation(user_id, session_id) # every later turn reuses this session ID
Agent handler: answer the warm-up before any model call .entrypoint
def invoke(payload): if payload.get("action") == "prime": return {"primed": True} return agent(payload["prompt"])
这个模式不需要额外基础设施;只要用户发出第一条消息前花了大约 2 秒以上,它就能把会话启动完全藏起来。代价是:每个进入却始终没发 prompt 的用户,会白占一个会话。把空闲超时设短一点,这份开销就很小。
结论
在 V2 上,AgentCore runtime 把启动会话的大部分工作挪到了部署阶段。容器只启动一次,之后每个新会话都恢复这份结果:内存原样回来,文件在首次读取时获取。
想把会话启动压在 2 秒左右,就在 init 期间做完静态工作,把第一个请求要用的数据留在内存里,把动态值和每个会话独有的值留在 handler 中。进程装不下的文件,加一个构建钩子。想压到一秒以内,就赶在用户需要之前启动会话:收到信号时,在用户进入那一刻就动手。
上手时,创建或更新 runtime 把 platformVersion 设为 V2,然后看针对 AgentCore runtime V2 优化你的 agent。工作负载方面的问题,可以联系你的 AWS 客户团队。
关于作者