在线AI教程 / AI上云
[Amazon Bedrock] 面向 Amazon ECS Fargate 上 AI agent 数据湖访问的 Serverless MCP 服务器
人工智能 面向 Amazon ECS Fargate 上 AI agent 数据湖访问的 Serverless MCP 服务器 构建人工智能(AI)驱动应用的企业常常面临一个反复出
人工智能
面向 Amazon ECS Fargate 上 AI agent 数据湖访问的 Serverless MCP 服务器
构建人工智能(AI)驱动应用的企业常常面临一个反复出现的挑战:如何让大型语言模型(LLM)agent 能够访问企业级数据湖,而无需在每个 agent 和应用之间重复编写集成逻辑。大多数团队在初期都是将 agent 直接与数据库和 API 连通,中间缺乏诸如 Model Context Protocol (MCP) 服务器这类的共享网关。每接入一个新数据集都需要定制开发代码,且每个 agent 都要自行重新实现权限控制。随着数据集或 agent 数量的增加,权限管控容易发生漂移,而接入一个新数据源往往演变成耗费数天的工程任务。
我们的团队负责支持 Amazon 北美分拣中心(North America Sort Center,NASC)网络,该业务的规划团队依赖运营数据来管理运力、人力配置和包裹流转。为了让这些团队能够通过自然语言对话访问相关数据,我们在 Amazon Elastic Container Service (Amazon ECS) 上基于 AWS Fargate 构建了一个 serverless Model Context Protocol (MCP) 服务器,以此解决 NASC 规划团队面临的这一痛点。该服务器充当了 AI agent 与企业数据湖之间集中化且独立于特定 agent 的通用网关。接入并公开一个新数据集仅需提供一个 JSON 元数据文件,服务器便会在下一次流水线同步时自动发现并加载该数据集。
在本文中,我们将详细介绍该系统的架构,演示元数据驱动方法如何消除针对每个数据集编写专属集成代码的需求,并阐述 serverless 基础设施如何在多租户环境中支撑多个 agent 与应用。
问题陈述与设计目标
两大相互关联的挑战决定了我们对该系统的设计思路:分散割裂的数据访问模式,以及不可持续的数据源接入流程。
大规模集成面临的挑战
我们的数据湖包含数千个数据集,涵盖运营指标、业务分析以及特定领域的数据。多个团队都希望拥有能够以对话方式查询这些数据的 AI 助手,但每个团队都在从零开始自行构建集成。每个 agent 内部都内嵌了各自的 SQL 生成逻辑、schema 信息与连接处理代码,因此一旦 schema 发生变更,就必须对每个 agent 逐一进行打补丁修复。权限控制处于碎片化状态,缺乏对数据访问决策的单一审计点。而接入一个新数据集则需要编写定制工具代码、进行查询验证并重新部署,每张表通常都需要耗费数天的人力。
设计目标
我们确立了四项核心要求:
配置驱动的数据湖访问:添加数据集仅需一份元数据文件,无需编写任何代码。 独立于特定 agent 的通用工具接口:任何兼容 MCP 的客户端均可调用相同的工具。 集中式权限管控:在 MCP 服务器层统一实施访问控制。 弹性基础设施:系统能够根据突发性 AI 工作负载模式自动伸缩。
解决方案概览
该架构将关注点划分为四个层级(客户端层、MCP 服务器层、工具层以及知识库刷新层),每一层均可独立伸缩和部署。元数据目录(metadata catalog)为工具层提供了坚实的基础,存储着 schema 描述、列级别语义以及表关联关系,AI agent 在生成 SQL 时会参考这些信息。由于 agent 是在查询执行时动态从目录中获取 schema 知识,因此完全无需硬编码表结构,在 schema 发生变更时也无需重新部署。知识库刷新层则负责保持该目录的时效性,在新的数据集元数据到达时即刻进行索引。接下来的章节将对各层进行详细阐述。
架构深度解析
下图展示了从用户查询到数据层跨越所有四个层级的请求流转全景。用户从客户端应用(Web 聊天、Slack、IDE 插件或外部 agent)提交查询。请求通过 Amazon Route 53 进行 DNS 解析,并到达位于公有子网中配置了 HTTPS 和 AWS WAF 的 Application Load Balancer。负载均衡器将请求路由至 Amazon Cognito,后者负责对用户进行身份认证并对请求进行丰富上下文补充。认证通过的流量随后进入私有子网,其中客户端层运行在 Amazon ECS Fargate 上。该层在 Amazon DynamoDB 中维护会话状态,并通过内部 Application Load Balancer 将请求转发至同样运行在 Amazon ECS Fargate 上的 MCP 服务器层。在 MCP 服务器层中,由 Amazon Bedrock 驱动的 AI agent 编排使用 FastMCP(一个用于构建 MCP 服务器的 Python 框架)构建的工具。Amazon Bedrock Guardrails 会应用于每一次模型交互。在图的右侧,数据层承载了工具的后端服务。Amazon Athena 和 Amazon Redshift 针对数据湖执行 SQL 查询,而作为全托管检索增强生成(RAG)功能的 Amazon Bedrock Knowledge Bases 则负责处理语义搜索。向 Amazon Simple Storage Service (Amazon S3) 和知识库的数据摄取工作则由 AWS Lambda 处理。以下各节将详细介绍每一个层级。
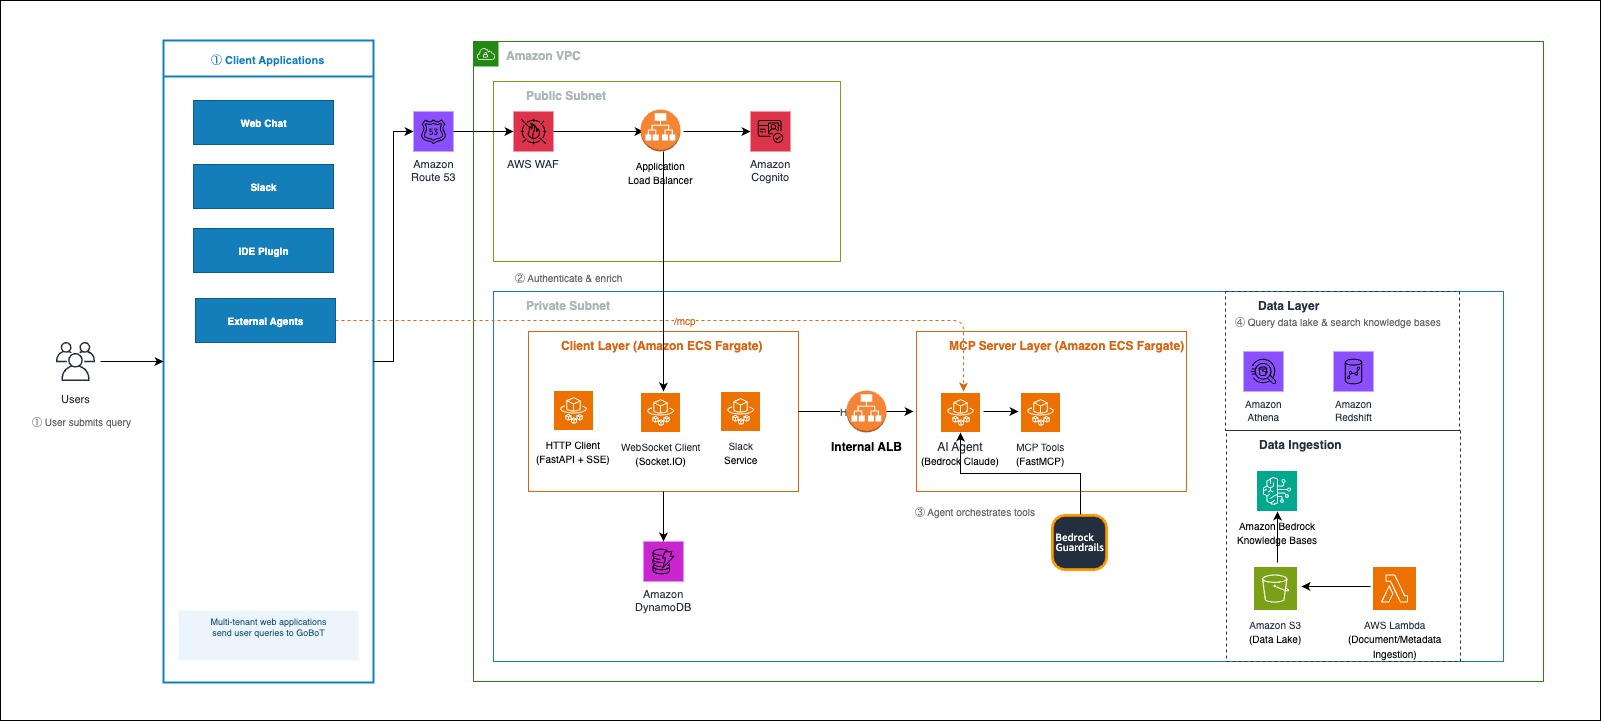
图 1:通过 serverless MCP 服务器从客户端应用到数据层的请求流转路径
MCP 客户端层:身份认证与会话管理
请求从客户端应用发出,经由 Amazon Route 53 进行 DNS 解析,到达配置了 HTTPS 和 AWS WAF 的 Application Load Balancer。负载均衡器将流量转发给 Amazon ECS Fargate 客户端服务,该服务集成了 Amazon Cognito 用于 JSON Web Token (JWT) 认证,并集成了 Amazon DynamoDB 用于会话存储。
上下文映射(context mapping)配置负责驱动上下文信息的丰富,将每次查询的作用域限定在仅相关的表范围内。在我们的测试中,这种限定作用域的机制将端到端交互延迟控制在了 15 到 20 秒之间。以下示例展示了一个上下文映射配置:
{ "package_data": { "description": "Package tracking and delivery information", "tables": ["analytics_db.regional_order_summary", "operations_gold.load_summary"], "sources": {"wiki": [], "quip": []} }, "labor_planning": { "description": "Workforce management and capacity planning", "tables": ["workforce.capacity_details"], "sources": {"wiki": [], "quip": []} } }
当上下文指定了具体表时,MCP 服务器会将针对元数据目录的搜索范围缩小至这些表中,从而减少干扰噪音并提升 SQL 生成的准确率。新增一个业务领域只需在该映射中添加一个配置项即可。
MCP 服务器层:带有会话状态的无状态执行
MCP 服务器运行在独立的 ECS Fargate 集群上,与客户端层相互隔离。请求通过 Amazon Route 53 和私有子网中的内部 Application Load Balancer 路由到该层。服务器负责全流程编排,包括查询分析、工具选择、执行以及响应生成。通过 MCP 协议端点(/mcp)——一个基于 FastMCP 的 JSON-RPC 接口,诸如 Amazon Q Developer 或 IDE 扩展等外部兼容 MCP 的客户端可以直接发现并调用各种工具。
Fargate 任务本身是无状态的,对话状态持久化存储在 DynamoDB 中,因此任务可以在无数据丢失风险的情况下随时被替换或扩缩容。当请求到达时,agent 会检索会话历史记录,使用 Amazon Bedrock 分析用户意图,发现并调用适当的工具,并将结果以流式传输反馈给用户。
工具层与元数据驱动的数据湖访问
每个工具均在 FastMCP 中注册,并可在运行时被动态发现:
序号工具后端用途 1SQL 查询工具Amazon Athena Amazon Redshift针对数据湖及 Redshift 中配置的任意数据集执行 SQL 查询 2文档与元数据搜索Amazon Bedrock Knowledge Bases对内部文档、表元数据和团队 wiki 进行语义搜索 3策略检索Amazon Bedrock Knowledge Bases检索运营策略和标准操作流程
Athena 查询工具是访问数据湖的主要接口。Agent 首先查询元数据目录以了解可用的 schema,通过 Amazon Bedrock 生成优化后的 SQL 查询,验证并自动纠错 SQL 以确保其与 Athena 兼容,随后执行该查询。查询结果流式返回给编排 agent,以进行自然语言综合组织。
负责任 AI(Responsible AI)控制措施
Amazon Bedrock Guardrails 应用于所有 LLM 交互,旨在过滤有害内容、执行事实依据(grounding)检查,并帮助阻止提示词注入(prompt injection)攻击。这些护栏作为生产级控制机制运行在 MCP 服务器层,因此无论通过何种方式接入,每一个连接的 agent 都能享受到完全相同的安全策略保障。Athena 查询工具严格强制仅执行 SELECT 查询,在工具层即拦截写操作,防止其触及数据湖。
知识库刷新层:仅凭单个 JSON 文件完成数据集接入
整个系统围绕配置驱动的可扩展性构建。添加新数据集仅需要一个描述该表的元数据 JSON 文件以及一个可选的上下文映射配置项。该文件记录了表的 schema、业务上下文以及列级别的语义信息。它是 AI agent 用于理解并查询该数据集的唯一事实来源:
{ "database_service_name": "athena", "database_name": "analytics_db", "table_name": "regional_order_summary", "business_description_for_the_table": "Regional order history with shipping status and delivery performance. Contains completed orders with delivery data. Refreshes daily. In Athena SQL, always use date() to wrap string literals when comparing against timestamp columns.", "column_details": { "order_id [varchar]": { "description": "Unique order identifier assigned at checkout.", "sample_values": ["ORD-20250115-001234", "ORD-20250116-005678"] }, "order_date [timestamp(3)]": { "description": "Date and time the order was placed. Use this column for time-range filtering.", "sample_values": ["2025-01-15 08:00:00.000", "2025-01-16 12:30:00.000"] }, "warehouse_id [varchar]": { "description": "Fulfillment center that processed the order.", "sample_values": ["FC-EAST-07", "FC-WEST-03", "FC-SOUTH-12"] } }, "load_type": "Incremental (refreshes last 7 days)", "refresh_frequency": "Daily at 6:00 AM UTC", "table_size": "~2.1B rows", "creation_time": "2024-03-15", "last_refresh_time": "2025-05-20T06:00:00Z" }
business_description_for_the_table 字段携带了特定引擎的查询提示(例如“在与时间戳列进行比较时,始终使用 date() 包裹字符串字面量”),从而减少 SQL 校验失败的情况。column_details 字段将每个 列名 [类型] 与自然语言描述及示例值进行配对,使 agent 同时具备 schema 感知能力与业务语义理解。sample_values 字段对于准确生成 WHERE 子句至关重要,因为 agent 可以据此学习真实的数据格式模式——例如获知 warehouse_id 存储的是像 FC-EAST-07 这样的代码,而非完整拼写的名称如“East region facility”。
处理流水线会自动获取元数据文件,通过 Amazon Titan Text Embeddings 生成向量嵌入,并将其建立索引存入 Amazon Bedrock Knowledge Bases。一旦完成索引,该表即可被所有连接的 agent 发现,无需手动重新索引或重启服务器。
为了提升特定应用的准确率,工程师可以选择将数据集与业务上下文进行关联。这能够缩小搜索范围,使 agent 优先选用正确的表。以下示例展示了一个上下文映射条目:
{ "delivery_metrics": { "description": "Delivery accuracy and defect attribution data", "tables": ["analytics_db.customer_orders_summary"], "sources": {"wiki": [], "quip": []} } }
如果未指定上下文,agent 将在所有已索引的表中进行全局搜索。上下文映射通过限制搜索空间来降低延迟并提升 SQL 准确率。这一范围限定是可选的,并且可以在不修改元数据文件本身的情况下随时添加。
综合应用:一次实际查询的执行流程
当用户询问“上个月我们金额最高的前 10 笔订单是什么?”时,客户端会通过业务上下文丰富请求以缩小检索范围。Agent 将问题转换为向量嵌入,在元数据目录中搜索匹配的 schema,并通过一次轻量级 LLM 调用选出最相关的表。
借助选定的 schema、列描述以及特定引擎的查询提示,agent 会生成如下 SQL 语句:
SELECT order_id, customer_id, total_amount, order_date FROM analytics_db.regional_order_summary WHERE order_date >= date_add('month', -1, current_date) ORDER BY total_amount DESC LIMIT 10
该 SQL 经过验证和引擎兼容性自动修正后,提交给 Amazon Athena 执行。Agent 将执行结果格式化为自然语言回复,并以流式方式返回给用户。在我们的测试中,这一端到端流程在 15 到 20 秒内即可完成。
同样的编排机制并不局限于纯 SQL 查询。由于文档搜索作为另一个工具注册在同一台服务器上,agent 可以在单轮对话中回答跨越结构化与非结构化数据源的复杂问题,例如“我们第四季度的退货率是多少,产品团队的分析报告指出的根本原因又是什么?”针对该请求,agent 会运行 Athena 查询以获取退货率数据,同时通过 Knowledge Bases 进行文档搜索以提取分析结论,随后将两部分内容整合为单一答复返回。
安全性与多租户访问
这种单轮对话的多源编排之所以能够平稳运行,正是因为每一次工具调用都要经过同一个受控网关。该架构采用了分层安全防护,而非依赖单一控制点。MCP 服务器运行在内部 Application Load Balancer 背后的私有子网中,无法从互联网直接访问。只有位于带有 AWS WAF 的公网 Application Load Balancer 背后的客户端层才能向其路由请求。Amazon Cognito 在客户端层验证用户身份,只有经过身份验证且携带合法 token 的请求才会被转发至下游。在工具层面上,Athena 查询工具严格执行只读的 SELECT 语句,在写操作触及数据湖之前就予以拦截拒绝。所有工具调用都会以结构化 JSON 的形式记录到 Amazon CloudWatch 中,这为安全团队提供了跨所有 agent 与应用的数据访问单一审计点。该架构适用于所有提供 Amazon Bedrock 和 Amazon Bedrock Knowledge Bases 的 AWS 区域。
这种集中式设计也是服务器实现多租户能力的基础。由于标准化的 /mcp 端点支持任意兼容 MCP 的客户端接入——无论其使用何种 LLM 或编排框架——多个 agent 可以共享同一套工具和相同的访问控制策略。接入新的 agent 只需将其指向该服务器端点即可,因此在为新团队提供接入支持时,系统得以平滑扩展,而绝不会削弱或重复构建安全模型。
Serverless 基础设施与弹性伸缩
每一层均通过契合其工作负载特性的机制进行伸缩:
层级伸缩机制触发条件 客户端层(ECS Fargate)ECS Service Auto ScalingCPU 利用率(50% 阈值) MCP 服务器层(ECS Fargate)ECS Service Auto ScalingCPU / 内存利用率 AthenaServerless(全自动)查询并发数 Amazon Bedrock托管服务自动扩缩推理请求量
Amazon ECS Fargate 提供了 serverless 计算能力,无需管理任何 EC2 实例。下游服务(Athena、Bedrock)具备全自动伸缩能力,因此系统无需修改任何配置即可自如应对单次查询或数百个并发查询。
应用场景与拓展
除基础问答之外,该架构还支持多种高级应用模式。企业知识助手可以将数据湖查询与文档搜索相结合,解答跨越结构化数据与非结构化知识的复杂问题,例如“我们第四季度的退货率是多少,产品团队的分析报告指出的根本原因又是什么?”内部分析副驾驶(copilot)使业务人员能够通过对话方式查询数据湖而无需编写 SQL,依靠元数据描述和查询提示引导 agent 采用准确且高效的查询模式。
标准化的 /mcp 端点同样支持多 agent 工作流。分别负责数据分析、文档检索和运营告警的多个专用 agent 可以共享同一个 MCP 服务器,各自通过通用协议访问完整的工具套件。接入新团队的数据同样遵循这种配置驱动的模式:他们只需添加一个元数据 JSON 文件,在一个流水线同步周期内,其数据集便可被所有已连接的 agent 和应用发现并使用。
结语
基于 Amazon ECS Fargate 构建的集中式 MCP 服务器,为 AI agent 与企业数据湖之间提供了可扩展、安全可靠的通用网关。元数据驱动的方法消除了针对每个数据集编写专属集成代码的繁琐工作,而 Model Context Protocol 标准则意味着任何兼容 MCP 的客户端均可在无需定制适配器的情况下无缝接入。
核心的架构决策在于将工具层与 agent 层进行彻底解耦。Agent 技术日新月异,但数据访问模式的生命周期理应超越任何单一的 agent 实现。将可扩展性视为配置问题而非编码问题,能够大幅加快数据接入速度。
欲了解更多信息,请参阅 Amazon ECS on AWS Fargate、Amazon Bedrock、Amazon Bedrock Knowledge Bases 用户指南、Amazon Athena 以及 Model Context Protocol 规范。
下一步工作
我们正沿着两个方向对该架构进行拓展。首先,实现更细粒度的访问控制:表所有者可以按权限组将敏感列标记为受限,agent 会在生成的 SQL 中自动排除这些列,而无需在提示词层面进行任何改动。
其次,形成反馈闭环:当查询失败或返回低置信度结果时,系统能够捕获失败模式,并给出针对性的优化建议,以改进列描述或补充查询提示。
关于作者