在线AI教程 / AI上云
[OpenRouter] LLM API 速率限制:如何修复 OpenAI 和 Claude 的 429 错误
LLM API 速率限制:如何修复 OpenAI 和 Claude 的 429 错误 OpenRouter ·11/11/2026 429 Too Many Requests 错误
LLM API 速率限制:如何修复 OpenAI 和 Claude 的 429 错误
OpenRouter ·11/11/2026
429 Too Many Requests 错误表示你在当前时间窗口内发送的请求数或 token 数超出了限额。OpenAI、Anthropic 和 OpenRouter 都会返回它,而且通常是在应用第一次承受真实负载、或批处理作业分散到多个 worker 上时首次出现。
大多数人第一反应是重试,但在默认设置下这往往不够。我们用 OpenAI Python SDK 对着每分钟限额跑了一批 60 个 prompt 的任务,SDK 重试之后仍有 23 个请求失败。每次 SDK 放弃后的 4 到 8 秒,窗口才重置。
本指南从一个真实的 429 出发,读取它的响应头,再用三种办法修复:按错误给出的重置时间重试、把溢出的请求转给后备模型、让另一个 provider 来提供同一个模型。每个例子我们都对着 OpenRouter API 跑过,每个代码块下面的输出就是我们实际拿到的结果。
Tl;dr
429 表示你在当前窗口里撞上了限额。在 OpenRouter 上,error.metadata.limit_source 会告诉你是谁的限额。 按默认设置,OpenAI Python SDK 对每个 429 重试两次,约 2 秒内就放弃。对着每分钟限额,我们这批 60 个请求里仍有 23 个失败。 等待 Retry-After 或 X-RateLimit-Reset 再重试的做法,每次运行都跑完了全部 60 个,在 Python 里耗时 89 到 92 秒,在 TypeScript 里是 106 到 218 秒。 用 models 做后备,13 秒内跑完 60 个,花费 $0.000066,完全不用等待。 固定到单一 provider 且关闭故障转移时,每轮 150 个请求里最多有 32 个失败;开启故障转移后,每轮 150 个全部成功。
429 速率限制错误长什么样?
我们一次性向 poolside/laguna-s-2.1:free 发了 40 个请求,这是一个每分钟限 20 个请求的免费模型。38 个成功,2 个由提供该模型的 provider 返回 429:
200: 38 429: 2 other: 0 429 limit_source: {'upstream_provider_shared_pool': 2}
来自我们免费层限额的 429,limit_source 不一样。下面是另一次运行里的一条:
{ "message": "Rate limit exceeded: free-models-per-min. ", "code": 429, "metadata": { "headers": { "X-RateLimit-Limit": "20", "X-RateLimit-Remaining": "0", "X-RateLimit-Reset": "1792448640000" }, "limit_source": "openrouter_free_tier_per_minute", "remedy_hint": "Slow down requests to free models, or retry after the per-minute window resets.", "provider_name": null } }
响应头里带着你需要的数字。X-RateLimit-Limit 是上限,X-RateLimit-Remaining 是剩余量,X-RateLimit-Reset 是重试最早能成功的时间,以毫秒为单位的 Unix 时间戳给出。响应体还加了 limit_source,说明你撞上的是谁的限额,以及一条面向看日志的人写的 remedy_hint。代码里要按 limit_source 分支,别按提示文字分支。
OpenAI 和 Anthropic 用不同的名字送同样的信息。OpenAI 的 x-ratelimit-reset-requests 是一段时长,比如 1s;两家 provider 也都可以用 retry-after 给出秒数。
为什么速率限制会在不同的请求数上触发?
40 个请求里有 38 个通过了 20 的限额。限流器可能在计数跟上之前就把同一瞬间到达的请求收下,而且多数限流器并不会在每分钟整点干净地重置。Anthropic 用的是持续补充的 token 桶。当流量爬升太快时,即便你还没到每分钟限额,OpenAI 也会返回 429,代码是 slow_down。
为了看清免费模型限额是怎么计数的,我们又按不同模式发了 161 个请求。下面是其中三种:
测试该分钟内成功的请求数 空闲两分钟后,顺序发送30 紧接着的下一分钟,顺序发送30 30 个并发29
这里看出两件事。我们测的每一分钟里都有超过 20 个请求成功,所以该把 20 当成 429 开始出现的临界点,而不是一个精确数字。当我们在窗口还剩 58 秒时于 poolside/laguna-s-2.1:free 上撞到限额,发往 minimax/minimax-m3.1-flash:free 的五个请求立刻就通过了,而 Laguna 仍被挡着。不过这并不说明限额是按模型算的。OpenRouter 对一个账户下所有免费模型只用一个每分钟限流器,所以请求另一个免费模型也可能拿到同样的 429。
第 1 步:读懂你撞上的是谁的限额
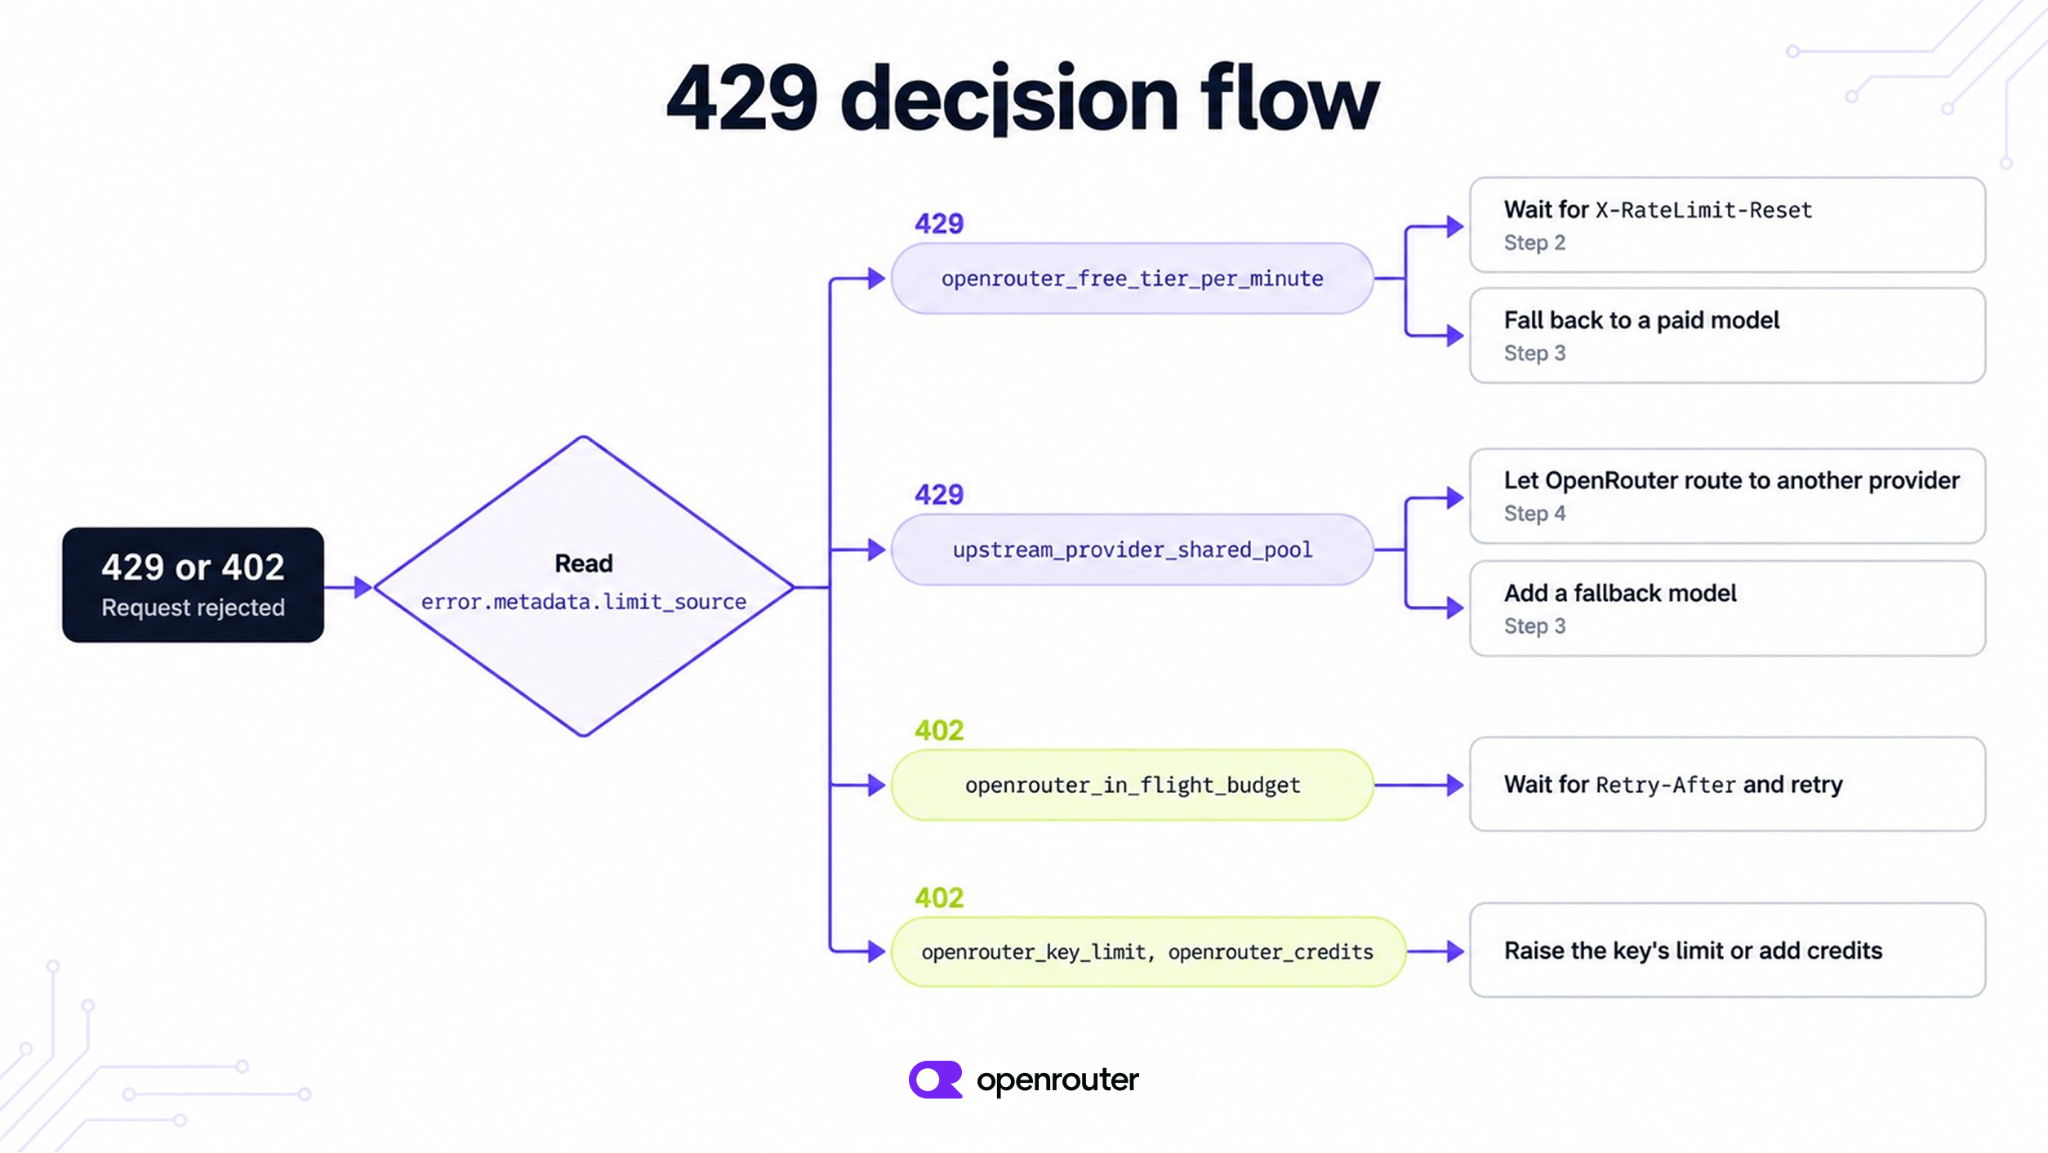
只有限额按固定节奏重置时,等待才能修复 429,所以选办法之前先看 limit_source:
limit_source状态谁的限额怎么解决 openrouter_free_tier_per_minute429我们的免费模型上限等待 X-RateLimit-Reset(第 2 步),或回退到付费模型(第 3 步) upstream_provider_shared_pool429提供该模型的 provider换一个 provider(第 4 步),或用后备模型(第 3 步) openrouter_in_flight_budget402你在途消费预算等待 Retry-After 后重试 openrouter_key_limit, openrouter_credits402你 key 的额度上限或余额提高 key 的限额或充值
上游 429 表示提供该模型的 provider 已经没有余量。provider 不会说明余量何时释放,所以在我们的运行里这类错误都不带重置响应头。Gemma 4 31B 的免费版本返回的是:
google/gemma-4-31b-it:free is temporarily rate-limited upstream. Please retry shortly, or add your own key to accumulate your rate limits.
把付费版本设为后备后,同样的请求用了另一家 provider 的余量,在 DeepInfra 上以 $0.0000037 成功。
有些看起来像速率限制的错误其实跟钱有关。达到每月消费上限时,OpenAI 和 Anthropic 都会返回 429,在上限重置之前重试也没用。在 OpenRouter 上,额度问题则是返回 402。
第 2 步:在错误给出的重置时间重试
OpenAI 和 Anthropic 的 Python SDK 默认对 429 重试两次,退避很短,从 0.5 秒起步,最多不超过 8 秒。服务端若发了 Retry-After 响应头,它们会照着做。
我们免费层的 429 发的是 X-RateLimit-Reset,SDK 不读这个,所以两次重试都落在同一个已经占满的分钟里。下面是用默认设置的 OpenAI SDK (openai 3.26.1) 跑的一批 60 个 prompt、每次 10 个:
openai 3.26.1 | max_retries default: 2 finished in 12s (HTTP requests sent: 112) succeeded: 37 RateLimitError after retries: 23 slowest failure gave up after 2.3s message: Rate limit exceeded: free-models-per-min. | limit_source: openrouter_free_tier_per_minute limit_source=openrouter_free_tier_per_minute x-ratelimit-reset: 1792444980000 retry-after: None window reset 8s after the SDK gave up limit_source=openrouter_free_tier_per_minute x-ratelimit-reset: 1792444980000 retry-after: None window reset 7s after the SDK gave up ... limit_source=openrouter_free_tier_per_minute x-ratelimit-reset: 1792444980000 retry-after: None window reset 4s after the SDK gave up
60 个 prompt,SDK 发出了 112 个 HTTP 请求,仍有 23 个失败。调高 max_retries 最终也能跑完,但只能靠每 8 秒往已经占满的窗口里塞一个请求,而且 OpenAI 的文档指出,失败的请求仍然计入每分钟限额。更好的重试是等到服务端给出的时间点。要跑完全部 60 个 prompt,得用当天至少还剩 60 次免费模型请求的账户,因为没买够 10 credits 的账户每天只有 50 次:
import email.utils import os import random import time from concurrent.futures import ThreadPoolExecutor
import requests
URL = "https://openrouter.ai/api/v1/chat/completions" HEADERS = {"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"}
def retry_delay(headers, attempt): """Seconds to wait after a 429: Retry-After, then X-RateLimit-Reset, then backoff.""" retry_after = headers.get("Retry-After") if retry_after: if retry_after.replace(".", "", 1).isdigit(): return float(retry_after) when = email.utils.parsedate_to_datetime(retry_after).timestamp() return max(0.0, when - time.time()) reset = headers.get("X-RateLimit-Reset") # Unix time in milliseconds if reset:
Spread clients over a few seconds after the reset, so they don't all retry at once.
return max(0.0, int(reset) / 1000 - time.time()) + random.uniform(1, 5) return min(2 * attempt, 60) random.uniform(0.5, 1) # exponential backoff with jitter
def chat(body, max_attempts=6): for attempt in range(max_attempts): r = requests.post(URL, headers=HEADERS, json=body, timeout=120) source = None if r.status_code in (402, 429): source = r.json()["error"].get("metadata", {}).get("limit_source") if source == "openrouter_free_tier_daily": # resets at UTC midnight, so don't sleep until then r.raise_for_status()
A 402 from the in-flight budget clears after Retry-After; other 402s need credits.
if r.status_code != 429 and source != "openrouter_in_flight_budget": r.raise_for_status() return r.json() if attempt == max_attempts - 1: break # out of attempts, so don't wait before failing wait = retry_delay(r.headers, attempt) print(f"{r.status_code} ({source}), attempt {attempt + 1}: waiting {wait:.1f}s") time.sleep(wait) r.raise_for_status()
if __name__ == "__main__": def job(i): return chat({ "model": "poolside/laguna-s-2.1:free", "messages": [{"role": "user", "content": f"Reply with the number {i}."}], "max_tokens": 16, })
t0 = time.time() with ThreadPoolExecutor(max_workers=10) as pool: # the same batch job: 60 prompts, 10 at a time results = list(pool.map(job, range(60))) print(f"{len(results)} of 60 completed in {time.time() - t0:.0f}s")
429 (openrouter_free_tier_per_minute), attempt 1: waiting 19.3s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 19.1s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 18.8s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 17.2s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 19.7s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 15.6s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 14.8s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 16.4s 429 (openrouter_free_tier_per_minute), attempt 2: waiting 61.7s 429 (openrouter_free_tier_per_minute), attempt 2: waiting 58.9s 429 (openrouter_free_tier_per_minute), attempt 2: waiting 60.1s 429 (openrouter_free_tier_per_minute), attempt 2: waiting 57.8s 60 of 60 completed in 89s
60 个请求全部完成,但这批任务花了 89 秒,而不是 12 秒。用这个办法不会失败,每个撞上限额的请求都会等过整个窗口。
retry_delay 先查 Retry-After,因为那是服务端的直接指令,而 X-RateLimit-Reset 只标记窗口何时翻篇。随机 1 到 5 秒能避免 10 个 worker 在同一瞬间一起重试、把新窗口立刻填满。
即便如此,这次运行里还是有四个请求在新窗口已经填满后才重试,于是又等了一轮。如果你把 SDK 调用包在这样的循环里,记得在客户端设 max_retries=0,否则你每次尝试都会变成三个请求。
在 TypeScript 里做同样的重试
retry.ts 遵循同样的顺序:Retry-After,然后 X-RateLimit-Reset,最后退避。它用内置的 fetch,不需要装任何包。我们在 Node 24 上用 npx tsx retry.ts 运行:
const URL = "https://openrouter.ai/api/v1/chat/completions"; const HEADERS = { Authorization: Bearer ${process.env.OPENROUTER_API_KEY}, "Content-Type": "application/json", };
const sleep = (ms: number) => new Promise((resolve) => setTimeout(resolve, ms)); const randomBetween = (min: number, max: number) => min + Math.random() * (max - min);
/* Seconds to wait after a 429: Retry-After, then X-RateLimit-Reset, then backoff. / export function retryDelay(headers: Headers, attempt: number): number { const retryAfter = headers.get("Retry-After"); if (retryAfter) { const seconds = Number(retryAfter); if (!Number.isNaN(seconds)) return seconds; const when = Date.parse(retryAfter); // HTTP date if (!Number.isNaN(when)) return Math.max(0, (when - Date.now()) / 1000); } const reset = headers.get("X-RateLimit-Reset"); // Unix time in milliseconds if (reset) { // Spread clients over a few seconds after the reset, so they don't all retry at once. return Math.max(0, (Number(reset) - Date.now()) / 1000) + randomBetween(1, 5); } return Math.min(2 * attempt, 60) randomBetween(0.5, 1); // exponential backoff with jitter }
export async function chat(body: object, maxAttempts = 6): PromiseHTTP ${res.status}: ${await res.text()}); return res.json(); } const error = (await res.json()).error; const source = error?.metadata?.limit_source; // A 402 from the in-flight budget clears after Retry-After; other 402s need credits. if (res.status === 402 && source !== "openrouter_in_flight_budget") { throw new Error(HTTP 402: ${JSON.stringify(error)}); } if (source === "openrouter_free_tier_daily") { throw new Error(HTTP 429: ${JSON.stringify(error)}); // resets at UTC midnight, so don't sleep until then } if (attempt === maxAttempts - 1) break; // out of attempts, so don't wait before failing const wait = retryDelay(res.headers, attempt); console.log(${res.status} (${source}), attempt ${attempt + 1}: waiting ${wait.toFixed(1)}s); await sleep(wait * 1000); } throw new Error(Still rate limited after ${maxAttempts} attempts); }
// The same batch job: 60 prompts, 10 at a time. async function main() { const prompts = Array.from({ length: 60 }, (_, i) => i); const results: any[] = []; const worker = async () => { for (let i = prompts.shift(); i !== undefined; i = prompts.shift()) { results[i] = await chat({ model: "poolside/laguna-s-2.1:free", messages: [{ role: "user", content: Reply with the number ${i}. }], max_tokens: 16, }); } };
const t0 = Date.now(); await Promise.all(Array.from({ length: 10 }, worker)); const completed = results.filter(Boolean).length; console.log(${completed} of 60 completed in ${Math.round((Date.now() - t0) / 1000)}s); }
main();
429 (openrouter_free_tier_per_minute), attempt 1: waiting 34.9s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 34.6s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 35.1s 429 (openrouter_free_tier_per_minute), attempt 1: waiting 33.5s 429 (openrouter_free_tier_per_minute), attempt 2: waiting 60.5s 429 (openrouter_free_tier_per_minute), attempt 2: waiting 58.6s 429 (openrouter_free_tier_per_minute), attempt 2: waiting 60.6s 60 of 60 completed in 106s
总耗时取决于批处理开始时窗口走到哪儿,以及该模型的 provider 有多忙。我们两次 TypeScript 运行分别用了 218 秒和 106 秒,两次 Python 运行是 92 秒和 89 秒。四次都跑完了每一个请求。
第 3 步:把溢出的请求转给后备模型
如果能接受第二个模型给出的答案,你根本不用等。provider 的速率限制只作用于该 provider 上的某一个模型,换个模型就用的是另一份余量。免费层上限是例外,因为你账户里每个 :free 模型都共享它。用 models 参数,我们按顺序试每个模型,一旦出错(包括 429)就切到下一个,这一切都发生在请求到达你的代码之前:
import os import time from collections import Counter from concurrent.futures import ThreadPoolExecutor
import requests
URL = "https://openrouter.ai/api/v1/chat/completions" HEADERS = {"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"}
def job(i): r = requests.post(URL, headers=HEADERS, timeout=120, json={
Try the free model first; if it is rate limited, OpenRouter sends the request to the next one.
"models": ["poolside/laguna-s-2.1:free", "deepseek/deepseek-v4.1-flash"], "messages": [{"role": "user", "content": f"Reply with the number {i}."}], "max_tokens": 16, }) data = r.json() return r.status_code, data.get("model"), data.get("usage", {}).get("cost", 0)
t0 = time.time() with ThreadPoolExecutor(max_workers=10) as pool: # the same batch job: 60 prompts, 10 at a time results = list(pool.map(job, range(60))) print(f"finished in {time.time() - t0:.0f}s") print(Counter((status, model) for status, model, _ in results)) print(f"total cost: ${sum(cost for *_, cost in results):.6f}")
finished in 13s Counter({(200, 'poolside/laguna-s-2.1:free'): 52, (200, 'deepseek/deepseek-v4.1-flash'): 8}) total cost: $0.000066
免费模型处理了 52 个请求,付费模型处理了另外 8 个。没有任何请求等待,而且你只为付费的那些付钱。响应里的 model 字段记下是哪个模型回答的,计费也按那个模型算。
后备要选有独立余量的。你账户里每个 :free 模型都共享免费模型上限,所以当问题出在这个上限时,换另一个免费模型并不可靠。免费模型还经常耗尽 provider 的余量,因此付费后备是更稳妥的选择。
下面是同一批任务的三次运行,并列对比:
运行完成数耗时费用 OpenAI SDK,默认重试60 个中 37 个12 s$0 等到重置再重试60 个中 60 个89 s$0 models 后备60 个中 60 个13 s$0.000066
如果任务能等,就在重置时重试;如果等不了,而第二个模型的答案也够用,就加个后备。
第 4 步:让另一个 provider 提供同一个模型
第 2 步和第 3 步解决的是免费模型上限。付费模型碰到的是另一种限制:正在服务它的那个 provider 的余量。OpenRouter 上大多数模型由多个 provider 提供,各有各的速率限制。当某个 provider 返回 429 时,我们会在错误传到你这里之前,到下一个 provider 重试该请求。这个行为默认开启。
我们向 google/gemma-4-31b-it 发了 300 个请求,每次 50 个,并检查每个请求的 GET /api/v1/generation 记录里的 provider_responses 列表,它会列出我们试过的每一个 provider:
300 requests, 50 at a time, in 11s status codes: Counter({200: 300}) generation records read: 300 of 300 served by: {'CoreWeave': 177, 'DeepInfra': 118, 'Novita': 1, 'Venice': 1, 'ModelRun': 1, 'Parasail': 2} requests that needed more than one provider: 0 failed attempts, by provider and status: [] total cost: $0.00130
分散到六家 provider 之后,没有一个请求需要第二次尝试。接着我们用 “provider”: {“order”: [“crusoe”]} 把同一个模型固定到 Crusoe,发了 150 个请求,每次 50 个。下面是开启回退时的一次运行:
150 requests, 50 at a time, in 5s status codes: Counter({200: 150}) generation records read: 150 of 150 served by: {'CoreWeave': 79, 'Crusoe': 71} requests that needed more than one provider: 79 failed attempts, by provider and status: [(('Crusoe', 429), 79)] total cost: $0.00056
Crusoe 对 79 个请求做了速率限制,CoreWeave 接下了全部 79 个,客户端看到的是 150 次成功。我们把固定 provider 的运行在 allow_fallbacks 关闭和开启两种情况下各重复了几次:
allow_fallbacks运行次数每轮成功数每轮 429 数 false4150, 147, 118, 1360, 3, 32, 14 true3150, 150, 1500
Crusoe 的余量每分钟都在变,所以关闭回退时失败数从 0 到 32 不等。开启回退后,三次运行里 Crusoe 分别限了 21、41 和 79 个请求,客户端一次都没看到。凡是收窄「哪些 provider 能服务请求」的设置,都会削弱吸收突发流量的余量。如果你在 OpenRouter 上仍看到 provider 的 429,检查是不是设了 allow_fallbacks: false、太短的 only 列表,或太紧的 max_price。想偏好某家 provider 又不丢掉故障转移,就设 order,并让 allow_fallbacks 保持默认。
同样 300 个请求的突发流量打到 anthropic/claude-haiku-5.5 和 openai/gpt-6-luna 上,没有任何失败尝试。闭源模型自己的 API 耗尽余量时,错误通常是 529 而不是 429,Claude 529 过载指南 讲的就是这个。
怎样彻底避免撞上速率限制?
上面的办法都是在 429 发生之后补救。下面这些习惯能降低它出现的概率:
把并发压到限额允许的范围内。 第一个测试就是被并发推过限额的。把请求节奏控制在略低于限额,比 429 之后等一整个窗口损失的时间更少。 把 max_tokens 设得接近你预期的答案长度。 OpenAI 会把 max_tokens 计入每分钟 token 限额,所以给得太宽裕,限额消耗得比答案本身还快。 跑大任务前先查一下 key。 GET /api/v1/key 会报出每日免费模型计数。这些运行之后,我们这边读到 {‘used’: 585, ‘limit’: 1000, ‘remaining’: 415}。在买够至少 10 credits 之前,每日限额是 50 次免费模型请求,之后是 1,000 次。 生产环境用付费版本。 每分钟 20 次的上限只适用于 :free models。
常见问题
怎样提高我的 OpenAI API 速率限制?
随着组织的累计充值金额越过每个用量档位的门槛,OpenAI 会自动提高你的限额。当前限额可以在 OpenAI 控制台的 Settings > Organization > Limits 下查看。通过 OpenRouter,provider 路由会把一个模型的流量摊到所有提供它的 provider 上,因此单家 provider 的限额卡不住你。
为什么 Claude 提示 “rate limit reached”?
在 Claude API 上,这表示你的组织用完了该模型每分钟的请求数或 token 数,retry-after 响应头会给出要等多少秒。如果 429 来自每月消费上限,就没有 retry-after 响应头,在访问恢复之前重试也没用。在订阅版 Claude Code 里,这条消息通常指的是套餐的用量上限。参见达到 Claude Code 用量上限了?。
多用几个 API key 能绕过速率限制吗?
不能。在 OpenRouter 上,多开 API key 或多开账号都不会改变你的速率限制,因为我们是全局管控容量的。provider 的限制是按模型算的,这正是后备模型能奏效的原因;但你账户里每个 :free 模型共享同一个免费层上限。用 BYOK 时,使用你自带 provider key 的请求会占用你在那家 provider 处的限额。
Retry-After 的单位是秒还是毫秒?
秒,或者一个 HTTP 日期。我们的 X-RateLimit-Reset 不一样,它是以毫秒为单位的 Unix 时间戳。第 2 步里的 retry_delay 函数能处理这三种形式。
后续步骤
限额:免费模型上限、X-RateLimit-* 响应头,以及如何处理 402 和 429 错误。 provider 路由:order、allow_fallbacks、only 和排序。 模型后备:models 参数,以及后备请求如何计费。 免费 LLM API 对比:各家 provider 的免费层限额。