在线AI教程 / AI上云
[OpenRouter] MCP、CLI 与 skills:各自在上下文中的成本
MCP、CLI 与 skills:各自在上下文中的成本 OpenRouter ·11/11/2026 你给 agent 的每一个工具,都会在每次请求时把定义发给模型,并按输入 to
MCP、CLI 与 skills:各自在上下文中的成本
OpenRouter ·11/11/2026
你给 agent 的每一个工具,都会在每次请求时把定义发给模型,并按输入 token 计费。一个 Model Context Protocol (MCP) server 可能给上下文窗口增加数万个 token。常见的替代方案是命令行工具 (CLI),或一个 skill。
我们用一个 GitHub 任务做了测量:分别用 GitHub MCP server、gh CLI 和一个 gh skill,跑在 Claude Haiku 5.5、Claude Sonnet 5.5、GPT-6 Luna 和 Gemini 3.8 Flash 上。在 Sonnet 5.5 上,三种方式都答对了,但用掉的输入 token 差别很大:CLI 用了 1,421,skill 用了 3,315,加载默认 tools 的 MCP server 用了 59,417。下面说明这些 token 花在了哪里,以及如何用我们的 Tool Search server 工具把它们降下来。
TL;DR
GitHub MCP server 的 46 个默认 tools 在 Claude Sonnet 5.5 上给每次请求增加 19,436 个 token。 在 Sonnet 5.5 上,光是一条工具结果(GitHub 的 release 对象)就花了约 20,400 个 token,比全部 46 个定义还多。 Tool Search 把 46 个 tools 的前置开销压到 600 个 token 以内。放到整个任务看,它让 Sonnet 5.5 的成本减半,却让 Claude Haiku 5.5 的成本上升。
MCP、CLI 和 skill 之间有什么区别?
三者都给模型增加一种能力,区别在于模型在使用它之前要先读到什么。
模型预先看到什么模型行动时看到什么 MCP server每次请求里每个 tool 的名称、描述和 JSON schema该 tool 的结果,形状由 server 返回什么决定 CLI一个 shell 工具,加一行说明该 CLI 存在命令的输出,可用 —json 这类 flag 调整形状 Skill每个 skill 的一行描述该 skill 的 SKILL.md 文件(读一次),然后是命令输出
CLI 依赖模型本来就认识这个工具;skill 则教模型怎么用某个工具,而且只在任务需要时才把完整指令加载进来。
一个 MCP server 会给每次请求增加多少 token?
可靠的数法是直接问模型。每家 provider 在计数之前,会按自己的格式把工具定义写进 prompt,本地 tokenizer 算不到这部分。把同一个请求分别带上和不带 tools 各发一次,usage.prompt_tokens 的差值就是这些 tools 每一轮的开销。
把下面这段存成 mcp_cost.py。它用的是 MCP 的 2025-06-18 版本,GitHub server 接受这个版本。
"""How many prompt tokens does an MCP server add to every request? Ask the model.""" import json import os import subprocess import sys
import requests
API = "https://openrouter.ai/api/v1/chat/completions" HEADERS = {"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"}
def list_mcp_tools(command): """Start a stdio MCP server, run the handshake, and return its tools/list result.""" proc = subprocess.Popen(command, stdin=subprocess.PIPE, stdout=subprocess.PIPE, stderr=subprocess.DEVNULL, text=True)
def rpc(method, params, id=None): msg = {"jsonrpc": "2.0", "method": method, "params": params} if id is not None: msg["id"] = id proc.stdin.write(json.dumps(msg) + "\n") proc.stdin.flush() while id is not None: reply = json.loads(proc.stdout.readline()) if reply.get("id") == id: return reply["result"]
rpc("initialize", {"protocolVersion": "2025-06-18", "capabilities": {}, "clientInfo": {"name": "mcp-cost", "version": "1"}}, id=1) rpc("notifications/initialized", {}) tools, cursor, id = [], None, 2 while True: # follow nextCursor so servers that paginate tools/list are fully counted page = rpc("tools/list", {"cursor": cursor} if cursor else {}, id=id) tools += page["tools"] cursor, id = page.get("nextCursor"), id + 1 if not cursor: break proc.kill() return tools
def prompt_tokens(model, tools=None): body = {"model": model, "max_tokens": 16, "messages": [{"role": "user", "content": "Say ok."}]} if tools: body["tools"] = tools if model.startswith("google/"):
Google Vertex and Google AI Studio count the same tools differently, so pin one.
body["provider"] = {"only": ["google-vertex"]} r = requests.post(API, headers=HEADERS, json=body, timeout=120) r.raise_for_status() return r.json()["usage"]["prompt_tokens"]
if __name__ == "__main__": mcp_tools = list_mcp_tools(sys.argv[1:])
What an MCP client sends the model: each tool's name, description and input schema.
tools = [{"type": "function", "function": {"name": t["name"], "description": t.get("description", ""), "parameters": t["inputSchema"]}} for t in mcp_tools] print(f"{len(tools)} tools") for model in ["anthropic/claude-haiku-5.5", "openai/gpt-6-luna", "google/gemini-3.8-flash"]: added = prompt_tokens(model, tools) - prompt_tokens(model) print(f"{model:30} +{added:,} prompt tokens on every request")
把 server 的启动命令作为参数传进去,就像这里针对 GitHub MCP server v2.0.2 的做法。
$ python mcp_cost.py github-mcp-server stdio --toolsets=default 46 tools anthropic/claude-haiku-5.5 +19,436 prompt tokens on every request openai/gpt-6-luna +8,903 prompt tokens on every request google/gemini-3.8-flash +8,525 prompt tokens on every request
每加一个 tool,成本都会上涨。在 Haiku 5.5 上,issues toolset 有 10 个 tool,增加 5,801 个 token;users toolset 只有一个 tool,增加 619 个。
用哪个模型也会改变数字。同样 46 个 tools,在 Haiku 5.5 上是 19,436 个 token,在 GPT-6 Luna 上却是 8,903 个,所以要在你打算实际运行的模型上测。
连提供模型的 provider 也会改变它。在 Gemini 3.8 Flash 上,这 46 个 tools 经 Google Vertex 是 8,525 个 token,经 Google AI Studio 是 13,010 个。这就是脚本始终把 Gemini 请求发给 Google Vertex 的原因。
同一个任务用 CLI、skill 和 MCP 各要花多少?
我们向每个模型提问:“GitHub 仓库 cli/cli 的最新版本是什么?该仓库里带 bug 标签、最近新开的三个 issue 是哪几个?”每种方式都作为工具调用循环跑在我们的 Responses API 上,再把各请求里的 usage.input_tokens 加起来。
CLI。 一个 run_shell 工具,外加一行说明“GitHub CLI gh 已安装并完成认证。” Skill。 同样的工具,再加一个一行索引,指向一份 1,492 字符、写着 gh 用法的 SKILL.md。 MCP。 server 的 tools,范围限定为任务需要的 2 个、默认的 46 个,或全部 91 个。
2026 年 10 月 20 日,我们把每种组合各跑了三次,下表取中位数。Haiku 5.5 对 prompt 的计数和 Sonnet 5.5 完全一样,但某些运行里它多绕了几轮,所以我们展示 Sonnet 更稳定的 token 数和计费成本。
方式Sonnet 5.5 token 数Sonnet 5.5 每任务成本GPT-6 Luna token 数Gemini 3.8 Flash token 数 CLI1,421$0.00756275,292 Skill3,315$0.01181,5426,107 MCP,2 个 tools23,228$0.055214,47917,267 MCP,46 个默认 tools59,417$0.1274116,28235,409 MCP,全部 91 个 tools101,351$0.2113135,23853,289 MCP,2 个 tools,结果上限 4,000 字符5,357$0.01912,7262,943
这张表里的每次运行都答对了。失败出在下面要讲的 Tool Search 上。在 Sonnet 5.5 上,默认 MCP server 用掉的输入 token 是 CLI 的 42 倍,成本是它的 17 倍:每 1,000 个任务 $127 对 $7.50。在 Sonnet 5.5 上输出 token 的单价是输入的五倍,CLI 那次运行的 463 个输出 token 占了 $0.0075 里的 $0.0046。
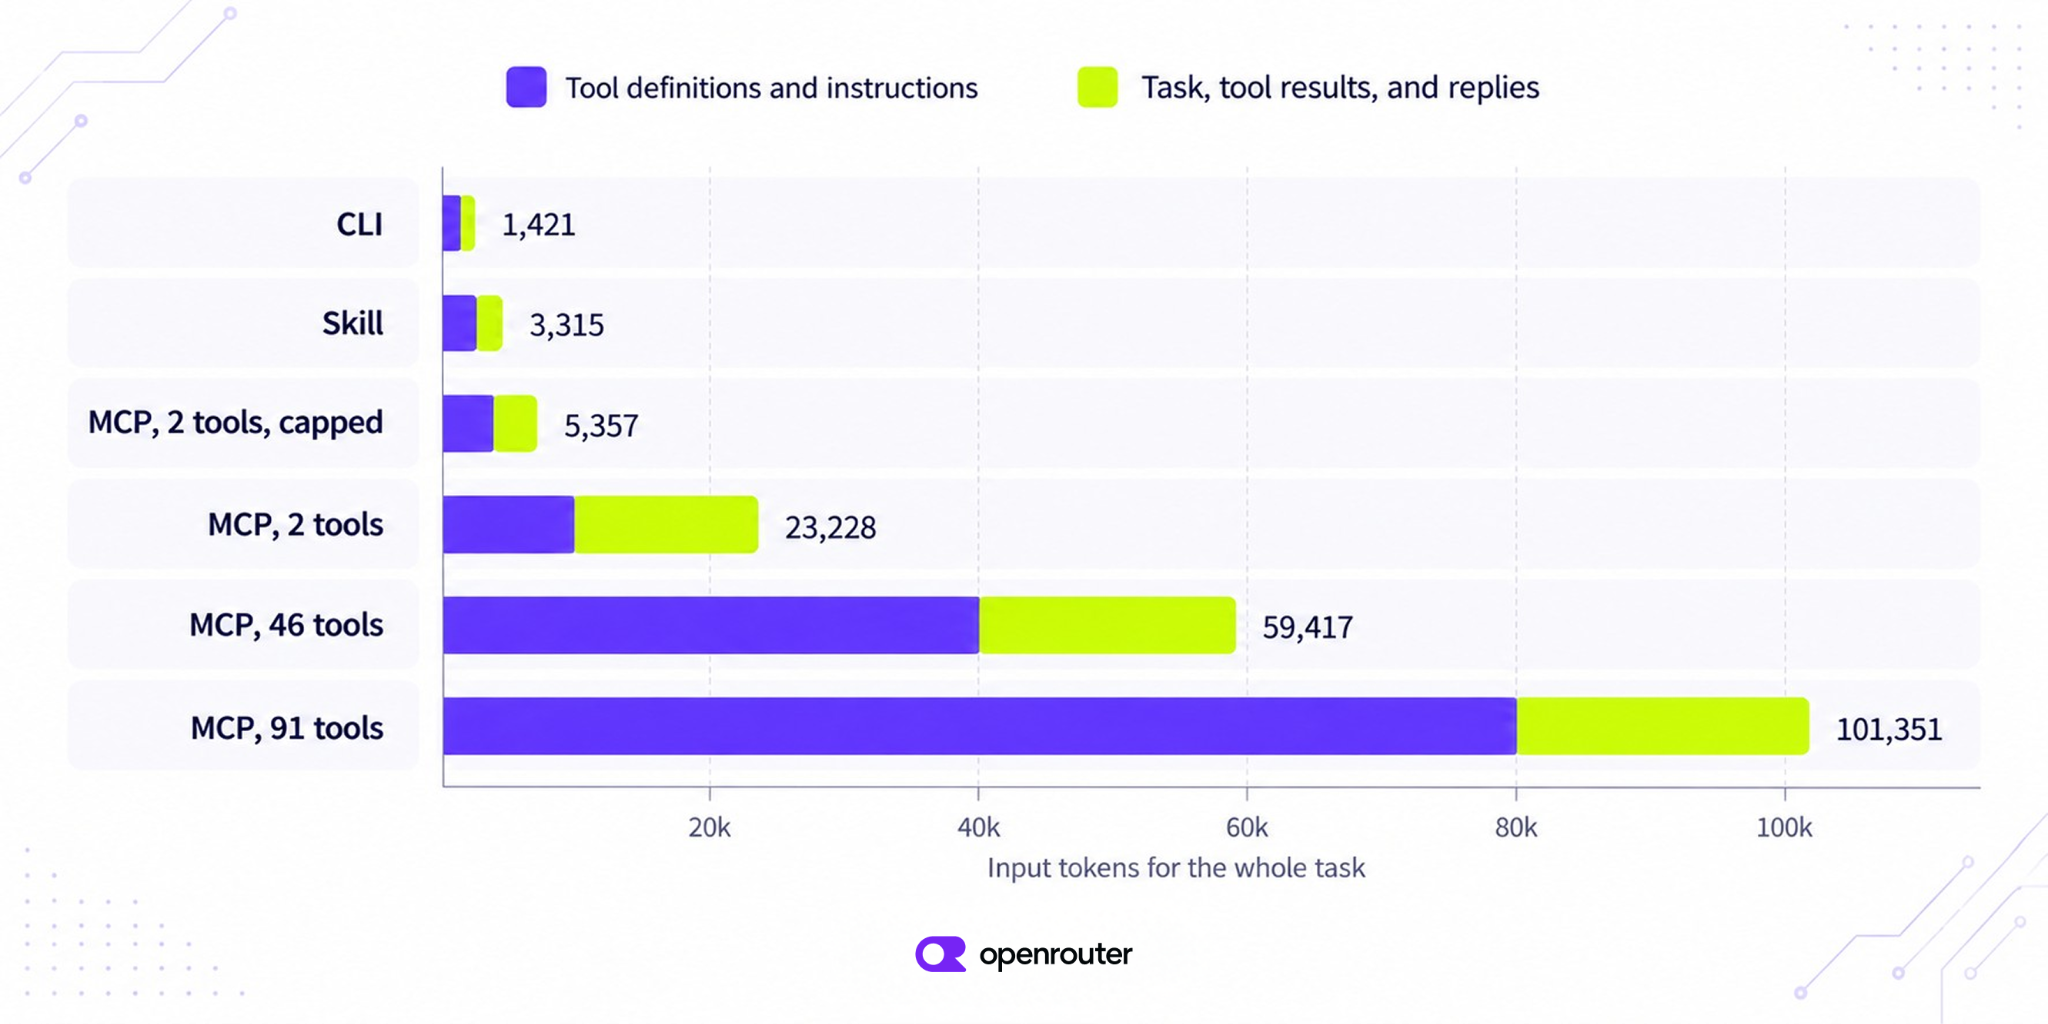
skill 比纯 CLI 更贵,是因为模型读过那份文件后,它会一直留在对话里。对于模型已经很熟的 CLI 工具,skill 可有可无;如果是你自己的 CLI,skill 就是模型学会这些命令的途径。
为什么 MCP 的工具结果和定义一样贵?
get_latest_release 返回了 GitHub 完整的 release 对象,有 42,182 个字符,其中 87% 在描述那 22 个下载文件。模型其实只需要 tag 和日期,而 gh release view 返回的就是这些。
$ gh release view -R cli/cli --json tagName,publishedAt {"publishedAt":"2026-09-30T02:40:02Z","tagName":"v2.102.0"}
这个对象会留在上下文窗口里,之后每次请求都要重发一遍;在 Sonnet 5.5 上,它多占了约 20,400 个 token。把 server 限定到两个 tools,首个请求从 19,487 个 token 降到 1,406 个,但整个任务仍花了 23,228 个。
表格里给出两个办法。第一,只暴露 agent 需要的 tools,用 —tools=get_latest_release,list_issues 或 —toolsets=issues,repos。第二,在模型看到之前,先在客户端把结果压小。设 4,000 字符上限后,限定范围的那条路径降到 5,357 个 token,而且每次运行都答对——因为 GitHub 把 tag 和日期放在靠前的位置。
这个上限能奏效,只是因为那些字段恰好排在前面。再叠加 Tool Search 后,Gemini 3.8 Flash 和 Haiku 5.5 在三次运行里各自只答对一次,Gemini 还有一次在重试时撞到了我们设的 12 次请求上限。
更稳妥的是保留完整字段,就像 CLI 里的 —json 那样。GitHub server 的 list_issues 接受 fields 参数,只取 number、title 和创建日期,就能把结果从 8,336 个字符压到 714 个。没有它,大小就由模型自己决定:在加载了 46 或 91 个 tools 的六次运行里,有四次 GPT-6 Luna 要了 100 个 issue 的全文,拿回 281,963 个字符。
Tool Search 能解决 MCP 的上下文问题吗?
Tool Search 去掉了工具定义的大部分开销。你把 tools 标成 defer_loading: true,再加上 {“type”: “openrouter:tool_search”}。我们会扣住延迟加载的定义,只发送搜索工具和你保留加载的那些 tools。模型用正则表达式去搜工具名称和描述,在下一轮调用命中的那个。它目前是 beta,在 Responses 和 Messages API 上可配合任意模型和 provider 使用。
把 46 个 GitHub tools 全部延迟加载后,任何搜索开始之前的开销,在 Claude 系列模型上是 578 个 token,GPT-6 Luna 上是 144 个,Gemini 3.8 Flash 上是 130 个。
这个脚本把同一个问题分别在加载全部 46 个 tools 和延迟加载两种情况下各发一次。把它放在 mcp_cost.py 旁边,因为它会复用 list_mcp_tools。
"""Send the same MCP tools with defer_loading and openrouter:tool_search, and compare prompt tokens.""" import os import sys
import requests
from mcp_cost import list_mcp_tools
API = "https://openrouter.ai/api/v1/responses" HEADERS = {"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"} QUESTION = "What is the latest release of the GitHub repository cli/cli?"
def ask(model, tools): r = requests.post(API, headers=HEADERS, timeout=300, json={"model": model, "input": QUESTION, "tools": tools}) r.raise_for_status() return r.json()
mcp_tools = list_mcp_tools(sys.argv[1:])
The Responses API takes function tools flat: type, name, description, parameters.
tools = [{"type": "function", "name": t["name"], "description": t.get("description", ""), "parameters": t["inputSchema"]} for t in mcp_tools] deferred = [{"type": "openrouter:tool_search"}] + [{**t, "defer_loading": True} for t in tools]
for model in ["anthropic/claude-haiku-5.5", "openai/gpt-6-luna"]: for label, tool_list in [("all loaded", tools), ("tool search", deferred)]: res = ask(model, tool_list) steps = [f"search {o['query']!r}" if o["type"] == "openrouter:tool_search" else f"call {o['name']}" for o in res["output"] if o["type"] in ("openrouter:tool_search", "function_call")] print(f"{model:28} {label:12} {res['usage']['input_tokens']:>6,} input tokens {' -> '.join(steps)}")
$ python tool_search.py github-mcp-server stdio --toolsets=default anthropic/claude-haiku-5.5 all loaded 19,464 input tokens call get_latest_release anthropic/claude-haiku-5.5 tool search 7,069 input tokens search 'github|release' -> search 'latest release|list_releases|get_latest_release' -> call get_latest_release openai/gpt-6-luna all loaded 8,923 input tokens call get_latest_release openai/gpt-6-luna tool search 4,453 input tokens search 'github repository latest release cli cli' -> search 'github' -> search 'search web internet browser' -> search 'release' -> call get_latest_release
想在自己的 agent 上试,就把 MCP tools 标成 defer_loading: true,加上 {“type”: “openrouter:tool_search”},再比较前后的 usage.input_tokens。
Tool Search 那几行会随模型的搜索方式变化。这个脚本单独跑五次,Haiku 5.5 用了 2,134 到 13,225 个 token,每多搜一次就往上涨。GPT-6 Luna 写的是短语而不是模式,搜了三到六次,还有一次没调用工具就放弃了。我们的文档 建议把最常用的三到五个 tools 保持加载。
放到整个任务看,结果取决于用的是哪个模型。
模型MCP,加载 46 个 toolsTool Search,延迟 46 个Tool Search,延迟 91 个 Claude Sonnet 5.559,41730,33431,615 GPT-6 Luna116,28225,54457,975 Gemini 3.8 Flash35,40937,56838,445 Claude Haiku 5.599,319154,62331,781
GPT-6 Luna 那一列的加载数据包含上面提到的 100 个 issue 请求。
在 Sonnet 5.5 上,延迟加载 91 个 tools 只比 46 个多花 1,281 个 token,而全部加载 91 个要多花约 42,000 个。Tool Search 不会压缩工具结果,那个 release 对象仍占满了 Sonnet 第二次请求的大半。
Haiku 5.5 延迟加载 46 个 tools 时反而比全部加载更贵。三次运行里,它每次都向 list_issues 要一个该工具并不提供的字段,接着用类型不对的参数重试三到四次,比如把 labels 传成字符串而不是数组。全部加载时,Haiku 三次里有两次犯了同样的错,但下一次调用就改对了。给循环里的请求设个上限,一旦某次运行的成本突然跳高,就去查工具报错。
Tool Search 是靠放宽 tool_choice 来暴露 tools 的,所以如果请求同时还强制发起工具调用,就会失败。
400:tool_choice 与 openrouter:tool_search 冲突。延迟加载的 tools 通过 tool_choice 暴露,所以必须省略它,或设为 {“type”: “allowed_tools”, …}。要么去掉 tool_choice,要么从 tools 里移除 defer_loading 按原样使用。
Chat Completions 不接受 openrouter:tool_search,会返回 400,所以先把那个 agent 迁到 Responses 或 Messages API。
MCP、CLI 和 skills:该用哪个?
如果有现成的 CLI、agent 也能跑命令,就用 CLI;做不到就用 MCP,但要限定范围、把结果压小。
你的情况用哪个我们在 Sonnet 5.5 上的运行结果 有广为人知的 CLI,且 agent 能跑命令CLI每任务 1,421 个 token 你自己的 CLI,或模型用得不太稳的 CLICLI 加一个 skill3,315 个 token,每次运行命令都一样 没有 CLI、没有 shell,或需要 server 的鉴权与权限MCP,限定到需要的 tools2 个 tools 时 23,228 个 token,46 个时 59,417 个 跨多台 server 的大型工具库带 Tool Search 的 MCP在 Sonnet 5.5 上,延迟加载 91 个 tools 的成本与 46 个相当 任何 MCP 路线把工具结果裁剪到需要的字段从 23,228 降到 5,357 个 token
如果 agent 没有 shell,我们的 Shell server tool 能给任何模型一个沙箱里的 shell。在我们的 Agent SDK 里,MCP Tools 负责连接远程 MCP server,skills loader 示例 则只在模型主动要求后才把 skill 的指令加进来。
我们只在一个任务上测了一台 server,所以做决定之前,先在你自己的 server 上跑一遍 mcp_cost.py。
常见问题
AI agent 语境里的 CLI 是什么?
CLI(命令行界面)是用键入的命令来运行的程序。agent 拿到一个 shell 工具,自己写命令。在我们的测试里,gh CLI 在 GitHub 任务上用了 1,421 个输入 token,而 GitHub MCP server 用了 59,417 个。
MCP server 和 connector 有什么区别?
MCP server 通过 Model Context Protocol 暴露 tools。connector 则是 Claude 这类应用对「连到某台远程 MCP server」的叫法。我们的 Agent SDK 可以通过 MCP Tools 连接远程 MCP server。
skills 会取代 MCP 吗?
不会。skill 是指令,通常针对某个 CLI,只在任务需要时才加载。MCP 提供带类型的 tools、自带鉴权,而且不需要 shell 就能工作。在 OpenRouter 上,Tool Search 让你既保留 MCP,又只在需要时加载每个 tool。
prompt caching 能解决 MCP 的 token 开销吗?
它降低了这些 token 的单价,但没有把它们消掉。截至 2026 年 10 月,在 OpenRouter 上,cached input 按我们的实时模型价格 只算 Claude Haiku 5.5 和 GPT-6 Luna 正常费率的十分之一,且仍会占满上下文窗口。
MCP tools 多到什么程度算太多?
我们的 Tool Search 文档建议,当定义超过约 10,000 个 token、或大约 10 个 tools 时,就改为延迟加载。GitHub MCP server 的 46 个默认 tools 在 Claude 上是 19,436 个 token。
后续步骤
Tool Search 覆盖所有选项,包括 max_results。 构建可靠的工具调用 agent 循环 展示了我们运行用的那类循环,带迭代上限。 OpenRouter Prompt Caching 讲清了缓存 token 的成本。