在线AI教程 / AI上云
[Amazon Bedrock] 在 Amazon Bedrock 上推出 Kimi K3.1 Pro
人工智能 在 Amazon Bedrock 上推出 Kimi K3.1 Pro Moonshot AI 的 Kimi K3.1 Pro Highspeed 现已在 Amazon B
人工智能
在 Amazon Bedrock 上推出 Kimi K3.1 Pro
Moonshot AI 的 Kimi K3.1 Pro Highspeed 现已在 Amazon Bedrock 上线。它是 Moonshot AI 新 K3.1 系列的一员,是 Kimi K3 的后训练版本,沿用同样的 3T 级开放权重架构和 100 万 token 上下文窗口,但用了多得多的后训练算力。据 Moonshot AI 说,这些额外训练针对的是长周期 agentic 工作和更少的事实错误,也改进了财务建模、办公文档等专业任务,以及游戏引擎、3D 场景和计算机辅助设计(CAD)脚本的编码。Kimi K3.1 Pro Highspeed 生成输出 token 的速率更高,Moonshot AI 称其速度是 Kimi K3.1 Pro 的 2–3 倍。
Kimi K3.1 Pro Highspeed 使用与 Amazon Bedrock 上 Kimi K3 相同的 endpoint、API 和功能。如果你已经在用 Kimi K3 构建,只需改掉现有代码里的模型 ID 就能试用。
Kimi K3.1 Pro Highspeed 支持工具调用、结构化输出、可配置推理、图像输入和流式输出。采用 Kimi K3.1 Pro Highspeed 无需改动你的安全态势。你的数据在 AWS 数据边界内处理,不会与 Moonshot AI 共享,也不会用于训练模型。推理请求始终启用零数据保留;再加上零操作员访问,AWS 操作员在推理期间无法查看你的 prompt 和补全内容。
本文展示如何在 Amazon Bedrock 上开始使用 Kimi K3.1 Pro Highspeed,还会讲到如何用 Flex tier 降低成本、如何用显式 prompt caching 处理重复上下文,以及如何把这个模型用作 OpenCode 里的编码助手。
在 Amazon Bedrock 上开始使用 Kimi K3.1 Pro Highspeed
不想写代码就想试用模型,打开 Amazon Bedrock 控制台,依次选择 Test、Playground,再选中 Kimi K3.1。
在代码里,Kimi K3.1 Pro Highspeed 可通过 bedrock-runtime endpoint 上的 OpenAI 兼容 Chat Completions 和 Responses API 调用,也可通过 Amazon Bedrock 的 Converse 和 Invoke API 调用。我们推荐 Chat Completions API。你通过跨区域推理配置文件访问模型:
global.moonshotai.kimi-k3.1 把请求路由到任何受支持的商业 AWS 区域,每个 token 的成本低于按地理划分的配置文件。多数工作负载我们都推荐用它。 对有数据驻留要求的工作负载,us.moonshotai.kimi-k3.1 把处理限制在美国区域内,in.moonshotai.kimi-k3.1 则限制在印度区域内。
先决条件
跟随本文的示例,你需要:
一个可访问 Amazon Bedrock 的 AWS 账户。 Python 3.11 或更高版本,并装好 OpenAI SDK、aws-bedrock-token-generator 和 boto3(pip install -U openai aws-bedrock-token-generator boto3)。 一个 AWS Identity and Access Management (IAM) 身份,允许对 Kimi K3.1 Pro Highspeed 的推理配置文件调用 bedrock:InvokeModel 和 bedrock:InvokeModelWithResponseStream。如果用 bearer token 认证,再加上 bedrock:CallWithBearerToken。
用 Chat Completions API 调用 Kimi K3.1 Pro Highspeed
如果你的应用已经在用 OpenAI SDK,把它指向 Amazon Bedrock endpoint 并改掉模型名即可。下面的例子用 AWS 凭证生成一个短期 bearer token,然后发出一次请求:
from openai import OpenAI from aws_bedrock_token_generator import provide_token
REGION = "us-west-2" MODEL_ID = "global.moonshotai.kimi-k3.1"
A short-term token derived from your AWS credentials, so no long-lived key is stored in code
client = OpenAI( base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1", api_key=provide_token(region=REGION), )
completion = client.chat.completions.create( model=MODEL_ID, messages=[ {"role": "system", "content": "You are a concise senior engineer."}, {"role": "user", "content": "When should I prefer a queue over a stream?"}, ], reasoning_effort="high", ) print(completion.choices[0].message.content)
Kimi K3.1 Pro Highspeed 总是先推理再作答。用 reasoning_effort 控制推理量:low、high 或 max。不设置时模型默认用 max,因此在较简单的任务上,调低它是减少延迟和输出 token 最直接的办法。
用 Responses API 调用 Kimi K3.1 Pro Highspeed
同一个客户端也适用于 Responses API,它用 reasoning.effort 表示同一设置:
response = client.responses.create( model=MODEL_ID, input="Summarize the trade-offs between optimistic and pessimistic locking.", reasoning={"effort": "low"}, ) print(response.output_text)
用 Converse API 调用 Kimi K3.1 Pro Highspeed
如果你已经在用 Amazon Bedrock Converse API,要改的只是模型 ID:
import boto3
bedrock = boto3.client("bedrock-runtime", region_name="us-west-2") response = bedrock.converse( modelId="global.moonshotai.kimi-k3.1", messages=[{"role": "user", "content": [{"text": "Explain idempotency keys in two sentences."}]}], )
The model can return a reasoning block before the answer, so pick the text block
content = response["output"]["message"]["content"] print(next(block["text"] for block in content if "text" in block))
用 Flex tier 降低成本
Flex tier 以 Standard 价格的一半提供 Kimi K3.1 Pro Highspeed,代价是响应时间可能更长。它很适合那些把成本效率看得比响应时间更重的工作负载,比如模型评估、内容摘要,以及 agentic 工作流里的后台任务。由于档位是按每次请求选的,一个应用可以混用不同档位。例如,同一个应用可以用 Priority 处理延迟敏感的请求、用 Standard 承载日常流量、用 Flex 做成本敏感的工作。你的按需配额在 Standard、Priority 和 Flex 之间共享。
要用 Flex,把 service_tier 设为 flex。下面的例子复用前面的 Chat Completions 客户端:
completion = client.chat.completions.create( model=MODEL_ID, messages=[{"role": "user", "content": "List edge cases to test in a function that parses ISO 8601 dates."}], service_tier="flex", ) print(completion.choices[0].message.content) print(completion.service_tier) # The tier that served the request
在 Converse API 上,则把 serviceTier 设为 {"type": "flex"}。想知道每个档位承接了多少流量,可以看 Amazon CloudWatch 里的 ServiceTier 和 ResolvedServiceTier 维度。我们建议先拿一小部分流量试 Flex,比较延迟和成本,再逐步加大。
用显式 prompt caching 优化推理
Agents 和编码助手每一轮都会重发同一大段前缀:系统指令、工具定义、仓库约定和参考文档。Kimi K3.1 Pro Highspeed 会自动缓存重复的前缀;而借助显式 prompt caching,你可以标出稳定前缀在哪里结束,以提高缓存命中率。后续请求会复用这段前缀,不再重复处理,从而降低长而重复的上下文带来的延迟和输入成本。
有几条规则:
显式缓存适用于 Chat Completions、Responses 和 Invoke API,但不适用于 Converse。 prompt_cache_breakpoint 必须跟在至少 256 个 token 的稳定内容之后。 缓存内容至少保留 30 分钟。 缓存写入按高于标准输入的费率计费;缓存读取按折扣费率计费,且不计入每分钟输入 token 配额。
下面的例子缓存了一段长系统 prompt,并在用户内容之后加了第二个断点,这样针对同一文档的追问就能复用这两层:
from pathlib import Path
LONG_STATIC_PROMPT = Path("repo_guidelines.md").read_text() # stable content, at least 256 tokens QUESTION = "Which of these guidelines apply to database migrations?"
def cached_text(text):
Marks the end of a cacheable prefix
return {"type": "input_text", "text": text, "prompt_cache_breakpoint": {"mode": "explicit"}}
response = client.responses.create( model=MODEL_ID, extra_body={"prompt_cache_options": {"mode": "explicit"}}, input=[ {"type": "message", "role": "system", "content": [cached_text(LONG_STATIC_PROMPT)]}, {"type": "message", "role": "user", "content": [cached_text(QUESTION)]}, ], ) details = response.usage.input_tokens_details print(f"Cache read: {details.cached_tokens} tokens") # greater than 0 on a cache hit
有关更多信息,请参阅通过 prompt caching 加快模型推理。
Kimi K3.1 Pro Highspeed 实战:用 OpenCode 编码
OpenCode 是一个开源、与模型无关、跑在终端里的编码 agent。借助 OpenCode 的 OpenAI 兼容 provider 和 Amazon Bedrock API key,你可以通过 Amazon Bedrock Chat Completions API 把它连到 Kimi K3.1 Pro Highspeed。要创建密钥,在 baseURL 里设定的 AWS 区域打开 Amazon Bedrock 控制台,选择 API keys。短期密钥最长有效 12 小时,只在生成它的区域可用,推荐用于生产;长期密钥则用于探索。
把下面这段加到 ~/.config/opencode/opencode.json,把 baseURL 里的区域换成你自己的:
{ "$schema": "https://opencode.ai/config.json", "providers": { "amazon-bedrock-chat-completions": { "name": "Amazon Bedrock (Chat Completions)", "package": "@opencode/ai/providers/openai-compatible", "settings": { "baseURL": "https://bedrock-runtime.us-west-2.amazonaws.com/openai/v1" }, "models": { "global.moonshotai.kimi-k3.1": { "name": "Kimi K3.1 Pro Highspeed", "capabilities": { "reasoning": { "supported": true, "effort": ["low", "high", "max"] } } } } } }, "model": "amazon-bedrock-chat-completions/global.moonshotai.kimi-k3.1" }
在项目目录里启动 OpenCode,输入 /connect,选择 Amazon Bedrock (Chat Completions),按图 1 粘贴你的 API key。OpenCode 会保存密钥,因此每个密钥只需连接一次。想在一次会话里在 Kimi K3.1 Pro Highspeed 和其他模型之间切换,输入 /models。
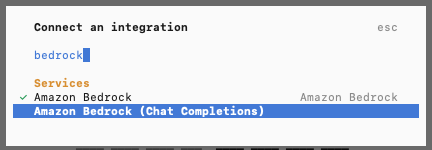
图 1:把 OpenCode 连接到 Amazon Bedrock (Chat Completions) provider
配置里的 capabilities 项列出了模型支持的推理力度级别,因此 OpenCode 会把 low、high 和 max 作为该模型的变体提供出来,如图 2 所示:
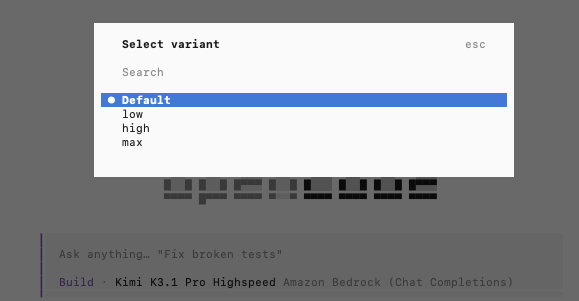
图 2:OpenCode 中 Kimi K3.1 Pro Highspeed 的推理力度变体
在 agentic 编码里,输出速度最要紧。为完成一个任务,编码 agent 会连续发起很多次模型调用:读文件、规划改动、编辑代码、跑测试、修复失败的地方。每一次调用都得等前一次结束,而其中大部分时间花在生成推理和代码上。更高的输出 token 速率会缩短每一步,于是整个“编辑—测试—修复”循环更快结束,迭代之间的等待也更少。
可用性
Kimi K3.1 Pro Highspeed 通过 global.moonshotai.kimi-k3.1、us.moonshotai.kimi-k3.1 和 in.moonshotai.kimi-k3.1 这些跨区域推理配置文件在 Amazon Bedrock 上提供。支持的区域和模型细节,请参阅 Kimi K3.1 Pro Highspeed 模型卡 和 区域可用性。定价请参阅 Amazon Bedrock 定价。
想上手,就在 Amazon Bedrock 控制台 试用 Kimi K3.1 Pro Highspeed。想和 Amazon Bedrock 团队聊聊你的用例,请与我们联系。
关于作者