在线AI教程 / AI上云
[Amazon Bedrock] The attendee’s guide to the AWS re:Invent 2026 AI/ML track
人工智能 AWS re:Invent 2026 AI/ML track 参会者指南 11 月 30 日至 12 月 4 日,Amazon Web Services(AWS)将举办一
人工智能
AWS re:Invent 2026 AI/ML track 参会者指南
11 月 30 日至 12 月 4 日,Amazon Web Services(AWS)将举办一年一度的顶级学习盛会:re:Invent。在这场活动里,参会者会通过各种体验在 AWS 技术的各个领域变得更强、更熟练:由 AWS 领导者带来的 keynotes、由 AWS 专家主持的互动式 working sessions,以及re:Play 上现场演出与游戏这类有趣、沉浸式的活动。
这里有逾 2,000 场学习 session,聚焦不同技能层级上的具体话题;其中 AI/ML(AIM)track 有超过 140 场各不相同的 session 供你挑选。我们来帮你找出最贴合你需要的那些。即便无法到现场,你也能点播补上其中许多 session,甚至实时看 keynotes。
基础:session 类型
如果你能来,记得我们提供好几种 session 类型,帮你在各种 AWS 话题上把学习收益最大化。
re:Invent 参会者可以选 breakouts、chalk talks、builder sessions、workshops 和 code talks。breakout sessions 会录制,几天后上传到 AWS Events YouTube channel;其余都是不录制的现场互动 session。各类型细节如下:
Breakout sessions: 参会者参加一场由 AWS 专家、客户和合作伙伴主讲的 60 分钟讲座式讲解 session。 Chalk-talk sessions: 参会者与讲者互动、提问,并在 session 里用白板。 Builder sessions: 参会者参加一小时的 session,动手做出点东西。 Workshop sessions: 参会者加入两小时的互动 session,在小组里用 AWS 服务解决一个真实问题。 Code talk sessions: 参会者参加以代码为核心的投入型 session,由一位专家带着做现场编码。 Lightning talk sessions: 参会者观看一场 20 分钟、专门讲某项服务或某个客户故事的演示(位于 Venetian Expo Hall 或 Wynn/Encore Upper Convention Promenade)。
有这么多 session 可选,先弄清各块怎么拼在一起会很有帮助。下面讲 AWS 怎么看待自己的 AI 产品,好让你决定从哪儿起步、在哪儿发力。
AWS AI 全栈概览,以及与 re:Invent sessions 的对应
AWS 在云上提供一套完整的 AI 组合。它从支撑 AI 工作负载的物理基础设施和 AI 芯片,一路覆盖到团队今天就能采用的、开箱即用的 agentic solutions。理解这些服务如何协同,能帮你在 re:Invent 里找准方向,聚焦与你正在构建的东西最相关的 session。
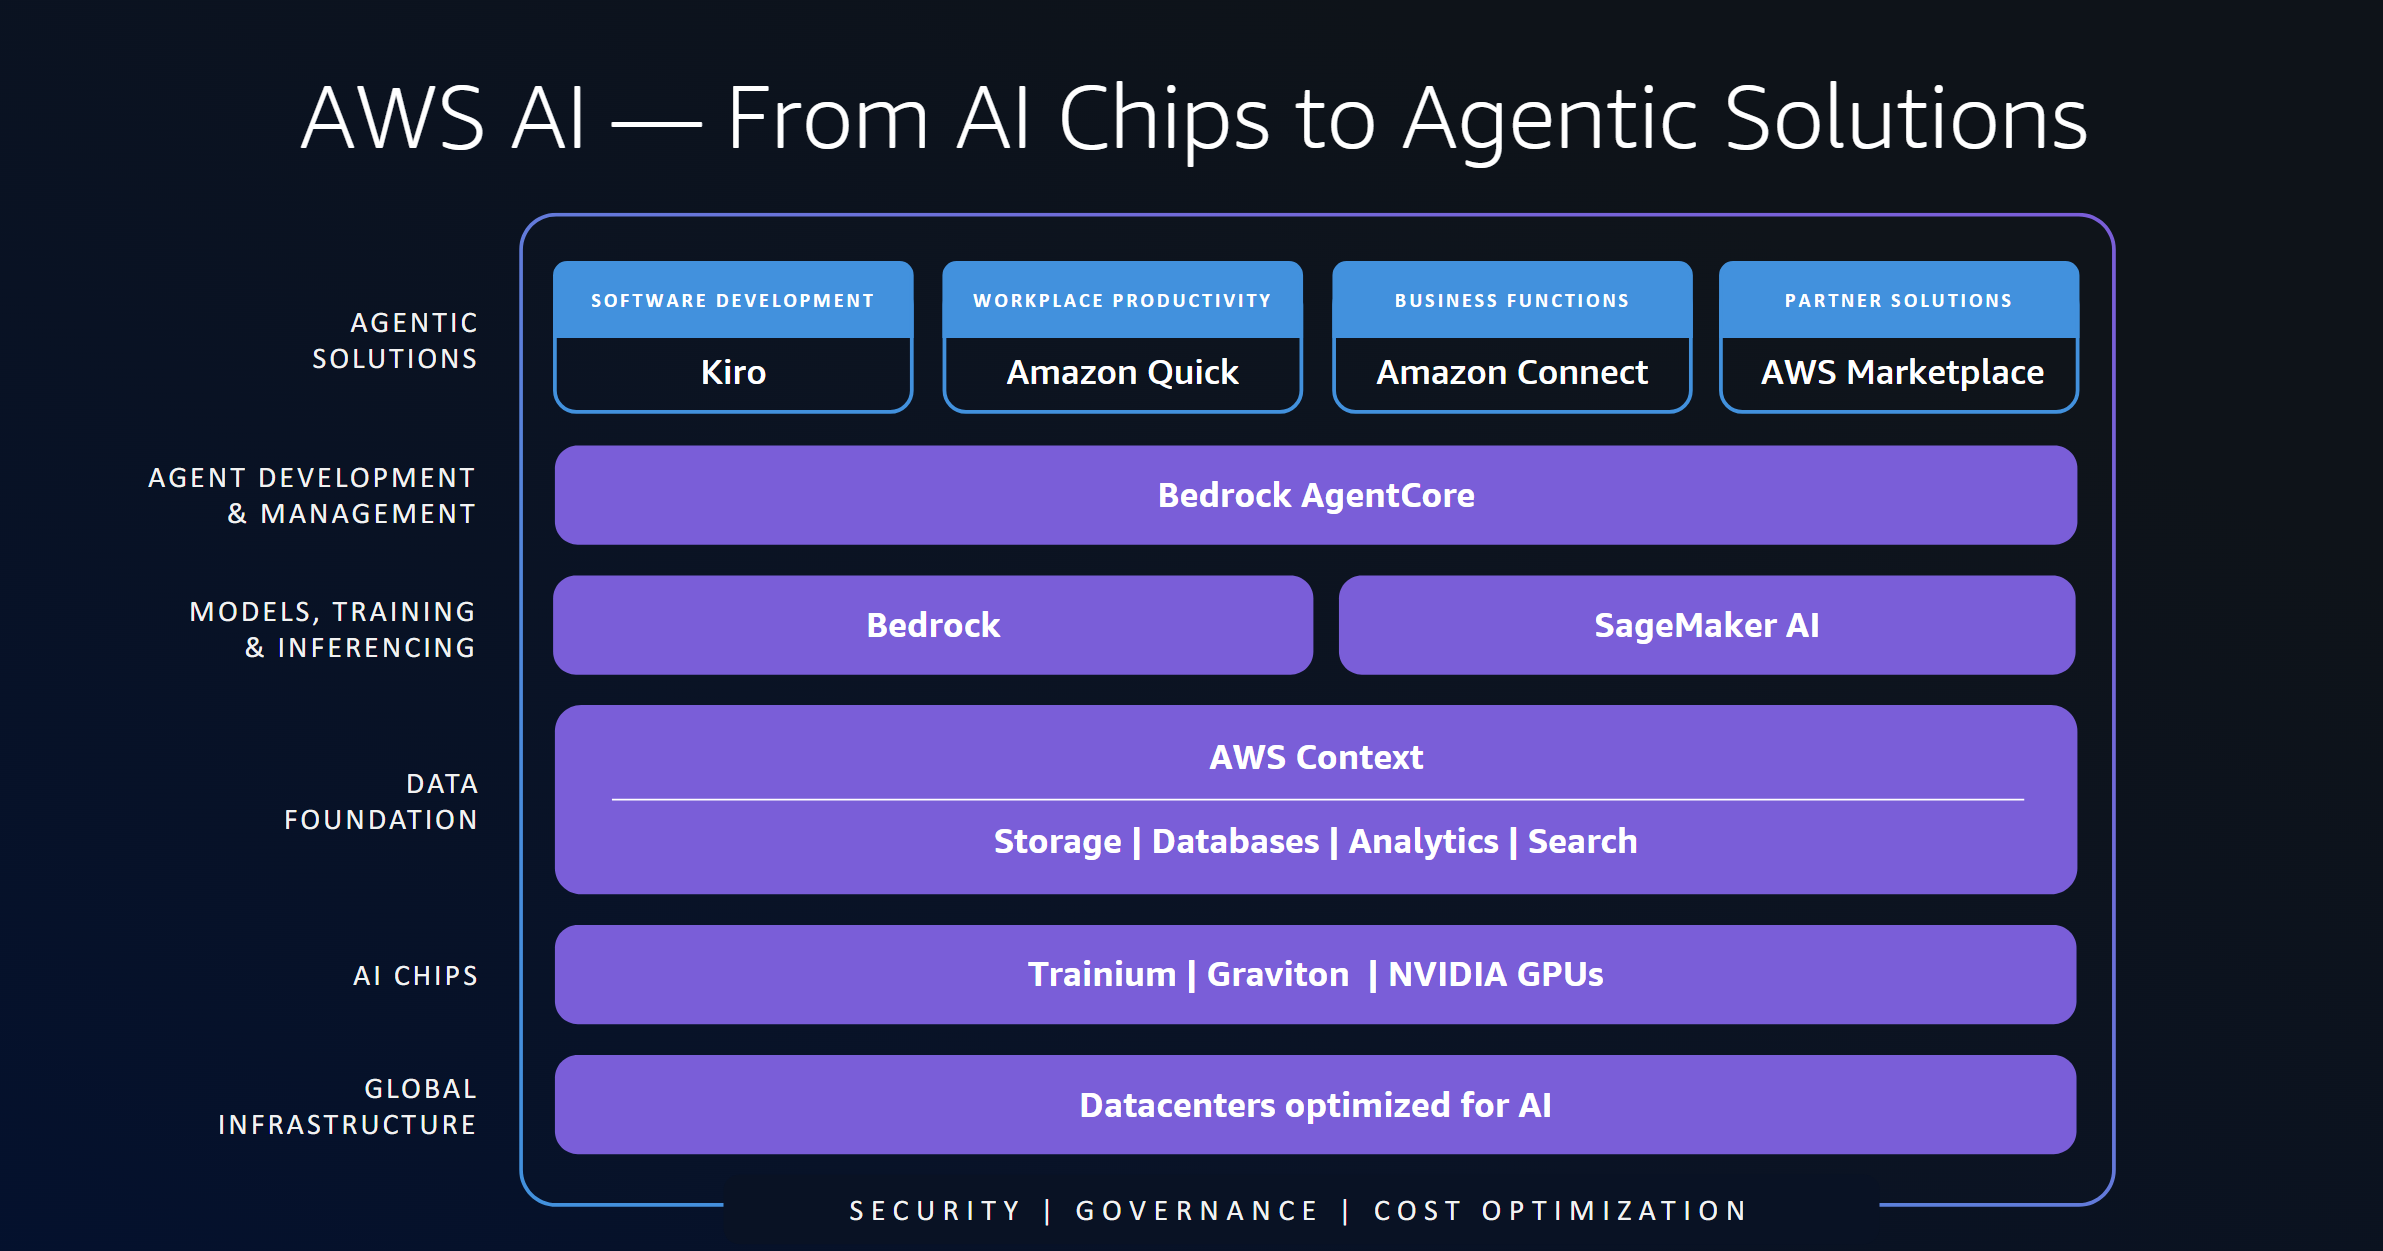
图 1:AWS AI 全栈
Global Infrastructure – 一切从为 AI 工作负载设计与优化过的数据中心开始。这些设施专为承载大型 AI 训练与推理任务所需的供电、散热和网络需求而建。
AI Chips – 跑在这些数据中心里的是两种算力选择:AWS Trainium,专为高性能 AI 训练与推理打造;以及 NVIDIA GPUs,面向需要 GPU 加速的团队。客户按自己的工作负载、性能要求和成本目标来选。
Data Foundation – AI 的上限取决于它背后的数据。AWS Context 把你在存储、数据库、分析和搜索服务里的数据连起来,让模型与 agents 在恰当的时刻拿到恰当的信息。
Models, Training, and Inferencing – 模型在这里被构建、训练、微调和提供服务。Amazon Bedrock 通过一个统一 API,给你托管访问来自多家供应商的数百个领先模型。Amazon SageMaker AI 给你完全的控制权,在专属基础设施上训练、微调和部署自定义模型。许多客户按工作负载两者都用。
Agent Development and Management – Amazon Bedrock AgentCore 是你构建、部署和管理 AI agents 的地方。它支持任意模型或供应商组合,包括同时来自 Amazon Bedrock 和 SageMaker AI 的模型,因此团队能设计出「为每项任务挑对模型」的 agents,而不被锁死在单一供应商上。
Agentic Solutions – 全栈顶端是开箱即用、专门打造的 agents。Kiro 用 spec-driven development 帮开发者一次就交付正确的东西。AWS Quick 把你的应用、工具和数据连成一张会学习你工作方式的个人 knowledge graph。Amazon Connect 提供面向客户体验、招聘、供应链和医疗的 agents。AWS Marketplace 让你用上合作伙伴构建的 AI 方案。
Security, Governance, and Cost Optimization 贯穿 AI 全栈的每一层。它们被建进地基里:芯片层有硬件级隔离,上面有强制规定「agents 能访问什么、能做什么」的控制。
re:Invent 上以 AI 为主的 session 覆盖整条全栈。无论你是在评估 AI 芯片、在生产里服务模型、构建自定义模型、部署 agents,还是采用开箱即用的方案,本指南都帮你找到最要紧的那些。用它排出一张更聪明的 re:Invent 日程。
artificial intelligence and machine learning(AI/ML)track 主要聚焦全栈里的三个核心层:AI chips、models, training, and inference,以及 agent development and management,并把 security, governance, and cost optimization 编织进始终。下面几节从芯片层起步,向上走过模型与 agents,然后是几场把全栈串起来的 session。指南最后收在其它相关话题上,比如可持续性,以及你跑 AI 工作负载所在的基础设施。每一节内部,适合新手的 session 排在前,技术深挖排在后。
想直接跳?跳到你关心的话题:
AWS AI platform sessions AI chips: NVIDIA GPUs and AWS Trainium Amazon SageMaker AI sessions Build and run AI applications and agents with Amazon Bedrock Build AI that works with documents, voice, and images Building trust in AI agents Other topics Plan your re:Invent
AWS AI platform sessions
这些 session 把核心 AWS AI 服务放在一起讲:Amazon Bedrock、Amazon SageMaker AI、Amazon Bedrock AgentCore,以及承载它们的 AI 芯片。它们帮你做出「用量涨上来之后依然成立」的架构选择。
刚接触 AWS 上的 AI?从 AIM204 起步。它走一遍整条全栈:你会看到 Trainium 与 Graviton 芯片、Amazon Bedrock 与 SageMaker AI 上的模型推理,以及 AgentCore 上的生产 agents。如果你已经在构建了,试试 AIM364。它帮你在 Amazon Bedrock 与 SageMaker AI 之间做选择,也讲什么时候两者都用。例子是一个跑在 AgentCore 上的真实 agentic coding 应用。
另一些 session 深挖具体的生产问题。如果你负责数据战略,去 AIM363。这场 chalk talk 展示受治理的数据产品如何喂给定制、推理和 agents,也解释为什么 prompt caching、distillation 和 batch inference 这类成本杠杆在干净数据上效果更好。需要证明 AI 的价值?AIM319 越过成本看业务影响。一场贯穿 AI 全栈的现场演示,展示如何衡量 return on investment(ROI)并比较「每个结果的成本」。
有经验的构建者该看 AIM443。在这场 400 级 chalk talk 里,你在 Amazon SageMaker HyperPod 上搭一条训练流水线,引入公司数据并保持治理到位,随后把同一个模型部署到 Amazon Bedrock 做推理、或部署到 AgentCore 做 agents。
AI chips:NVIDIA GPUs 与 AWS Trainium
训练和推理上,AWS 给你两类主要 AI 芯片:NVIDIA GPUs 与 AWS Trainium。从你今天在用的那个起步,再探索另一个。
NVIDIA GPU sessions
AWS 提供大量带 NVIDIA GPUs 的 Amazon Elastic Compute Cloud(Amazon EC2)实例。这些 session 展示如何安全、可靠地在上面跑 AI 训练和推理。
从 AIM2210 了解 GPU 实例的最新进展。在 AIM3301 里,一位客户分享它如何通过优化 GPU 调度把 GPU 容量用到极致。AIM392 讲什么时候 EC2 G7e 和 G7 实例适合替代 P-series 实例。想用自管 agents 调 AI 基础设施?加入 AIM346。
如果你偏爱动手学,试试讲 disaggregated inference serving 的 AIM345。在 AIM344 里,你找出真实 GPU 集群故障的成因以及怎么恢复。在 AIM347 workshop 里,你可以练 GPU 性能工程。
数据处理方面,见 AIM3312。它展示 Amazon EMR 配上给 Apache Spark 用的 NVIDIA cuDF plugin,如何在不改代码的前提下、在 EC2 G7 实例上把作业跑到同类 CPU 实例的 3.7 倍。这场 session 也讲 GPUs 上的 DuckDB。
AWS Trainium sessions
AWS Trainium 是专为下一代深度学习训练与推理打造的一族 AI 芯片,以更低成本交付高性能。Trainium 跑在 AWS Neuron 上——这套软件栈把 Trainium 接到 PyTorch 等熟悉框架上,因此团队无需重写就能构建。采用基于 Trainium 的 Amazon EC2 实例的客户,可能得到优于同类实例的性价比。
Trainium 新手请从 AIM211 起步。它从 silicon 一路走到应用,把整条栈梳理一遍。想看最新系统,AIM310 展示 Trainium3 与 Trn3 UltraServer 如何让大型 mixture-of-experts 模型保持性能。如果你还在评估要不要迁到 Trainium3,AIM2213 panel 请来四位已经用 Trainium 交付过真实产品的 AI 领导者。
好几场 session 是按具体角色设计的。整天泡在 PyTorch 里的科学家和研究员,把问题带到 AIM339 这场 nanochat code talk,然后再去 AIM334 分布式训练 workshop 动手。ML 工程师和开发者可以在 AIM349 里用 Hugging Face 模型架构一个生产级 AI assistant,并在 AIM326 workshop 里动手做推理扩缩容。追峰值吞吐的性能工程师会想要讲 agentic optimization loops 的 AIM329,接着是 INV511——一场为认真做 kernel 的人准备的、深入 Neuron Kernel Interface 的 500 级 session。想在 Amazon Elastic Kubernetes Service(Amazon EKS)上跑 Trainium,AIM311 用白板推演一套在多大两万枚加速器规模的部署里都站得住的韧性栈。若你改用 SageMaker AI 部署,见 SageMaker AI section。
想再往前走的人,world models 是一类新兴模型,为游戏、机器人和自动驾驶里的仿真提供动力。AIM323 是个不错的起点,讲用原生 PyTorch 服务 world models。之后挑一条动手路径:在 AIM304 里,你用 agentic Neuron workflows 部署并优化一个实时视频 world model;在 AIM305 里,你为 physical AI 训练 vision-language-action 模型。两场都是 builders’ sessions。
Amazon SageMaker AI sessions
Amazon SageMaker AI 是 AWS 上用来定制和部署你自己模型的服务。它在一个地方处理整个模型生命周期:你可以在无服务器算力上准备数据、定制模型;需要更大马力时,把训练作业扩到数千枚加速器。模型就绪后,部署到 SageMaker inference endpoints 或 SageMaker HyperPod。模型权重留在你手里,模型跑在哪儿也由你定。
SageMaker AI 新手?从 AIM342 起步。它展示如何用一个服务构建、定制并部署模型。session 之间,顺路去 Builder’s Hub,在三场比赛里试试身手:微调一个 agent、组队参加 Agentic Football Cup,或者教机器人一项新任务。想听机器人、world models 和 physical AI 的最新进展,去 AIM2215 听一场构建者 panel。还在挑模型、或学着写 evaluations?AIM2205 展示如何基于你自己的数据构建 evaluations,也讲怎么把业务知识变成跑起来更便宜的模型。
定制从数据开始。AIM434 workshop 展示如何为自定义模型准备数据集。接着 AIM362 帮你为定制挑对算力。然后在 AIM402 里,几小时内微调并部署一个 large language model(LLM)。客户也会分享经验:在 AIM393 里,Salesforce 讲它如何用开放权重构建并提供 Koa 模型;Intuit 在 AIM361 讲自己的故事。如果你做 agents,AIM325 展示如何用多轮 reinforcement learning 微调会推理的 agents。AIM456 workshop 把 evaluation、fine-tuning 和 reinforcement learning 串成一条流水线,横跨 SageMaker AI 与 Amazon Bedrock。
如果你在做领域专属 AI,应该加入 AIM2205。学怎么在自己的数据上测模型、怎么在质量与成本之间权衡,这场也讲什么时候值得定制模型。在 AIM398 里,看 Forge 背后的团队基于端到端的客户项目,用白板画出一条构建量身定制 AI 方案的快车道:从设对 evaluations、优化 prompts、context 和 inference serving,到选一种在预训练或后训练里改动模型权重的定制路径。准备扩大训练与推理规模时,SageMaker HyperPod 帮你把每一 GPU 小时用得更足。团队拿它做 biology foundation models(FMs)、physical AI、world models 和 sovereign AI 这类专门工作。先从把极限往前推的客户听起:AIM343 里 Tencent Games 讲它如何扩到 1,000 块 GPU;AIM433 里 HUMAIN 展示它如何让训练与推理的 GPU 利用率都保持在高位。
要动手练,在 AIM406 里用 Amazon EKS 搭 foundation model pipelines,或在 AIM403 builders’ session 里用 Ray 调 AI pipelines。AIM435 code talk 教 policy distillation——用一个大模型训出一个小模型。physical AI 团队可以加入 AIM318 workshop,它展示节点故障时如何让 vision-language model 训练继续跑。机器人与自动驾驶团队可以在 AIM413 里,在 SageMaker HyperPod 上建一座 physical AI 模型工厂。
该服务模型时,两场 200 级演讲讲生产里的推理。AIM213 里 CrowdStrike 讲它如何用更少的运维工作量、为威胁检测跑 LLM 推理;AIM214 里 Vanguard 分享它如何在 SageMaker HyperPod 上训练并服务自定义 LLMs。想用快速推理在开放权重模型上建 agents,试 AIM405。要建快速、有韧性的 inference endpoints,加入 AIM404 workshop。平台团队可以在 AIM348 builders’ session 里练受治理的 ModelOps,也能在 AIM408 workshop 里用托管 MLflow 补上可观测性。
用 Amazon Bedrock 构建并运行 AI 应用与 agents
你选的模型与推理方式,决定了 AI 应用能为用户做什么。Amazon Bedrock 给你广泛的模型选择,帮你为每项任务挑对模型;它给你在生产里跑 AI 应用所需的性能、安全与成本控制。有些应用需要用工具和数据、记住上下文、并替你行动。对这类,Amazon Bedrock AgentCore 帮你构建、连接并改进 agents。
Amazon Bedrock 新手?从 AIM220 起步。它讲模型、推理、安全和成本管理上的新东西。随后在动手的 AIM317 workshop 里构建并部署你的第一个 Amazon Bedrock 应用。
接着想清楚你要服务的是哪类工作负载。一个客户支持应用可能需要快速回答;一个大型文档处理作业可能更在意成本、也等得起结果。AIM448 帮你挑适合需求的 Amazon Bedrock inference 选项,权衡性能、容量、成本和数据驻留。若你的应用必须跨公司信息做推理,去 AIM308。在这场 session 里,你构建一个能在文档、图像、结构化数据以及它们之间的关联里找答案的 knowledge assistant。
用量涨上来时,你的推理方案还得保持划算。AIM437 帮你判断何时缓存重复的 context、在模型之间路由请求,或把活儿挪到 batch inference。模型选择也要紧:最新的模型不一定最合适,换模型会改变质量、速度、成本和行为。AIM438 展示如何在你自己的用例上测候选模型,好让你有把握地切换。应用上线后,AIM374 讲带进生产所需的指标、告警和运维习惯。系统专家可以在 INV517 里再深入:这场 500 级 session 看高效大模型推理背后的调度与并行方法。
想构建 agent,就从完整的生产全景起步,别一块块自己搭基础设施。AIM212 介绍完整的 AgentCore 生命周期,Nasdaq 也分享它如何在受监管行业里跑 agents。想要动手路径,试 AIM439:从一个基础的客户支持 agent 起步,逐步加上 memory、工具访问、identity、policies、可观测性和 evaluation,直到它生产就绪。准备设计多 agent 系统?AIM407 用 Strands Agents 协调各司其职的 agents:共享状态、处理故障,并把成果部署到 AgentCore。
agent 跑起来之后,看看底层发生了什么。每一次规划步骤、检索、工具调用和重试,都可能多加一次模型调用,这会改变成本、速度和可靠性。AIM429 把 agent 设计与推理行为连起来,帮你想透 context、harnesses、目标,以及 agent 何时该停。想在代码里看到这些取舍的开发者,接着去 AIM454:那场现场构建 function calling、多步推理和检索。
当 agents 服务更多用户、触达更多系统,赌注就变大了。把扩缩容问题带到 AIM436,在那里推演流量尖峰、工具故障、模型超时和多租户。跨整个公司管 agents 的平台团队该去 AIM303,它讲怎么发现 agents、控制工具访问、管理 identity,以及看清整个机群。若你的首要任务是把「用户请求到 agent 动作」之间的每一步都护住,就配上 AIM370。然后用 AIM440 把生产 traces 和 evaluations 变成一套稳定改进 agent 质量的办法。
最后,挑一场长得像「你想让 agent 干的活」的 session。AIM340 跟着 PepsiCo 的会话式下单 agent,展示 memory、公司 API 和控制如何在一个面向客户的工作流里协同。AIM369 聚焦那些响应业务事件、把流程跑到底、并在需要处加人工批准的 agents。软件团队可以在 AIM416 里动手:在那里,coding agents 离开笔记本,在 AgentCore 上跑长时、并行的工作流。
构建能处理文档、语音和图像的 AI
AI 应用往往要处理的不止文本。这些 session 展示如何在 AWS 上构建这些能力,并补上 grounding、evaluation 和校验,让你的应用在真实使用里站得住。文档处理从讲 Amazon Textract 的 AIM216 起步;随后在 AIM442 里搭一条把文档变成可核对结构化数据的流水线。做语音应用?AIM217 介绍 Amazon Polly 和 Amazon Transcribe,AIM218 探索用 Amazon Nova Sonic 做会话式 AI。想深入,去 AIM356 code talk,或在 AIM352 里构建并部署一个 voice agent。
在 AIM357 里构建跨模态搜索。要提质量,在 AIM350 里加 web grounding,在 AIM351 里加自动化 evaluation。你也可以在 AIM355 里用 Amazon Rekognition 探索身份验证。
建立对 AI agents 的信任
AI agents 如今做着实打实的工作,比如批准理赔、发放退款、对客户数据采取行动。团队需要一种方式去信任这些 agents 的所作所为,并向别人证明它。这从 responsible AI 起步,它帮组织在「AI 系统该如何设计、构建和运行」上做审慎选择。AWS 在此之上提出 Trust in Depth:一套给 agents 更多自由、又不失控的方法。
AI 信任的新手,从 AIM2216 panel 起步。它讲如何在 agent 生命周期的每个阶段建立信心,话题包括让 agent 只干自己那份活、以及精确看清它做过什么。想看 responsible AI 治理落地,去 AIM391:它展示 John Deere 如何用 AI Risk Intelligence 把周期性的人工评审换成持续、自动化的治理,这项改变把评估时间砍掉了 30% 以上。
好几场 session 是按具体角色设计的。开发者可以加入 AIM336 workshop,审计一个多 agent 理赔系统里的 responsible AI 缺口,随后修掉发现的问题,并写一份有证据支撑的报告。风险、合规和数据科学团队可以加入 AIM332。这场 chalk talk 讲怎么测 agents 在批贷款或发退款时是否公平待人:你学会挑 fairness metrics,并在影响人生活的结果里抓出偏见。你的 agents 会决定保险资格这类事吗?AIM335 workshop 展示如何把那些决策背后的规则变成 Amazon Bedrock Guardrails 里的 Automated Reasoning checks,于是每个决策都能被证明正确、被审计。
想更深看这门科学,几场专家 session 讲 automated reasoning。INV508 展示领域专家如何把法律法规政策变成机器可校验的规则,无需写代码,这些规则随后充当 AI guardrails。INV526 看今天关于 agent 行为能证明什么、边界又在哪。AIM451 chalk talk 展示如何强制agents 绕不过去的规则,也讲如何让人类留在那些不该由机器独自做的决策里。
其它话题
还有几个 track 补齐你的 re:Invent 规划,从可持续性到你把工作负载跑在哪儿。
AWS Sustainability
AWS 持续在数据中心、芯片和 AI 服务上创新,让它们更高效、更可持续。AWS 也给你数据和工具,去衡量、追踪并降低你自己跑在 AWS 上的云与 AI 工作负载对环境的影响。这些 session 讨论我们如何让基础设施更高效,并展示如何在达成业务目标的同时,按可持续性数据采取行动。想了解 AWS Sustainability 服务的最新进展,去 AIM201。这场 lightning talk 讲碳之外新增的影响维度、更细的数据和 API 访问。在 AIM205 里,了解 AWS 如何让 AI 基础设施更可持续:它用低隐含碳的硬件、高能效的定制芯片,以及由 machine learning(ML)调优的数据中心。想弄清碳数据背后的方法?加入 AIM321 chalk talk。它展示如何用这些数据构建足迹更小的 AI 工作负载——这类负载往往还更便宜。
如果你偏爱动手学,试 AIM320。你用 Amazon Bedrock 搭一条生成式 AI 流水线,把杂乱的公司数据变成可持续性洞察。这场 session 取材于 AWS 如何对其数据中心做 life cycle assessment。想再深入,加入 AIM412:它用 Amazon Neptune 和一个 Amazon Bedrock agent 画出利益相关方之间的依赖关系,随后你在 knowledge graph 上试各种减碳办法。
Local Zones 与 AWS AI Factories
随着团队把 AI 推入生产,工作负载「跑在哪儿」和「怎么建」一样要紧。大型训练作业、微调和实时推理,各自对基础设施的要求不同。AWS 给你几个地方跑它们:AWS Regions、AWS Local Zones、AWS Dedicated Local Zones、AWS AI Factories 和 AWS Outposts。从 HMC303 起步。它按驱动选择的四个因素比较这些选项:时延、data sovereignty、算力密度和规模。Databricks 分享它如何在部分 Local Zones 里用 GPU 容量,T-Mobile 讲对时延敏感的分布式推理。
在 HMC307 里,看 Netflix 如何从 Los Angeles Local Zone 支撑其视觉特效与动画团队。Netflix 按需即时启动带 NVIDIA RTX PRO 6000 GPUs 的 Amazon EC2 G7e 实例,这样艺术家在需要时就能拿到 ComfyUI 环境。
两场动手 workshop 走两条不同的「在边缘建 agents」路径。HMC402 走托管路线:把 AWS Region 里的 Amazon Bedrock AgentCore agents 连到混合与边缘位置上的工具和 agents,用 Model Context Protocol(MCP)和 agent-to-agent(A2A)通信。HMC403 走自管路线:跨 Local Zones 和 Outposts 设计、搭建并调优你自己的 agents。随后在 HMC401 code talk 里,学如何在边缘用 NVIDIA Run:ai 编排 fractional GPUs。
有些组织完全没法把 AI 工作负载挪到公有云:data sovereignty、data gravity 或时延都可能挡路。AIM206 展示 AWS AI Factories 如何把 AWS 与 NVIDIA AI 基础设施带进你自己的数据中心,由 AWS 替你运行和更新。看组织如何在本地、在完全掌控自己数据的前提下,跑领先 foundation models 做训练和推理。
规划你的 re:Invent
用这份指南排出日程,然后尽早在 event catalog 里订座——热门 session 很快满。小技巧:若线上 session catalog 显示已满,我们建议先把该 session 收藏,再直接走到场地碰碰运气,看有没有空出多余位置。还有其它活动能让你了解 AWS AI/ML 产品。
逛 AI kiosks
session 之间,顺路去 Venetian Expo Hall 里 AWS Village 的 AI kiosks。每个 kiosk 由专注上述话题的 AWS 专家值守,包括 product managers 和 solutions architects。他们全天回答你的问题、帮你想透用例、并做演示。逛 AWS Village 时,来看看这些 kiosks:
Amazon Bedrock。 Amazon Bedrock AgentCore。 Amazon Foundation Models。 Speech AI。 Accelerated Computing。 Strands Agents。 AI League。 Amazon SageMaker AI。 Global Infrastructure & Sustainability。 Hybrid Cloud & Edge Computing。
试试 activations
你也能在四个互动体验里动手,它们同样在 Venetian Expo Hall 的 AWS Village:
AWS Quick: 看看 AI agents 加入日常运营后,工作会怎么变。在三个现场演示台之一看 solutions architects 现场演示 Quick,或在三个自助台之一自己走一遍演示。你还能用触屏 knowledge graph 探索 re:Invent 的内容和 session。 Galactic Agents: 在四个 builder stations 之一坐下,组建一支五人 AI 船员班底,再发射你的星舰。整整一周里,哪怕你在听 session,你的船员也会独自在一片共享星系里持续探索。每名 officer 都对应企业在用的一种真实 agent pattern。一张巨大的实时星系图和一次「掀开盖子看底层」,展示如何在 AWS 上跑你能看着、也信得过的 agents。好奇游戏怎么做的?去 SME desk 找专家聊。 Security at Machine Speed: 在两张桌子之一玩触屏桌面游戏。你守护自己的云,每部署一项 AWS 安全服务就得分。玩完去附近的安全 kiosks 深聊。 AWS Cloud Infrastructure: 别错过 AWS Village 的基础设施体验。看 AWS Cloud 背后的硬件,它建在 20 多年的云基础设施创新之上。一面芯片墙展示 AWS Graviton、AWS Trainium、AWS Inferentia 和 AWS Nitro Cards 的每一代。触屏讲解这些芯片如何与合作伙伴芯片配合,服务于 agentic AI、训练和推理。近距离看 Trainium 与 Graviton 的服务器托盘和机架,了解它们如何借 Elastic Fabric Adapter(EFA)和 Amazon EC2 UltraClusters 横向扩展。随后探索一个 AWS AI Factories 的 3D 模型,看 AWS 如何把基础设施带进你自己的数据中心。逛完 AI chips、AWS AI Factories 和 Local Zones 的 session 后,这里是很顺的一站。
来不了 Las Vegas?实时看 keynotes,之后在 AWS Events YouTube channel 补 breakout sessions。希望 re:Invent 2026 见到你。
关于作者