在线AI教程 / AI上云
[OpenRouter] RAG 中的重新排名:如何使用重新排名器修复错误检索
RAG 中的重新排名:如何使用重新排名器修复错误检索 开放路由器 ·11/13/2026 当 RAG(检索增强生成)应用程序给出错误答案时,即使文档中包含正确信息,检索通常就是原因
RAG 中的重新排名:如何使用重新排名器修复错误检索
开放路由器 ·11/13/2026
当 RAG(检索增强生成)应用程序给出错误答案时,即使文档中包含正确信息,检索通常就是原因。矢量搜索非常适合查找正确主题的块,但它经常会出现侥幸心理,例如当用户询问增长计划时,会拉动企业计划的存储桶限制。 RAG 中的重新排名解决了这个问题,方法是获取向量搜索的前 30 个候选者,并将它们传递给专用的跨编码器模型,该模型直接针对问题对每个块重新评分。
在 274 个问题的基准测试中,使用 google/gemini-embedding-2 的标准矢量搜索在 81% 的时间内准确地找到了最正确的块。添加 voyageai/rerank-3-lite 对前 30 名进行重新排名,将其提升至 97%,每 1,000 个查询大约需要 0.10 美元。请记住,这是在小型合成数据集上进行测试的,因此您的实际收益将取决于您的文档,但下面的工作流程将帮助您衡量自己的基线。
TL;DR Retrieve about 30 candidates, rerank them, and send the top 3 to the LLM. voyageai/rerank-3-lite and voyageai/rerank-3 were the most accurate dedicated rerank models and the cheapest of all 11 rerankers, at $0.10 and $0.26 per 1,000 queries. An LLM reranker (openai/gpt-6-luna) put the right chunk first for 99.6% of questions, but each call took 4.0 seconds against 1.3 for a rerank model. The cheap voyageai/voyage-4-lite plus voyageai/rerank-3-lite reached 96.7% precision@1, against 81.0% for the more expensive google/gemini-embedding-2 alone. Set input_type on embedding calls. Leaving it out costs 7 to 12 points of precision@1. cohere/rerank-v3.5 reads only the first 4,096 tokens (4K) of a document and gives no error.
为什么 RAG 检索到错误的块?
标准向量搜索很困难,因为嵌入模型在看到用户的问题之前将整个块压缩为单个向量。如果 130 个字的块解释存储桶限制,则特定计划名称仅是整个块中的一两个字。因此,入门计划、增长计划、规模计划和企业计划的向量在向量空间中彼此重叠,并且检索器可以轻松地将错误的计划排在第一位。
为了在不依赖主观评分的情况下测试检索准确性,我们为名为 Fernbank 的虚构存储服务构建了一个受控数据集。该语料库包含 274 个块,涵盖文档、错误代码、SDK 指南、变更日志条目和噪音,包括未答复的论坛帖子和旨在捕获幼稚关键字和向量匹配的支持票证。我们使用 anthropic/claude-sonnet-5.5 从一组固定的事实生成每个块,并使用脚本对其进行检查。一个单独的模型 openai/gpt-6.1-sol 编写了这些问题。因为每个问题都映射到一个正确的块,所以我们可以在不进行判断的情况下对检索进行评分。
在完整的测试集中,问题是“我可以在增长计划的单个 Fernbank 账户中创建多少个存储桶?”。 google/gemini-embedding-2 将 Starter、Enterprise 和 Scale 计划块排名为 1、2 和 3。未答复的论坛帖子排名第四,实际的增长计划答案排名第五。如果您的 RAG 管道仅将其前三名候选人发送给 LLM,则该模型甚至永远不会看到正确的文档。
重新排序器通过使用交叉编码器架构来解决这个问题。它不是单独评估文档,而是与每个候选块一起处理用户的问题。对于实时查询来说,在数千个文档中运行交叉编码器太慢,因此矢量搜索充当快速检索器,在重新排序器对其进行排序之前将字段缩小到候选列表。
如何将重新排序器添加到 RAG 管道中
您不需要替换现有的嵌入搜索。将其保留为第一个检索阶段,增加其返回的候选者数量,并在将最终结果传递给LLM之前添加重新排名调用。
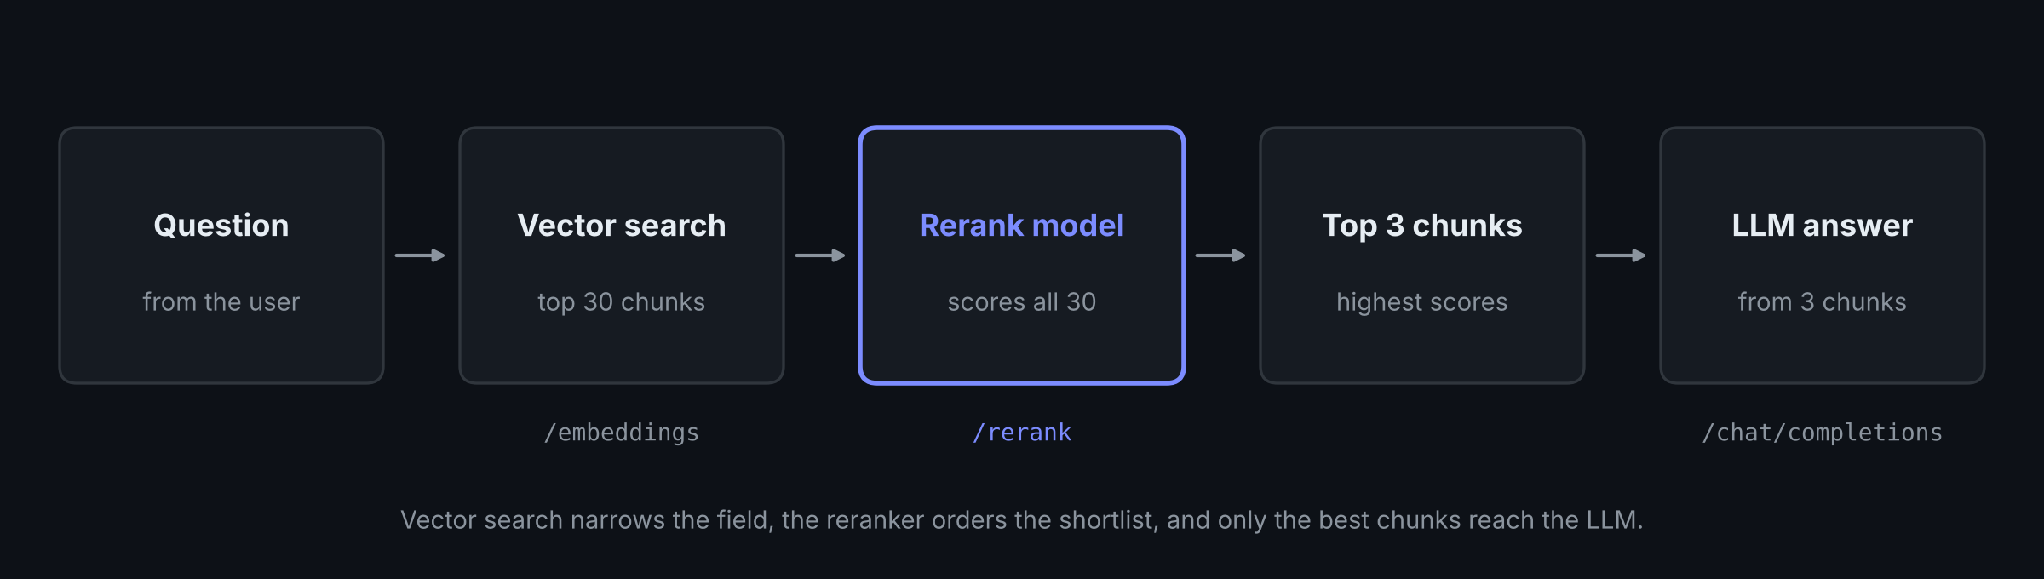
检索 30 个带有嵌入的块,对它们重新排序,然后将前 3 个发送给 LLM。
以下 Python 示例使用我们的嵌入和重新排序 API。它使用余弦相似度检索候选块,使用 voyageai/rerank-3-lite 对它们重新排名,并返回排名最高的三个结果。
您需要一个 OPENROUTER_API_KEY 环境变量,以及安装的 numpy 和 requests。
Python
import os
import numpy as np import requests
API = "https://openrouter.ai/api/v1" HEADERS = {"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"}
def embed(texts, input_type, model="google/gemini-embedding-2"): r = requests.post(f"{API}/embeddings", headers=HEADERS, timeout=120, json={"model": model, "input": texts, "input_type": input_type}) r.raise_for_status() data = sorted(r.json()["data"], key=lambda d: d["index"]) v = np.array([d["embedding"] for d in data]) return v / np.linalg.norm(v, axis=1, keepdims=True)
def retrieve(question, chunks, chunk_vectors, n=30): sims = chunk_vectors @ embed([question], "search_query")[0] return [(sims[i], chunks[i]) for i in np.argsort(-sims)[:n]]
def rerank(question, candidates, top_n=3, model="voyageai/rerank-3-lite"): r = requests.post(f"{API}/rerank", headers=HEADERS, timeout=120, json={"model": model, "query": question, "documents": candidates, "top_n": top_n}) r.raise_for_status() data = r.json() ranked = [(res["relevance_score"], candidates[res["index"]]) for res in data["results"]] return ranked, data.get("usage", {}).get("cost")
Your knowledge base, already split into chunks
chunks = [ "Starter plan limits: an account on the Starter plan can create up to " "10 buckets.", "Scale plan limits: accounts on the Scale plan can hold up to " "2,500 buckets.", "Enterprise plan limits: Enterprise accounts can create up to " "40,000 buckets.", "Growth plan limits: an account on the Growth plan can hold up to " "150 buckets.", "Q: What's the bucket cap on the Growth plan? Reply: I think it " "changed recently, check the docs.", "Growth plan object size: a single object on the Growth plan can be " "up to 50 GB.", ] chunk_vectors = embed(chunks, "search_document")
question = ("How many buckets can I create in a single account " "on the Growth plan?") retrieved = retrieve(question, chunks, chunk_vectors) print("Vector search:") for sim, text in retrieved: print(f" {sim:.3f} {text[:60]}")
ranked, cost = rerank(question, [text for _, text in retrieved]) print(f"Reranked (${cost:.7f}):") for score, text in ranked: print(f" {score:.3f} {text[:60]}")
输出
Vector search: 0.832 Growth plan limits: an account on the Growth plan can hold u 0.758 Starter plan limits: an account on the Starter plan can crea 0.741 Scale plan limits: accounts on the Scale plan can hold up to 0.737 Enterprise plan limits: Enterprise accounts can create up to 0.717 Growth plan object size: a single object on the Growth plan 0.695 Q: What's the bucket cap on the Growth plan? Reply: I think Reranked ($0.0000038): 0.922 Growth plan limits: an account on the Growth plan can hold u 0.793 Q: What's the bucket cap on the Growth plan? Reply: I think 0.727 Starter plan limits: an account on the Starter plan can crea
通过这些简短的一句话块,向量搜索已经将正确的增长计划限制放在第一位。余弦相似度得分范围为 0.695 到 0.832,因此几个候选者相对接近。重新排名后,正确的块的相关性得分为 0.922。未回复的论坛帖子以 0.793 的分数跃居第二位,领先于 Starter 计划条目。
第二个结果说明了一个重要的限制,即相关性与正确性不同。论坛帖子提出了同样的问题,因此重新排名者认为它是相关的,即使它没有回答问题。在这个简化的示例中,重新排序器不会修复第一个结果,因为它已经是正确的。在完整的基准测试中,对于 130 个单词的块,矢量搜索将 19% 的问题(包括增长计划问题)放在前面,并使用 voyageai/rerank-3-lite 进行重新排名修复了大部分问题。
实际经验是向LLM派遣几位实力雄厚的候选人,而不是依赖单一结果。您还应该考虑过滤掉未回答的讨论和其他提及问题但未解决问题的内容。
代码中还有两个值得正确处理的细节:
首先,input_type 参数告诉嵌入模型它是对搜索查询还是文档进行编码。某些模型以不同的方式处理这些输入,因此省略参数可能会损害检索。在我们的测试中,忽略它会使 Gemini 的 precision@1 从 81.0% 降低到 74.1%,而 voyageai/voyage-4-lite 的 precision@1 从 64.6% 降低到 52.9%。请参阅embeddings API 参考,它将它作为字符串并将 search_query 和 search_document 作为其值。 其次,top_n 控制重新排序器返回的结果数量,而不是它评估的结果数量。该模型仍然会对您发送的每个候选者进行评分,因此候选者的数量会影响成本和延迟。
你怎么知道重新排名有帮助?
重新排名器可以改善结果排序,而不必改善用户收到的答案。要确定是否值得添加,请测量更改前后的检索准确性,然后评估最终答案。
- 从 precision@1 开始:第一个检索到的块包含正确答案的问题的百分比。您不需要大量的评估集来开始。应用程序日志中的 50 个真实问题(每个问题都标有正确答案块)可以为您提供初始基线。从生产流量构建黄金评估数据集的指南解释了如何将数据集组合在一起。
- 不要单独依赖recall@5:它衡量正确的块是否出现在前五名中的任何位置,无论其位置如何。在我们的测试中,Gemini 实现了 98.2% 的召回率@5,但只有 81.0% 的准确率@1。正确的信息通常位于结果中的某个位置,但并不总是位于顶部。
我们还测试了对最终答案的影响。我们使用 anthropic/claude-haiku-5.5 使用每个检索配置返回的块来回答所有 274 个问题,然后将响应与已知事实进行比较。
发送给LLM的块答案正确上下文中的正确块 voyage-4-lite 前 5 名,无需重新排名93.1%93.1% gemini-embedding-2 前 5 名,无需重新排名97.1%98.2% gemini-embedding-2 前 3 名,无需重新排名95.6%96.0% gemini-embedding-2 前 30 名,重新排名至第 3 位99.3%100% voyage-4-lite 前 30 名,重新排名至第 3 位99.3%99.6%
我们 2026 年 10 月 8 日的运行有 274 个问题。重新排名使用 voyageai/rerank-3-lite.
结果表明,重新排名有助于LLM在使用更少的块的情况下正确回答更多问题。大多数错误答案都归结为缺少信息。在十分之九的情况下,正确的块不在前三名之内,模型会回答所提供的段落不包含答案。换句话说,该应用程序告诉用户它不知道自己的文档可以回答的问题。
重新排名通过改进到达模型的块来解决这个问题。它还允许我们发送三个块而不是五个,从而将 LLM 的回答成本从每 1,000 个问题 0.22 美元降低到 0.16 美元。重新排名调用增加了 0.10 美元,因此在我们的设置中,每 1,000 个问题重新排名的净成本增加了 0.04 美元。
重新排名是否能为您节省资金取决于您的模型、文档大小和查询量,因此请衡量从检索到最终答案的整个管道的成本和准确性。
哪种重排序模型最适合 RAG?
我们使用 google/gemini-embedding-2 检索到的相同 30 个候选者对 274 个问题中的每一个问题进行了比较 11 个重新排序器。这为我们比较其准确性、延迟和成本提供了一致的基础。
在我们测试的专用重新排名模型中,Voyage 重新排名器提供了准确性和价格的最佳组合。
重新排序精度@1中位秒(我们的设置)每 1,000 个查询 $ 无(仅限嵌入)81.0%不适用不适用 voyageai/rerank-397.8%1.271.27 0.26 美元 voyageai/rerank-3-lite97.1%1.261.26 0.10 美元 voyageai/rerank-2.5-litevoyageai/rerank-2.5-lite96.7%1.501.50 0.10 美元 voyageai/rerank-2.596.4%1.301.30 0.26 美元 cohere/rerank-4-pro95.3%1.541.54 2.50 美元 qwen/qwen3-reranker-8b92.3%1.511.51 1.49 美元 cohere/rerank-4-fast一致/rerank-4-fast92.0%1.251.25 2.00 美元 cohere/rerank-v3.5cohere/rerank-v3.5cohere/rerank-v3.5 90.5%1.471.47 1.00 美元 openai/gpt-6-luna (LLM)99.6%4.010.70 美元 人类/claude-haiku-5.5 (LLM)98.9%4.444.44 0.87 美元 谷歌/gemini-3.8-flash(LLM)100%3.253.25 4.14 美元
我们于 2026 年 10 月 8 日运行。成本是每个响应的使用成本,与 GET /api/v1/ Generation 匹配。每个中位数大约 0.9 秒是我们测试机器的网络开销。
在此数据集上,voyageai/rerank-3 在 97.8% 的时间内将正确的块排在第一位,而 Lite 版本达到了 97.1%。在我们的 274 个问题测试中,这种差异仅相当于两个问题,因此它太小,无法确定更昂贵的型号始终更好。从 voyageai/rerank-3-lite 开始,并在您自己的评估集上将其与 voyageai/rerank-3 进行比较。两者都使用相同的 /rerank 端点,因此切换模型只需要更改模型标识符。
价格差异很大程度上反映了提供商的收费方式,如我们的重新排名模型页面中所列。 Voyage 和 Qwen 按代币计费(每百万份 0.02 至 0.20 美元),而 Cohere 每次搜索最多 100 个文档收取 0.001 至 0.0025 美元的费用,无论文档长度如何。由于我们的 30 个候选者包含大约 5,000 个 Voyage 代币,因此 Voyage 模型特别便宜。在这些短块上,Cohere 的重新排名器成本大约是 Voyage 选项的 4 到 25 倍,具体取决于比较的模型。在我们的测试中,向 Cohere 发送 101 份文档还引发了第二次搜索费用。
对于有关特定错误代码(例如 FB-2411)的问题,重新排序会产生特别明显的差异。仅嵌入搜索在 voyageai/voyage-4-lite 中将正确条目放在第一位的概率仅为 25%,而在 google/gemini-embedding-2 中则为 53.6%。所有 11 名重新排序者在此子集上均达到 100%。由于错误代码条目倾向于讨论类似的错误,因此它们的嵌入可能看起来很相似。交叉编码器可以将问题中的确切代码与每个候选中的代码进行比较,并区分正确的条目。
如果您对开发人员最常用的模型感兴趣,我们的rerank模型排名提供了另一个有用的参考。截至 2026 年 10 月 20 日,voyageai/rerank-2.5 在截至 10 月 18 日的一周内以 468 万个请求领先,在我们的测试中得分为 96.4%。使用流行度值得考虑,但它不应该取代根据您自己的文档测试模型。模型性能、价格和提供商延迟可能会发生变化。 重新排名模型集合 列出了可用选项及其当前详细信息。
您应该对多少文档重新排序?
首先对大约 30 名候选人进行重新排名,然后根据评估结果调整数量。
为了了解候选数量对性能的影响,我们使用 voyageai/voyage-4-lite 检索到的不同数量的候选来测试 voyageai/rerank-3-lite:
候选人重新排名候选人中的正确部分重新排名后精度@1每 1,000 个查询 $ 1010 97.1%94.5%0.035 美元 2098.9%96.4%0.070 美元 3099.6%96.7%0.104 美元 5050 100%97.1%0.174 美元 100100 100%97.1%0.348 美元
我们的运行于 2026 年 10 月 8 日进行,使用了 274 个问题,voyageai/voyage-4-lite 作为第一阶段。
将候选数从 10 增加到 30,将 precision@1 从 94.5% 提高到 96.7%。再次将其增加到 50,准确率达到 97.1%,仅解决了一个问题,同时重新排名成本增加了约三分之二。从 50 名候选人增加到 100 名候选人并没有提高精确度。
重新排名有其局限性,因为只有当第一个检索阶段将相关块包含在候选集中时,它才能提升相关块。如果向量搜索完全错过了答案,则任何重新排序器都无法将其恢复。
对于更大的知识库,使用您的评估集来找到检索更多候选者停止有意义地提高可用正确块的问题百分比的点。与假设每个应用程序的最佳数量为 30 相比,这是选择候选数量的更好方法。
LLM 可以用作重新排名吗?
在我们的基准测试中,基于 LLM 的重新排序器是最准确的,尽管它们返回结果的时间较长。我们没有通过专用的重新排序模型发送每个候选者,而是向聊天模型提供问题和所有 30 个编号的块,然后要求它按顺序返回最相关的块的 ID。我们使用严格的结构化输出模式来确保响应遵循预期的格式。
这两种方法有一个关键的不同之处。专门的重新排序器针对问题对每个候选人进行单独评分。LLM可以一起阅读所有候选人并进行比较,这在多个文档包含相似信息时很有帮助。
在我们的测试中,openai/gpt-6-luna 以每 1,000 个查询 0.70 美元的价格实现了 99.6% 的精度@1,这是 LLM 成本范围的低端,google/gemini-3.8-flash 达到了 4.14 美元。这比专用重新排序器的准确度更高,但在我们的设置中,每次调用大约需要 4 秒,而专用模型大约需要 1.3 秒。
在用户等待答案的交互式应用程序中,额外的时间很重要。 LLM 重新排名可能更适合批处理或检索正确信息尤其重要的应用程序,并且额外的延迟是可以接受的。
请记住,我们的基准测试使用了干净的、模型生成的文本。真实的知识库具有不一致的格式、不完整的文档和其他复杂性,因此我们不能假设 LLM 重新排序器将在更混乱的真实数据上保持相同的优势。
您是否还需要具有混合搜索的重排序器或更好的嵌入模型?
混合搜索和更好的嵌入模型都可以改善检索,但我们的基准测试表明,这两种方法都不如添加重新排序器那么有效。混合搜索将向量相似性与基于关键字的检索相结合,通常使用 BM25。我们将结果与倒数排名融合(RRF)相结合,从而合并了两个排名。
在我们的测试集上,混合搜索将 voyageai/voyage-4-lite 的 precision@1 从 64.6% 提高到 69.3%。然而,在 google/gemini-embedding-2 中,尽管recall@5 有所改善,但 precision@1 从 81.0% 下降至 78.8%。功能更强大的嵌入模型优于更便宜的替代方案。 Gemini 的精度@1 达到 81.0%,而 Voyage 4 Lite 的精度为 64.6%。但 Gemini 的嵌入价格为每百万代币 0.20 美元,而 Voyage 4 Lite 的嵌入价格为 0.02 美元。将更便宜的嵌入模型与 voyageai/rerank-3-lite 相结合达到了 96.7% 的精度@1。
混合搜索和更好的嵌入仍然有用,因为它们执行不同的工作。混合搜索可以帮助检索向量搜索错过的候选者,而更强的嵌入模型可以提高初始排名。重新排序器通过直接将每个候选者与问题进行比较来添加另一层。
为了获得最佳结果,请单独或一起评估这些选项。您可以使用我们的嵌入模型比较来帮助为第一个检索阶段选择嵌入模型。
是什么破坏了重新排名?
当文档超出模型的上下文限制时,重新排名可能会默默失败。例如,cohere/rerank-v3.5 具有 4,096 个令牌上下文限制,因此它可能永远不会看到文档中包含答案的部分。
我们使用两个包含 11,000 个标记的文档对此进行了测试,这两个文档仅在最后一句话有所不同。其中一个包含答案,但两者获得相同的相关性分数:0.2703。该模型实际上忽略了区分它们的细节。相比之下,voyageai/rerank-3-lite 对文档的评分为 0.7812 和 0.3242,正确地将答案排名较高。 Cohere 4 模型、voyageai/rerank-3 和 qwen/qwen3-reranker-8b 也将正确的文档排名较高。检查重新排名器的上下文限制并将块保持在其中。
另一个问题是模型兼容性,因为 /rerank 端点仅接受重新排名模型。向其发送聊天模型 openai/gpt-6-luna 返回 400 模型 openai/gpt-6-luna 不存在,与拼写错误的模型标识符得到的错误相同。在发出请求之前,请检查模型是否出现在重新排名模型集合中。
后续步骤
使用 voyageai/rerank-3-lite 对您的前 30 名重新排名,然后进行测量。 Rerank API 参考:每个请求字段,包括提供者路由。 具有嵌入和重新排名的 RAG:通过答案生成的完整管道。 如何对 LLM 进行基准测试:根据您自己的数据比较模型。
常见问题
RAG 中的重新排名是什么?
RAG 中的重新排名是第二个检索步骤,其中重新排名模型根据问题对向量搜索返回的每个块进行评分并对它们重新排序,以便最相关的少数达到 LLM。重新排序模型将问题和块一起读取,这样它就可以捕获未遂事件,例如错误计划的正确限制。在我们的 274 个问题测试中,它将正确块首先出现的比率从 81% 提高到 97%。
RAG 的最佳重新排序模型是什么?
在我们 2026 年 10 月的测试中,voyageai/rerank-3 和 voyageai/rerank-3-lite 是最准确的专用重新排序模型和最便宜的重新排序器,在 274 个问题中将正确的块放在第一位,分别为 97.8% 和 97.1%。 LLM 重新排名得分较高,但每次调用大约需要 4 秒。
我应该对多少文档重新排序?
对大约 30 个候选者进行重新排名,对于更大的知识库,增加数量,直到正确的块可靠地出现。在我们的测试中,从 30 到 50 将 precision@1 从 96.7% 提高到 97.1%(噪音范围内的一个问题增益),并将重新排序成本增加了三分之二。
## 参考
重新排序 API 参考 和 嵌入 API 参考 重新排名模型 和 重新排名排名 结构化输出