在线AI教程 / AI上云
[Anthropic Claude] 构建永远在线的 agent
过去几个月里,我们看到永远在线的 agent 再度兴起。 永远在线的 agent 是有状态且主动的,也就是说它们会跨会话管理上下文,并在无人直接监督时采取行动。底层它们和其他 ag
过去几个月里,我们看到永远在线的 agent 再度兴起。
永远在线的 agent 是有状态且主动的,也就是说它们会跨会话管理上下文,并在无人直接监督时采取行动。底层它们和其他 agent 跑在同一套核心循环上。区别在于外围架构:它由若干原语构成,用来控制 agent 何时唤醒、两次运行之间延续什么,以及工作成果如何送达用户。
这股回潮主要源于近期模型的进步,让永远在线的 agent 跑起来更切实可行。首先,最新模型判断力更强:理解用户意图、拿捏何时该来确认,都更可靠。其次,智能正变得更便宜,其中长时程任务受益最大。例如,在一项长时程编码基准上,Opus 5.5 每解决一个任务的成本比 Opus 5 低 78%,而在典型工作负载上这一数字是 40%。
已有客户来问我们,怎么把这类体验集成进他们自己的产品。有些公司想让现有的 agent 更主动,另一些则打算从零开始搭建。
这篇文章拆解永远在线 agent 背后的原语,并逐一讲清它们如何配合。
永远在线 agent 背后的循环
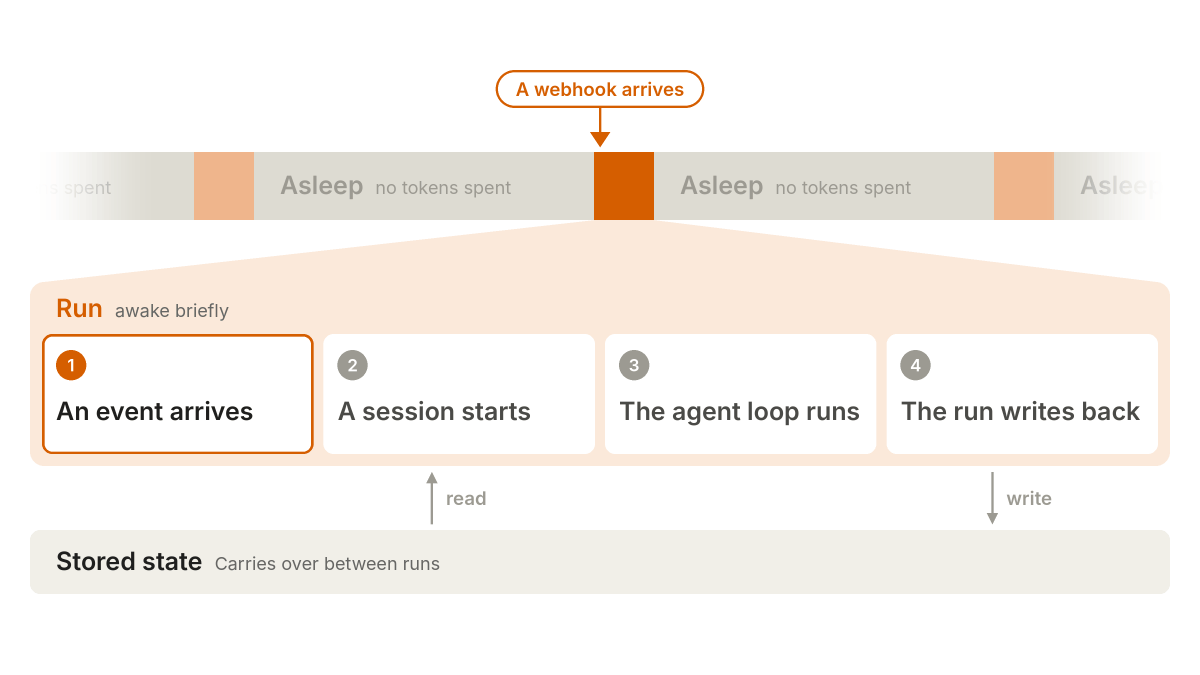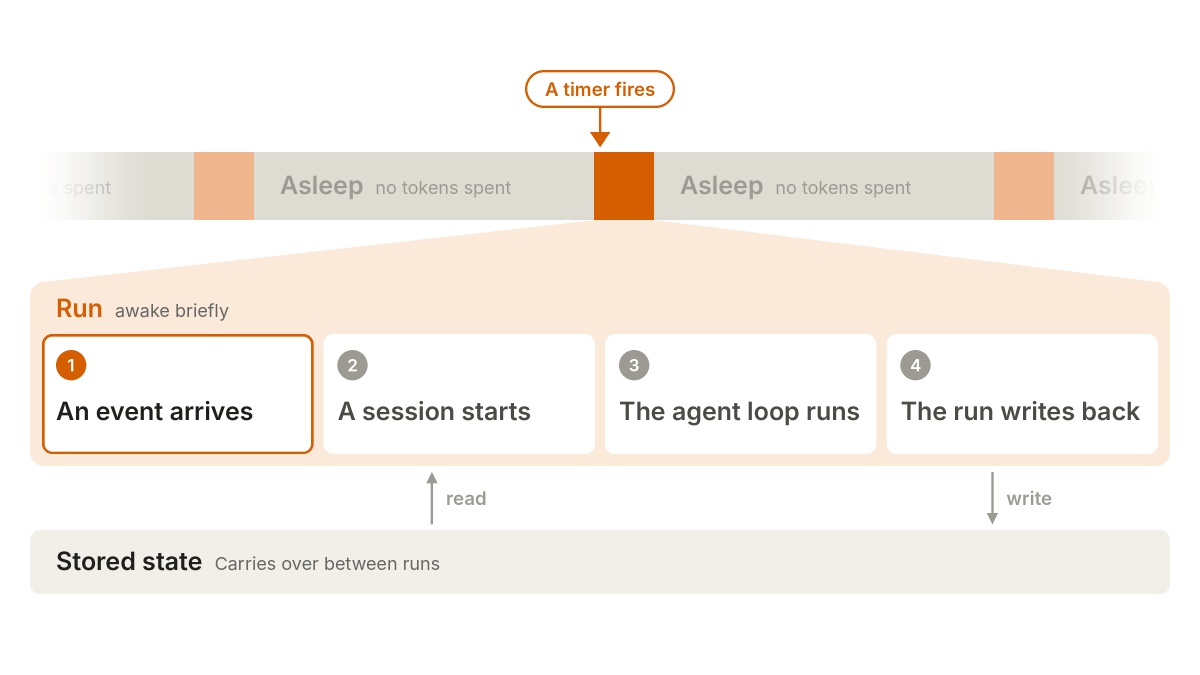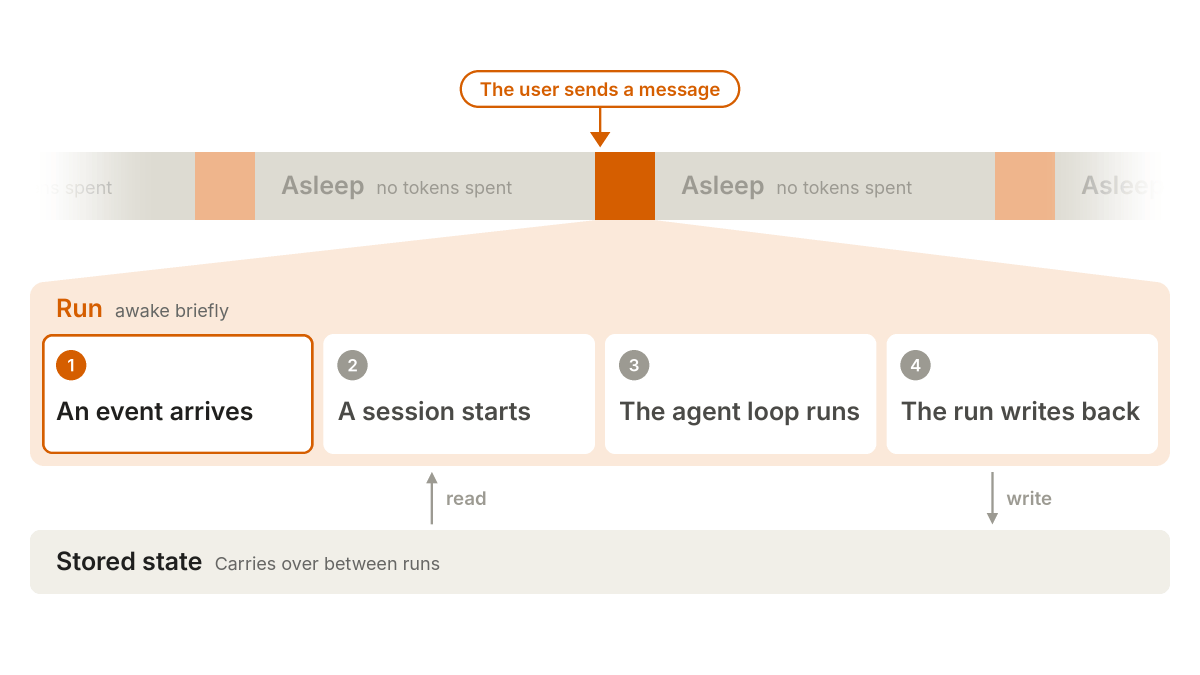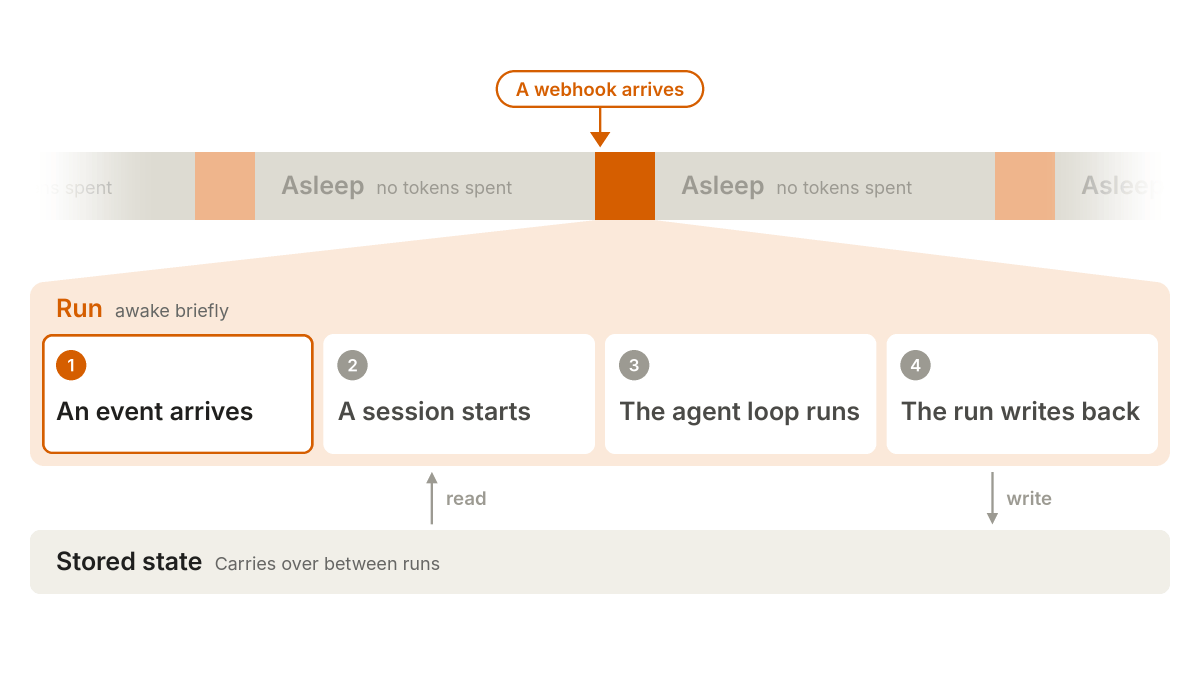
永远在线的 agent 其实并不是真的「一直开着」,这只是对用户体验的描述。
实际上,agent 大部分时间都在休眠,只是周期性醒来干活。每一段工作称为一次运行:agent 接收事件,完成任务,再把发生的事保存下来。一次运行在会话内进行,会话就是消息和工具调用的记录。运行结束后,agent 重新休眠,这个循环无限往复。
核心原语
永远在线 agent 的外围架构有五个核心原语:事件收件箱、计时器、记忆、权限和发件箱。下面逐一来看。
事件收件箱
大多数 AI agent 只在用户发消息时才运行。相比之下,永远在线的 agent 可以由多种事件触发,包括 webhook、定时任务和后台作业。
一个很诱人的做法是让每个事件源直接调用 agent,但这有几处会出问题。比如两个事件同时到达,可能启动互相冲突的运行;一旦崩溃,某个事件就可能整条丢失。
事件收件箱就是为此而来。各来源不直接调用 agent,而是把事件发进收件箱,由工作进程取走。
最简单的版本有三个组件:
一份持久化的事件列表,通常是一张数据库表; 一个处理程序,通常是 HTTP endpoint,负责把事件写进列表;以及 一个工作进程,通常是后台服务,负责从列表读取。
收件箱要跟踪每个事件的状态,并可以依据来源提供的唯一标识符去重。用关系型数据库做收件箱很合适,每个事件追加为一行。我们建议一开始每位用户一个收件箱;需要更高并行度时,可以再拆细。
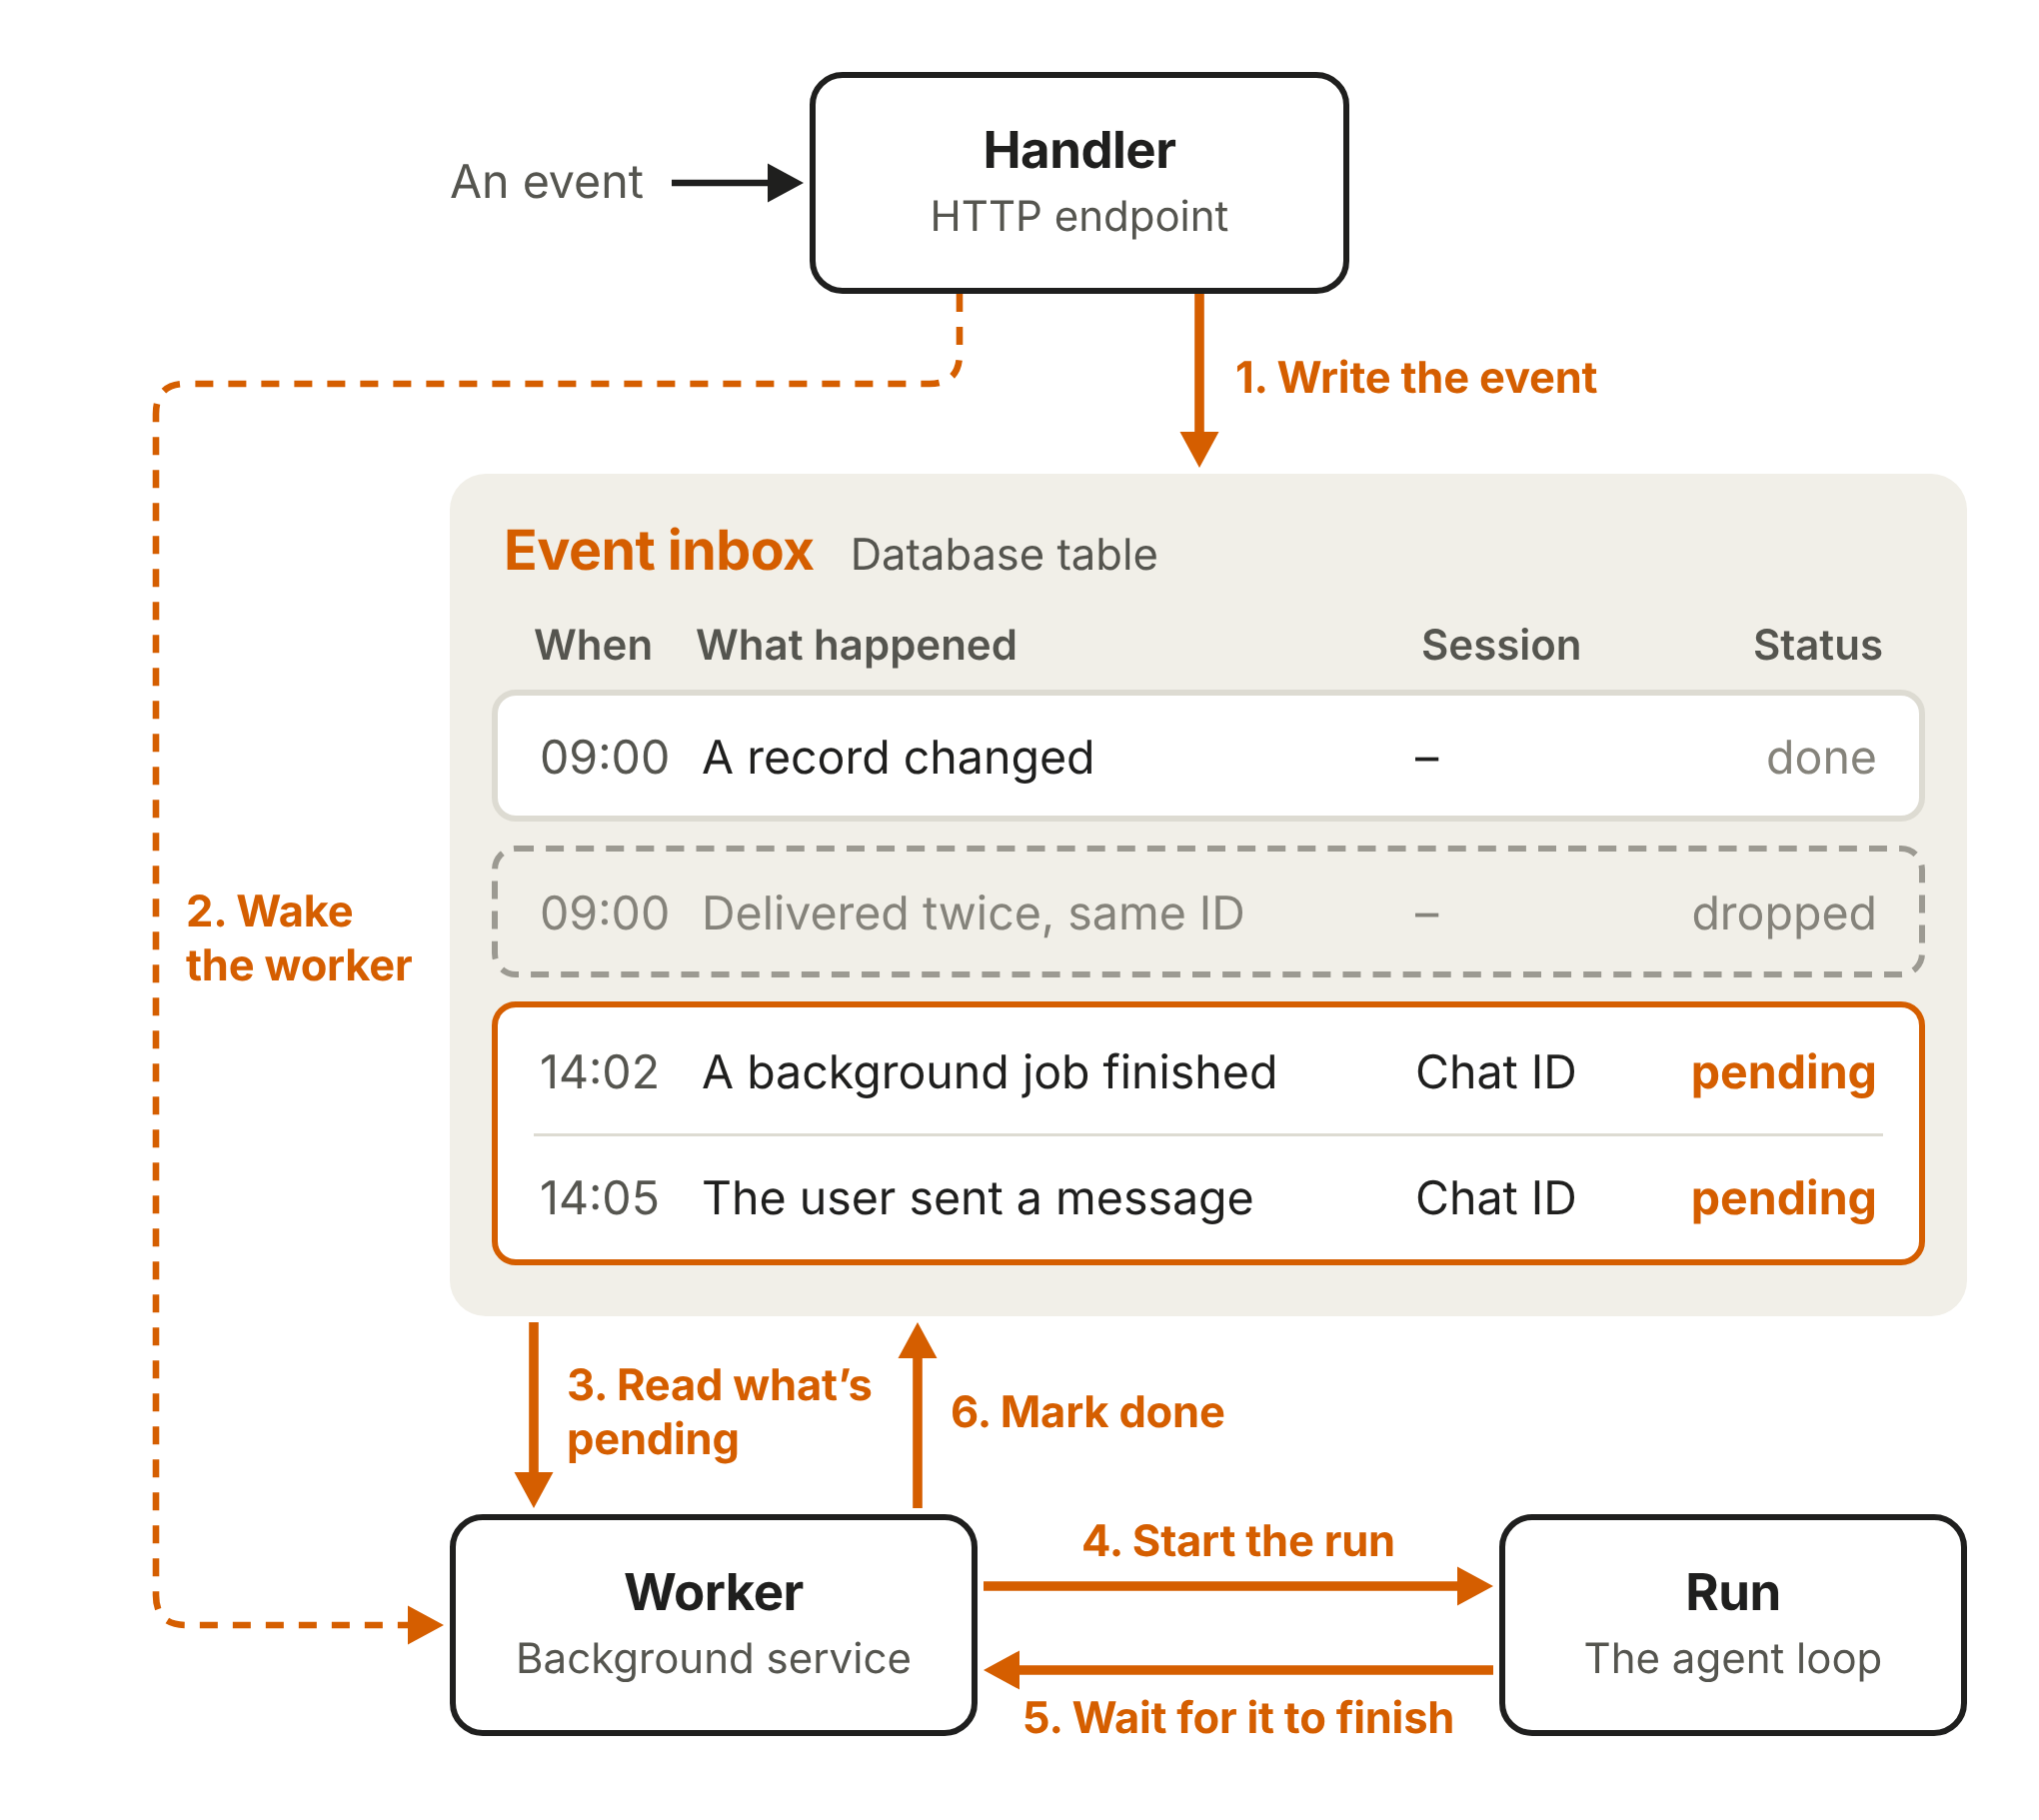
新事件到来时,处理程序把它写进收件箱并唤醒工作进程。工作进程读取所有待处理事件,启动一次运行。延续此前工作的事件(例如用户的回复)会恢复已有会话,其余事件则开启新会话。
随后工作进程把事件交给 agent 循环,等运行结束,再把对应事件标记为已完成。实现细节会有些棘手,这里给几条最佳实践:
处理程序应尽快确认事件。有些来源(例如 webhook 提供商)会把响应慢当成失败。处理程序仍可做一些轻量检查,但更深一层的校验(比如检查 prompt injection)应放到运行期间做。 收件箱应当是唯一事实来源。工作进程被唤醒后,应先从收件箱拉取最新事件。这样即便工作进程在运行中途挂掉,新的工作进程也能接手同一事件重试。 一个收件箱同一时刻只能有一个活跃工作进程。这能避免两次运行重复劳动或互相覆盖。运行中途来了新事件,你可以把它推到下一次运行、并入当前运行,或者中断后重启。 工作进程应把待处理事件成批处理。 比如用户连发几条消息,工作进程可以把它们合并成一次运行,agent 只需回复一次。
计时器
计时器与事件收件箱配合,让永远在线的 agent 能主动行事。计时器大致分两类:跟进和排期。跟进是 agent 给自己设的截止时间,比如回头确认有没有收到回复;排期则是按固定节奏重复的任务,比如每日通讯。
计时器放在自己独立的持久化存储里,通常是另一张数据库表,与收件箱分开。收件箱只保存已就绪、可以处理的事件。跟进和排期可以共用相近的 schema,但排期还要额外记录重复规则。
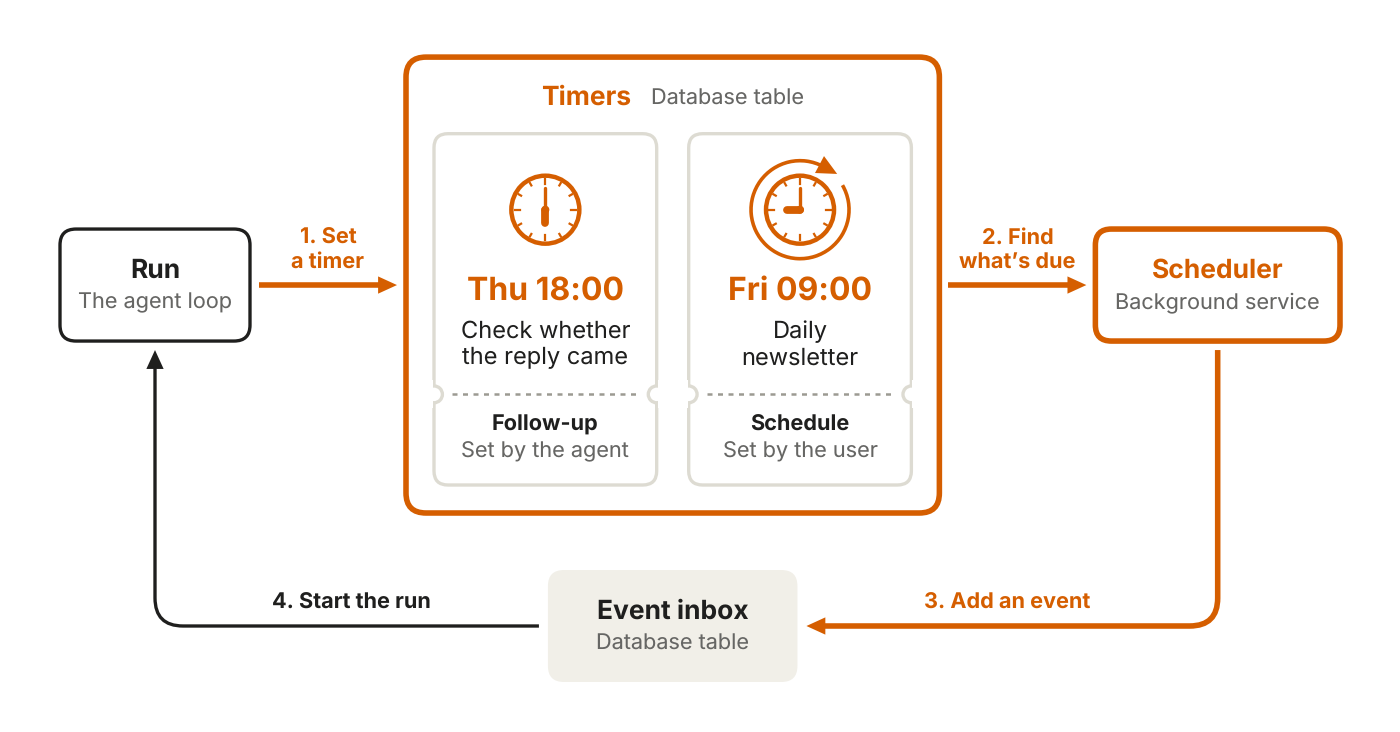
计时器自己不会启动运行。取而代之的是调度器(通常是后台服务),它按固定间隔轮询这份存储,触发所有到期的计时器。每一轮里,调度器会:
扫描存储,找出到期的计时器。 按类别更新每个计时器。跟进应标记为已完成。排期应把到期时间更新到下一次发生。 往收件箱加一个事件并唤醒工作进程。
调度器可以自己搭一个服务,也可以直接用持久化执行引擎。
记忆
永远在线的 agent 要跨许多彼此断开的运行来工作,靠记忆维持连贯性。
和事件收件箱、计时器一样,记忆也该有自己的存储。在我们的产品里,比如 Claude Code 的自动记忆和 Messages API 的记忆工具,它被实现成一个文件目录。对永远在线的 agent 来说,这些目录应映射到持久化存储,通常是数据库或对象存储。这样记忆就能比工作进程活得更久。
一条经验法则是:记忆只存 agent 无法再查到的东西。如果某样内容已经存在于别的系统里(比如问题跟踪系统),那就只存一个指针。下面是永远在线 agent 该存的几类记忆:
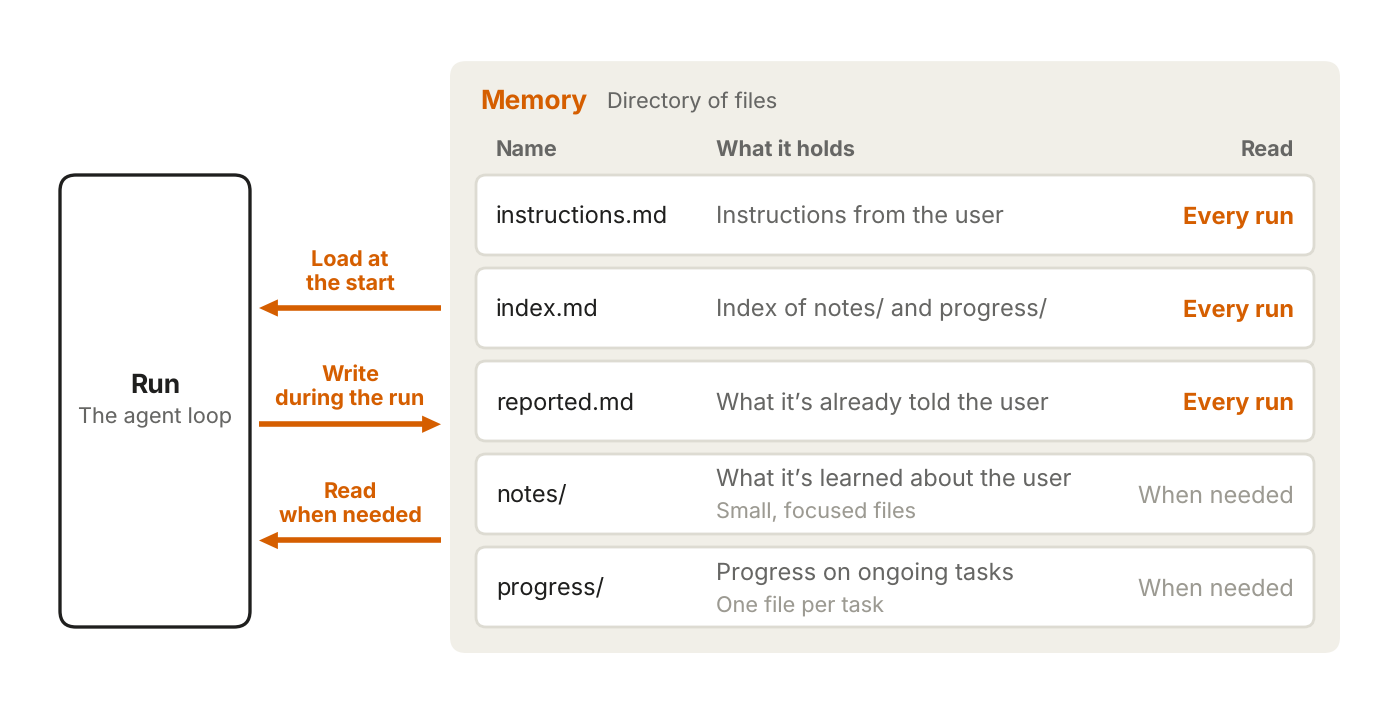
用户指令: 用户对 agent 行为的任何要求都应单独存成一个文件,并在每次运行开始时加载。用户不可能一直在场指挥 agent,所以这些指令必须在运行之间延续。 用户笔记: agent 应把了解到的用户信息存下来,比如角色、偏好,或者用户给过的更正。可以先用一个文件,笔记多了再拆成几个小文件。后一种情况下,每次运行开始只加载一份索引,但 agent 需要更多细节时可以把单个文件拉进上下文。 历史消息: agent 应记下已经对用户说过什么,避免重复。可以单独存一个文件、每次运行开始时加载,也可以让工作进程加载 agent 与用户最近几条消息。 任务进度: 对每项进行中的任务,agent 应维护一份进度文件,写清已完成和待完成的部分。这样任何新运行都能读到它,从上次停下的地方接着做。和用户笔记类似,每次运行开始只加载一份索引,agent 需要更多细节时再把单个文件拉进上下文。
下图展示了一种示例配置。
上面说的都是在运行期间保存的记忆。你还可以加上 dreaming,让它回看过去的会话、整理记忆。dreaming 能替换过时的条目,也能找出只在多次运行里才显现的规律。想深入了解的话,我们那篇关于 agent 记忆的文章讲得更细。
上下文窗口内部
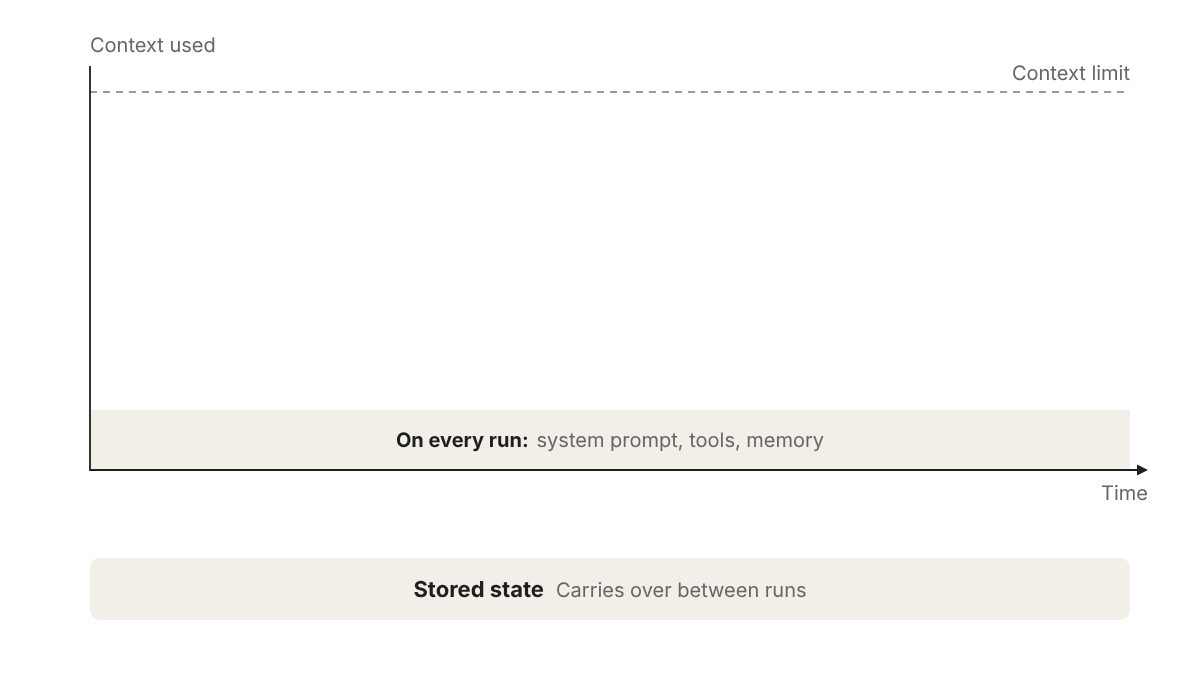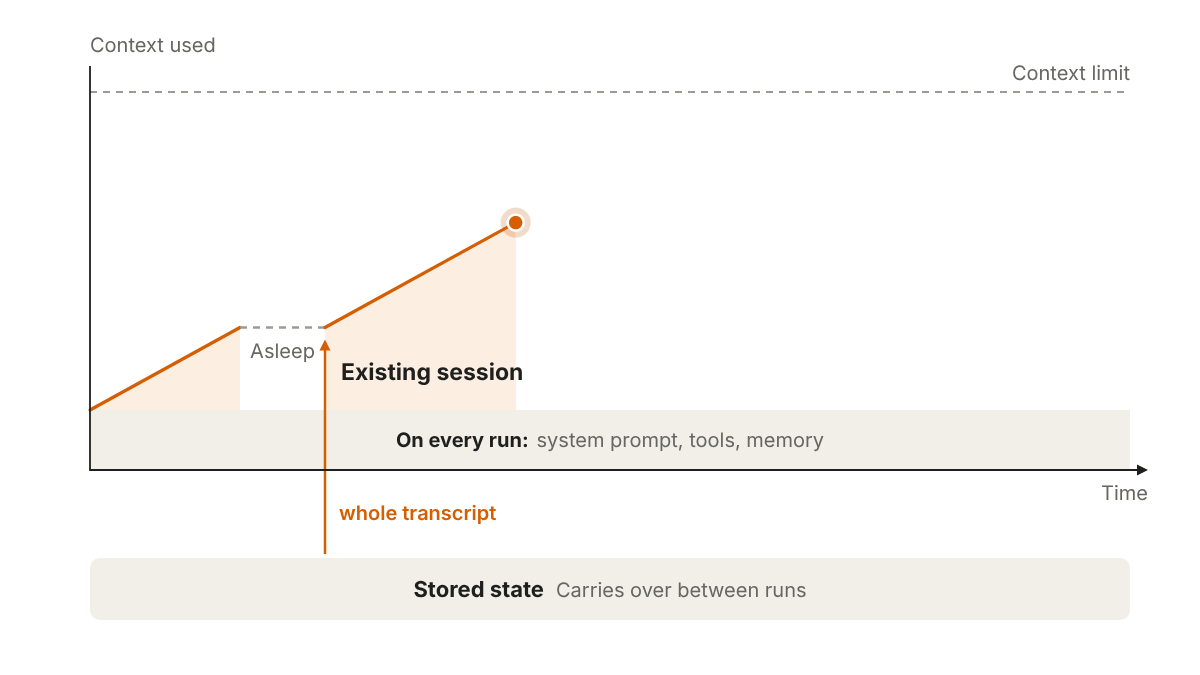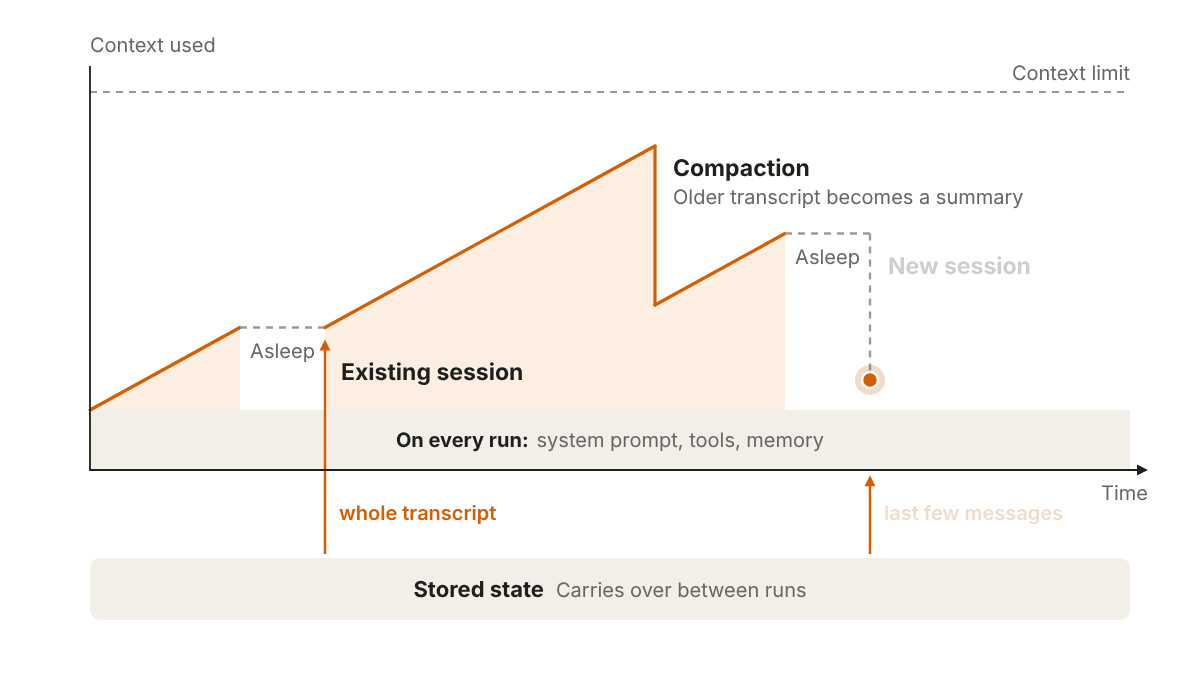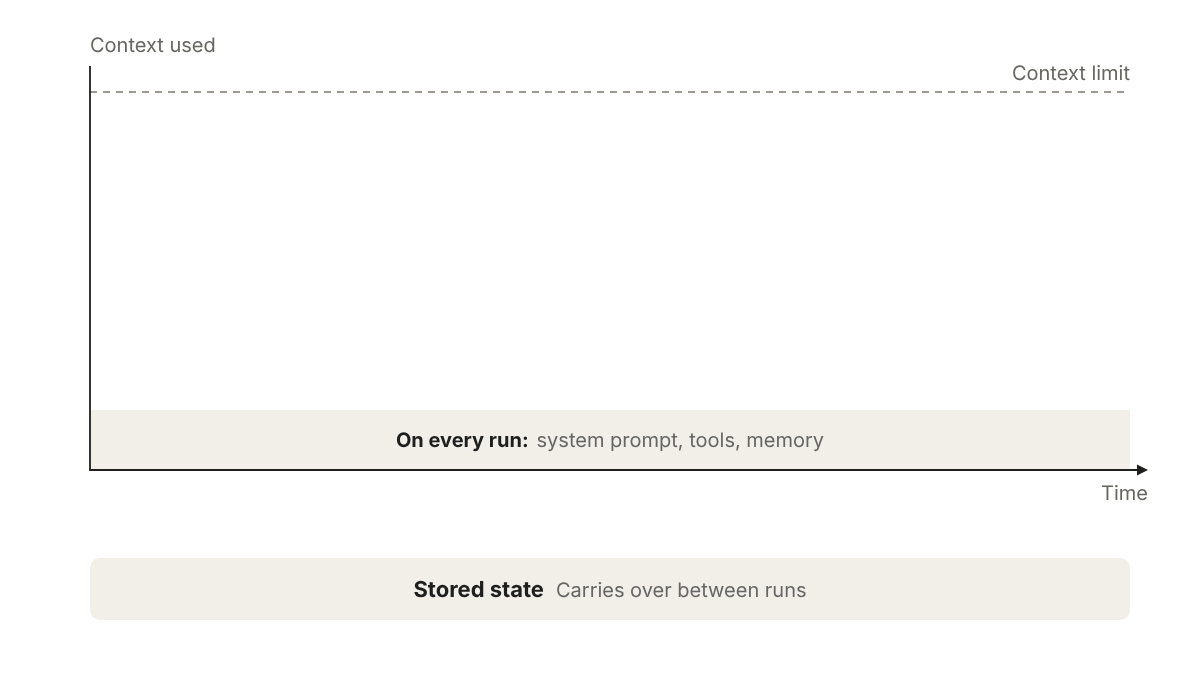
开始干活前,agent 会加载系统 prompt、工具定义和记忆文件。这份初始上下文的「开销」每次运行都算在内,所以我们建议让它保持精简,并用 prompt caching 降低成本。
新会话启动时只有这份上下文开销和触发本次运行的事件。已有会话则会把此前运行里的消息和工具调用带回来。
会话变得太长时,你可以压缩较早的消息,也可以另起一个新会话。两种做法都会丢细节,所以凡是需要长期保留的内容,都应随手存进记忆。
权限
权限是永远在线 agent 风险最集中的地方。一次运行握着用户的访问权限,而且按设计是无人值守的。每次工具调用,agent 都要决定是自行继续、拦下它,还是等用户批准。
权限所用的组件和其他 agent 一样:
凭证存储: 永远在线的 agent 往往要拿到密码、访问令牌这类敏感用户凭证才有用。推荐做法是在 agent 环境之外放一个代理,由它把凭证加进出站请求。agent 发出不带凭证的请求,代理在转发前注入真实凭证。 自动模式: 永远在线的 agent 应当能在没有用户持续输入的情况下工作。我们已经在 Claude Code 里用自动模式处理过这个问题的一个版本。自动模式用分类器审查风险较高的操作,拦下被判定为危险的动作,让 Claude 去找更安全的做法。不过最重要的决策仍需用户复核。 延迟工具调用: 在 Claude Code 里,钩子可以延迟一次工具调用,等用户补充输入。同样的模式也适用于永远在线的 agent——它们在采取某些动作前可能需要澄清或批准。调用被延迟时,运行结束,会话在调用中途保存下来。请求会展示给用户(例如通过用 MCP Apps 搭的交互式卡片),用户的答复作为收件箱里的一个事件返回。这个事件启动一次新运行,带着用户输入恢复刚才保存的会话。延迟调用等答复期间,工作进程可以去处理别的事件,agent 不会被卡住。
发件箱
大多数 AI agent 的响应是边生成边流式推给用户的,用户可以跟着 Claude 推理问题、调用工具、写出答案。
永远在线的 agent 则相反,大部分工作在后台完成。用户拿到的是结果和少量细节,而不是完整的逐步过程。
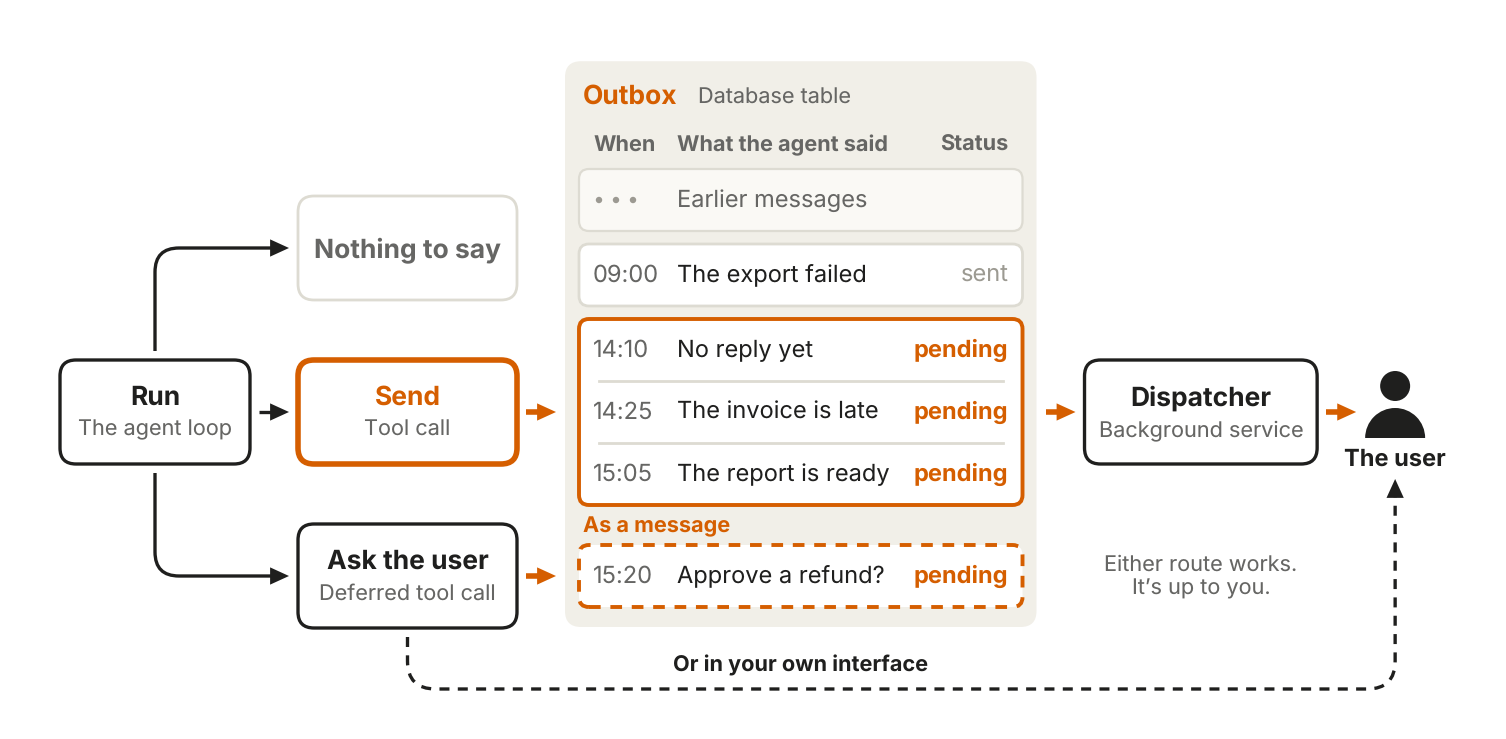
一次运行有三种收尾方式:
agent 往发件箱发一条消息, agent 判断没什么需要发送,或者 agent 用延迟工具调用请求批准或补充输入。
大多数永远在线 agent 用一个「发送」工具就够了,它能把消息直接递给用户。只有想控制 agent 发消息的节奏,或让 agent 能从错误里恢复时,才需要正式的发件箱。
发件箱是一张独立的外发消息表,和事件收件箱对应。还有一个分发器(通常是后台服务),和工作进程对应。分发器读取待发消息,决定投递哪些,再发给用户。延迟工具调用产生的请求,可以走发件箱,也可以直接显示在界面里。
除了投递,还有一件事很重要:调好 agent 发消息的数量。发得太多会变成噪音,发得太少又会漏掉用户该知道的信息。我们建议做 evals 来找到平衡。实践里更稳妥的是让 agent 一开始安静些,再随时间慢慢赢得用户更多注意力。
各部分如何配合
下面是五个原语如何配合:
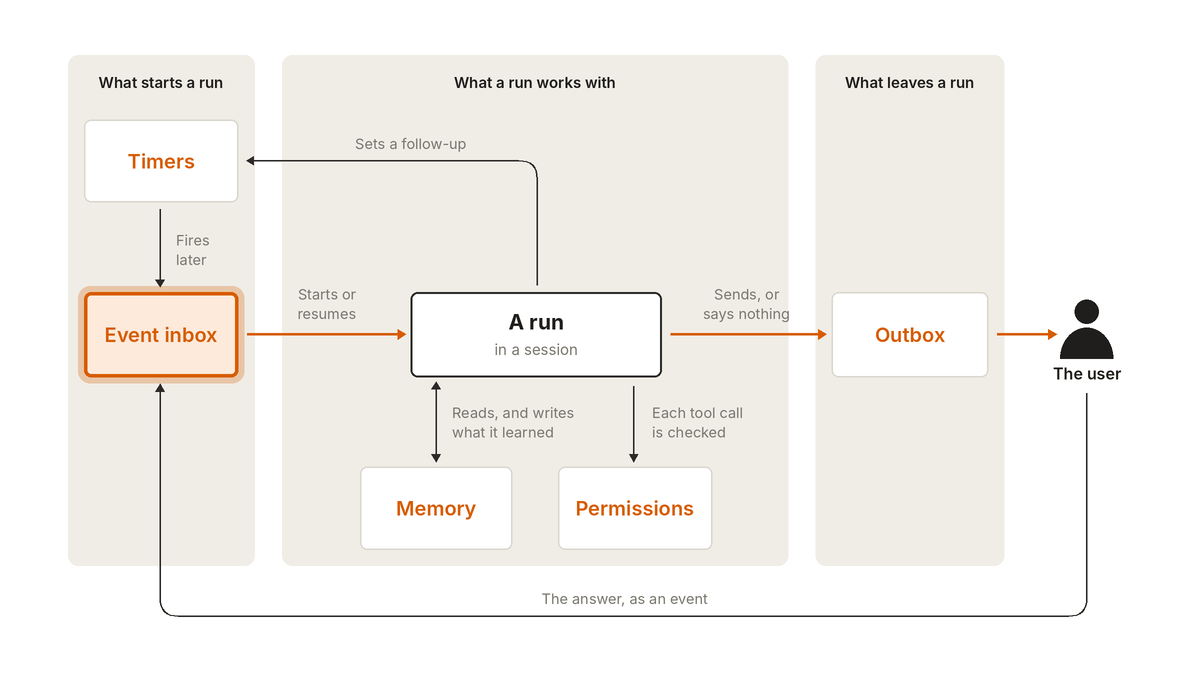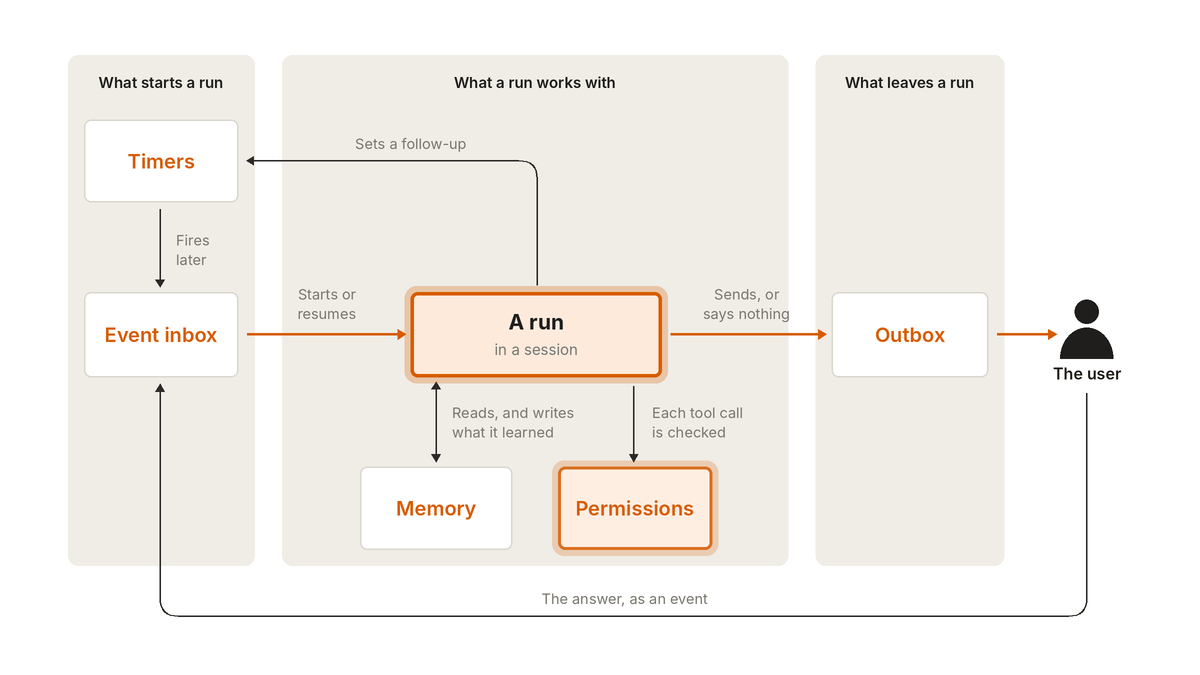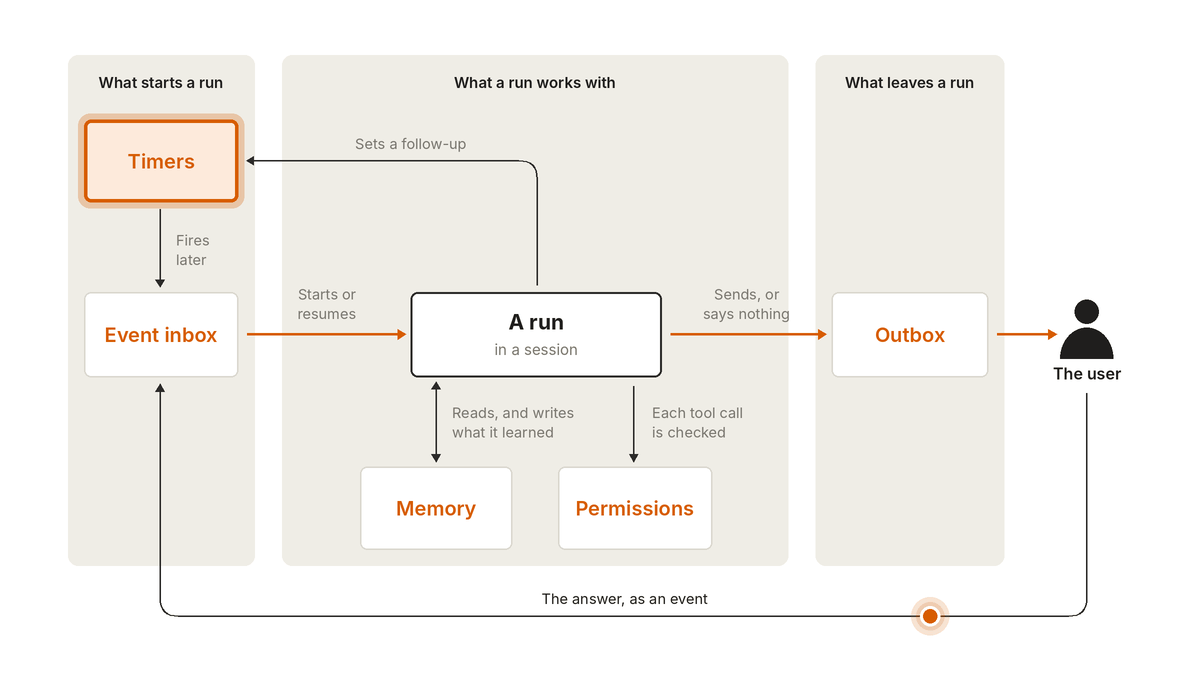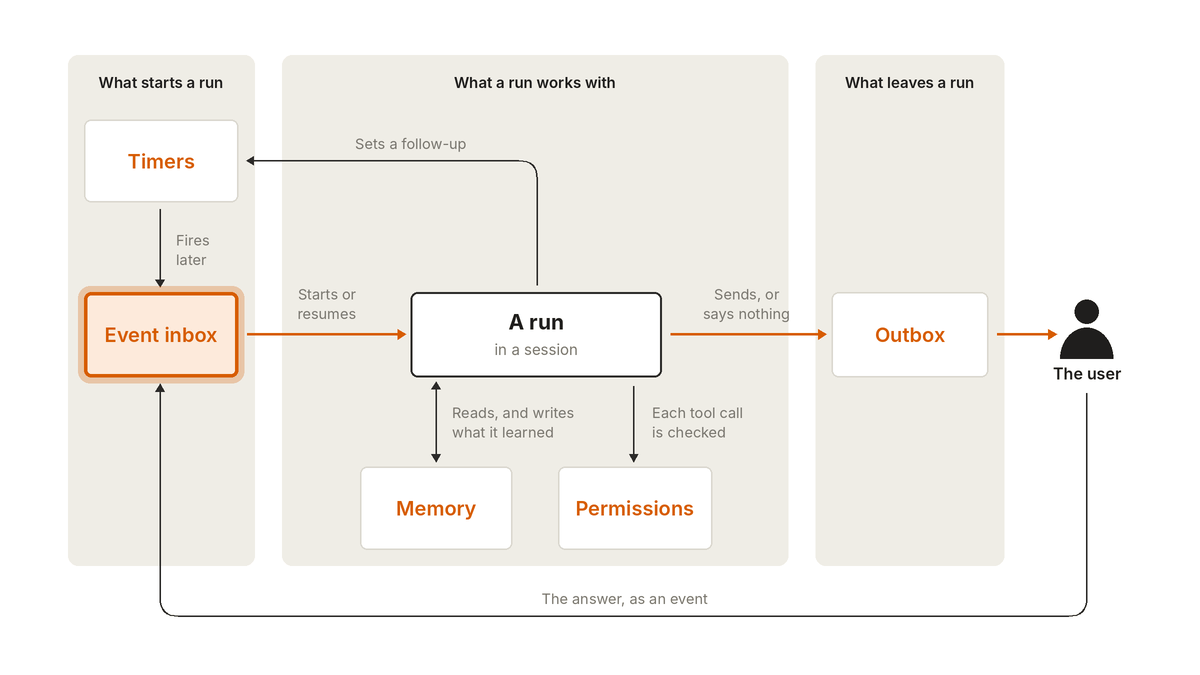
每次运行都从收件箱里的一个事件开始,可能是用户消息、webhook 或计时器。工作进程取走事件后,就启动一次运行,在新的或已有的会话里唤醒 agent。agent 先读记忆拿到基线,在权限范围内采取行动,再把学到的东西更新进记忆。运行结束后,agent 往发件箱推一行,分发器把消息送给用户。
这些合在一起构成了一个循环。一次运行可以设个计时器,稍后再把 agent 唤醒;用户回复消息时,答复又作为事件回到收件箱。每次运行都很短,但循环无限延续——正是这一点,让 agent 看起来永远在线。
致谢
由 William Hu 撰写。特别感谢 Rodrigo Olivares 和 Michael Segner 的贡献。
文章
2026 年 11 月 13 日
面向初创公司的 Claude Tag 指南
领先初创公司如何用 Claude Tag 更快交付、扩大运营规模
Claude Tag
文章
2026 年 11 月 10 日
Curative 如何借助 Claude 上的 agent 搭建全国医疗服务网络
Curative 负责谈交易的 agent 每周谈下 2,000 多份服务方合同。
Claude PlatformClaude Code
文章
2026 年 11 月 9 日
用 Claude Fable 5.2 安全地扩展多 agent 团队
一支由 1,000 个 agent 组成的团队运行 Claude Fable 5.2 的早期版本,借助通用工具、共享数据库和分层安全控制,复现了费马大定理的形式化证明。
文章
2026 年 11 月 9 日
该用哪个 Claude 模型来构建?
如何按任务、成本和投入程度,在 Claude Fable 5.2、Opus 5.5、Sonnet 5.5 和 Haiku 5.5 之间做选择。
Claude PlatformClaude Code
用 Claude 重塑组织的运作方式
查看定价联系销售
订阅开发者通讯
产品更新、操作指南、社区聚焦等内容,每月寄到你的收件箱。
如果想收到我们的每月开发者通讯,请留下邮箱地址。你可以随时取消订阅。