在线AI教程 / AI上云
[Amazon Bedrock] 降低 Amazon Bedrock AgentCore JSON 工作负载中的令牌成本和延迟
人工智能 降低 Amazon Bedrock AgentCore JSON 工作负载中的令牌成本和延迟 随着企业用几十个工具和大型结构化输入构建生产级 agent,token 消耗
人工智能
降低 Amazon Bedrock AgentCore JSON 工作负载中的令牌成本和延迟
随着企业用几十个工具和大型结构化输入构建生产级 agent,token 消耗与延迟成为良好用户体验的主要障碍。当这些 agent 处理大型 JSON 数据时,每一次额外的工具调用都会把完整 payload 注入大语言模型(LLM)的上下文窗口,使 token 用量与响应延迟飙升。在多轮对话中,这种压力不断累积,推高成本并降低回答质量。有效管理 agentic 系统中的上下文窗口压力,是在规模上保持可靠性与响应性的关键。本文分享三个可组合的策略,我们用它们为 Flightscape 构建了一个能处理 20 MB 以上 JSON payload 的生产级 agent。你可以用它们降低 token 成本、减少延迟,并在长会话中保持完整的推理能力。在一个有代表性的 23 MB payload 上,这些优化合起来把 token 消耗最多降低了 71%,把平均延迟最多削减了 80%。
解决方案概述
Flightscape 是一个航空公司运营平台,帮助航空公司规划和管理机队、航班与运营。作为 Flightscape 机组管理能力的一部分,我们构建了一个 Training Schedule Optimization agent,用来按业务规则校验机组培训计划的排班。它带有 40 多个工具、JSON 输入达到若干 MB,能够回答横跨机组分配、排班与资源分配的复杂问题。这个 agent 虽然实现了所需功能,但大多数调用的平均请求延迟超过 15 秒。每次工具调用都会把完整 payload 注入模型上下文,推高 token 数量与成本。在更大的数据集上,上下文窗口还没等 agent 推理完就被填满了。下图(图 1)展示了该 agentic 架构与数据流:
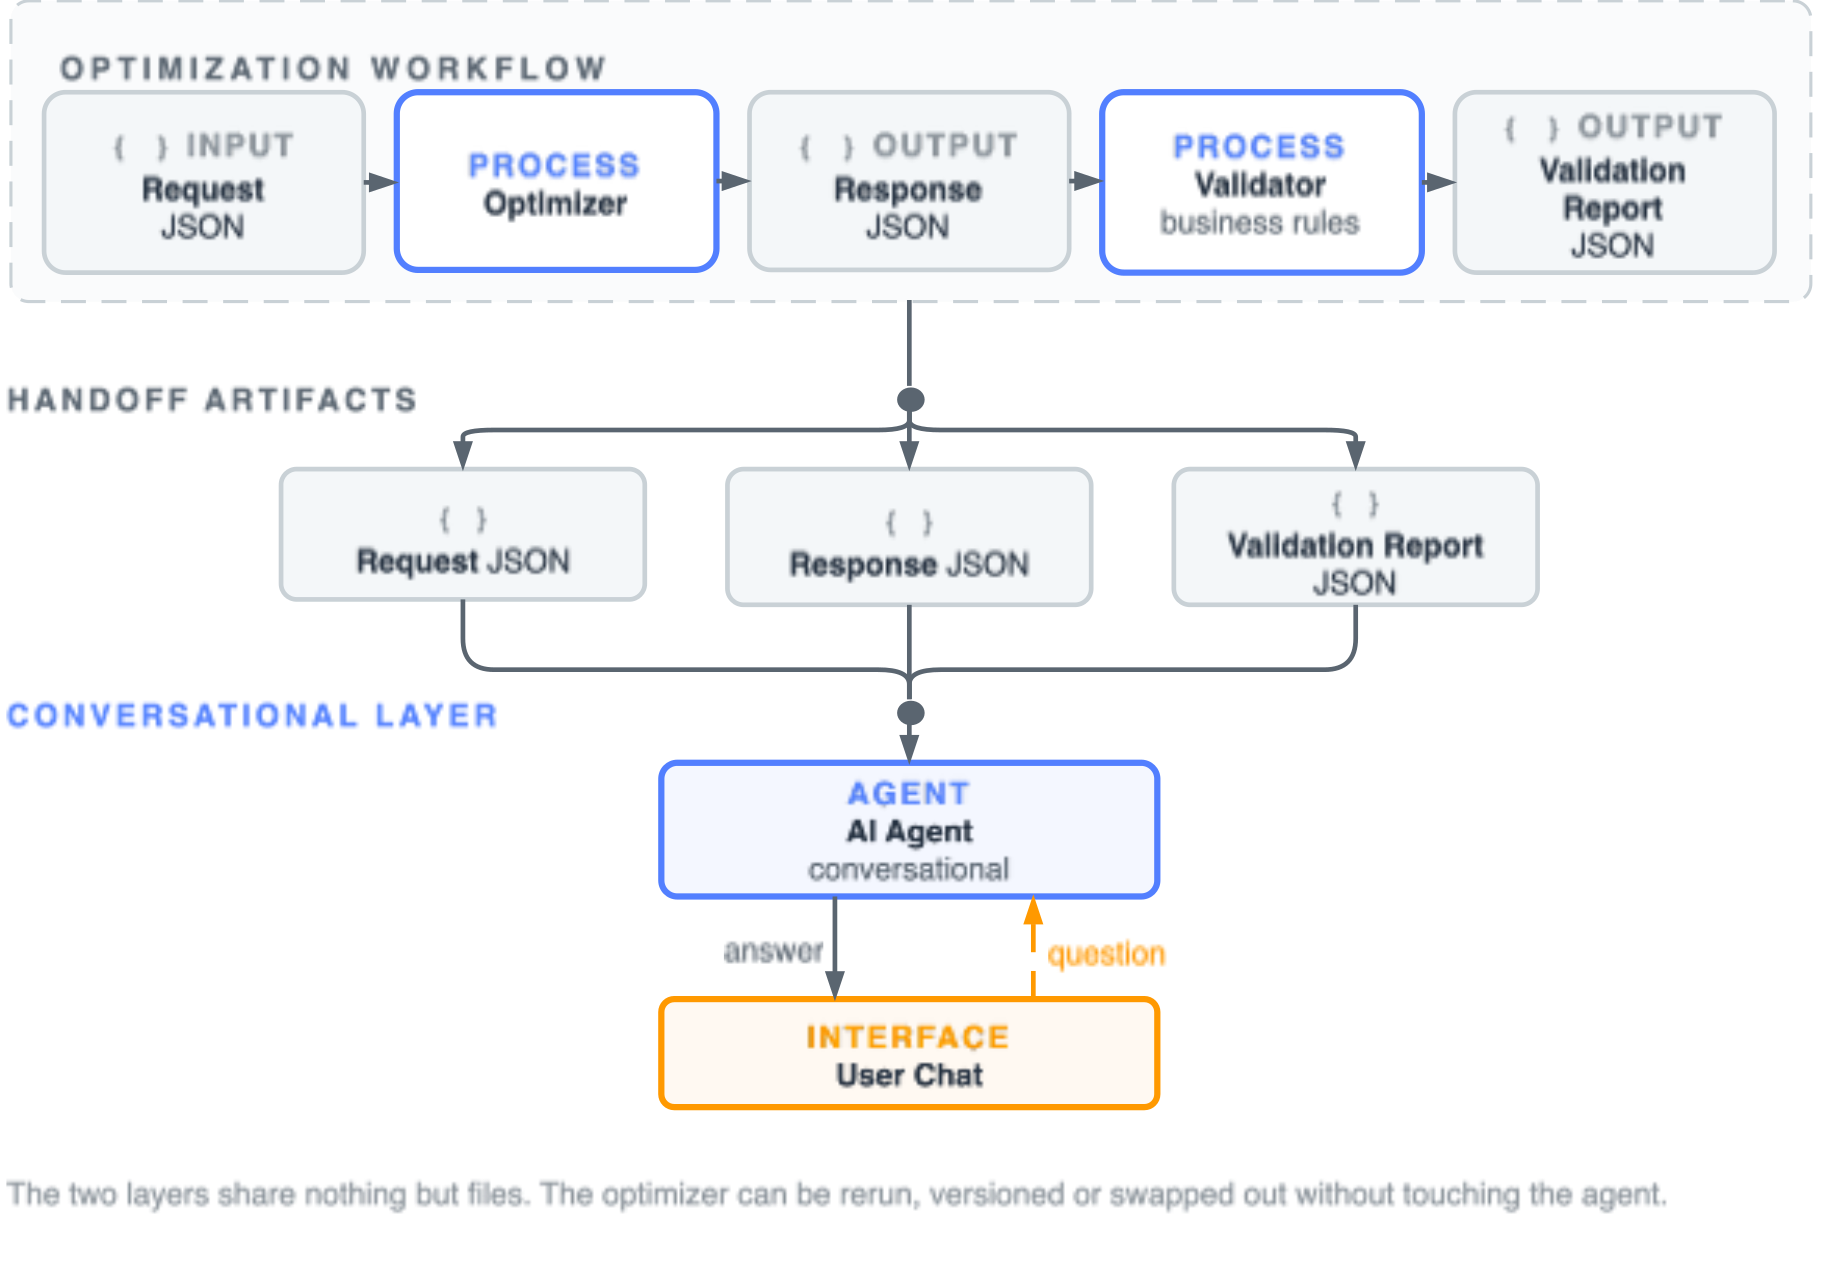
图 1:agent 架构与数据流
在图 1 中,Optimizer 接收 Request JSON 并产出 Response JSON,后者再由 Business Rules Validator 校验,生成 Validation Report JSON。三份 JSON 文档都会被一个 AI Agent 摄入,由它提供对话式界面,让用户查询优化结果、理解校验错误、探查排班分配。该 agent 用 LangGraph(LangChain 的开源框架)构建,运行在 Amazon Bedrock AgentCore 上——这是一个可以用任意框架、任意模型在规模上构建、连接与优化 agent 的平台。Amazon Bedrock Guardrails 可用于校验和过滤 agent 的对话回复,帮助在生产部署中落实负责任 AI 实践。我们定义了一个自定义 agent 状态,用来保存工具所需的数据:optimization request JSON、optimization response JSON 与 validation report JSON。我们还把基础统计与缓存数据加入状态,以支持更丰富的查询。agent 使用 Amazon Bedrock 模型做推理,并使用 Amazon Bedrock AgentCore memory(Amazon Bedrock AgentCore 的一项能力)跨轮次持久化聊天交互,每一轮都遵循下面的流程(图 2):
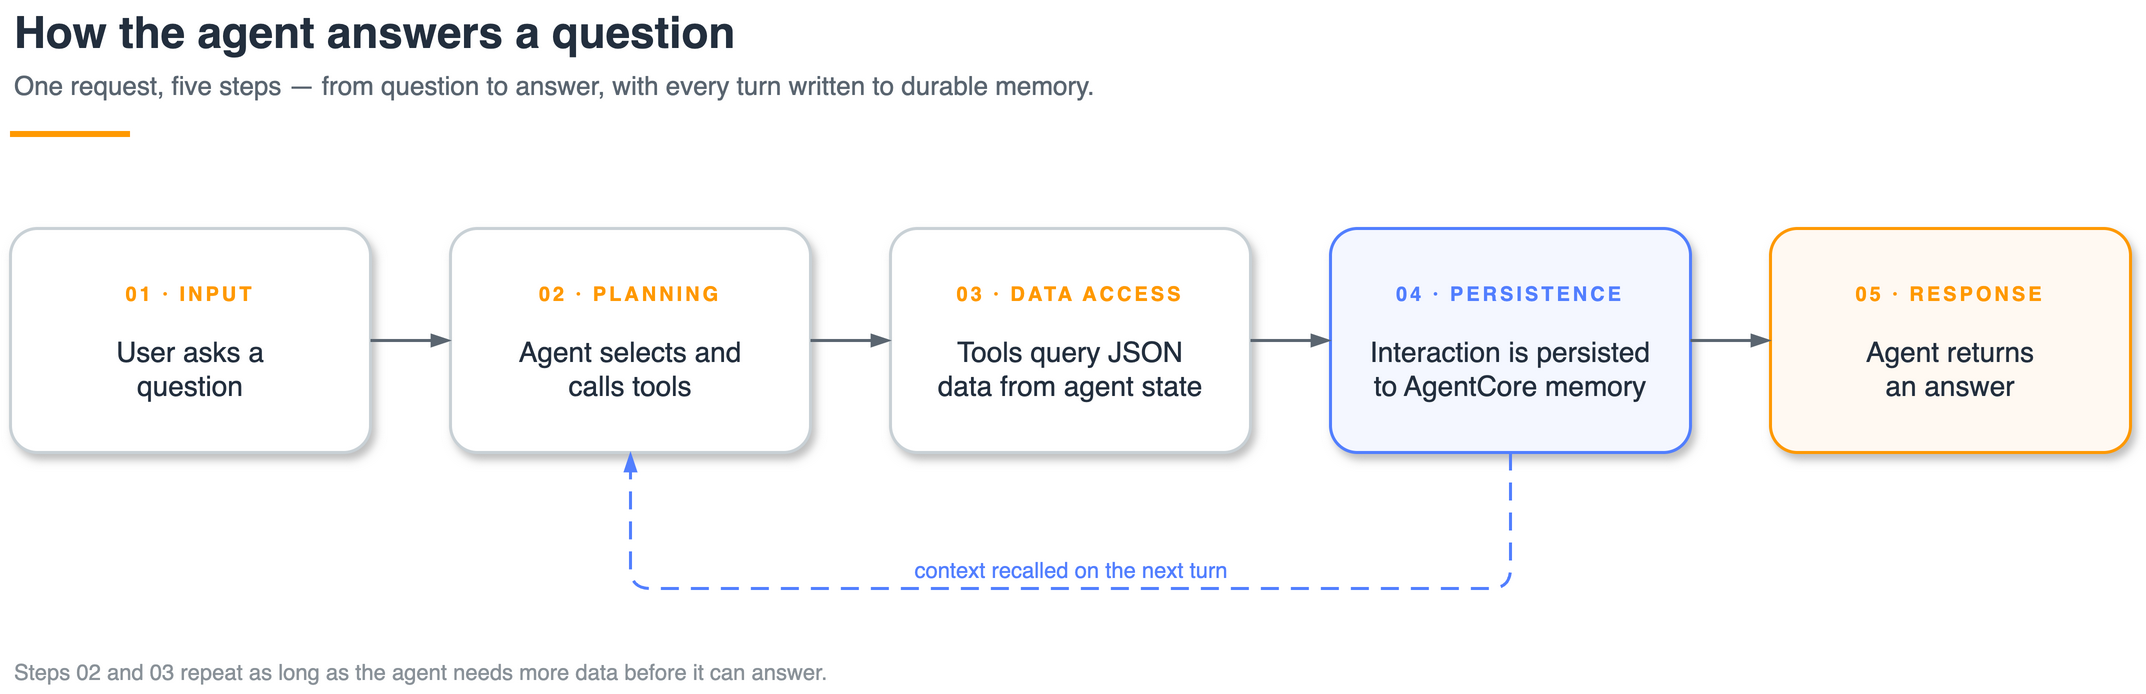
图 2:agentic 流程
状态结构看起来是这样的。该状态引用 TOPT(Training Optimizer)的 request 与 response 对象,它们分别表示机组排班的输入与优化结果:
class GraphState(TypedDict): """LangGraph state that combines messages with application data."""
Messages from conversation (managed by add_messages reducer)
messages: Annotated[List[BaseMessage], add_messages]
Application-specific state - parsed domain objects
request: Optional[TOPTRequest] responses: List[TOPTResponse] validation_report: Optional[Dict[str, Any]] basic_stats: Optional[Dict[str, Any]] cache_data: Optional[Dict[str, Any]]
注意: 这个状态最初把重型 payload 内联保存。后面的章节会说明我们如何把大型 artifacts 移出对话上下文,以降低 token 用量。
我们实现了三个策略,用来降低大型 JSON payload 穿过模型上下文所带来的 token 成本、延迟与内存开销。下图(图 3)展示这三个策略如何落在一轮 agent 里。策略 1 在每轮的开头与结尾运行,策略 2 和策略 3 则在每次工具返回结果时运行。
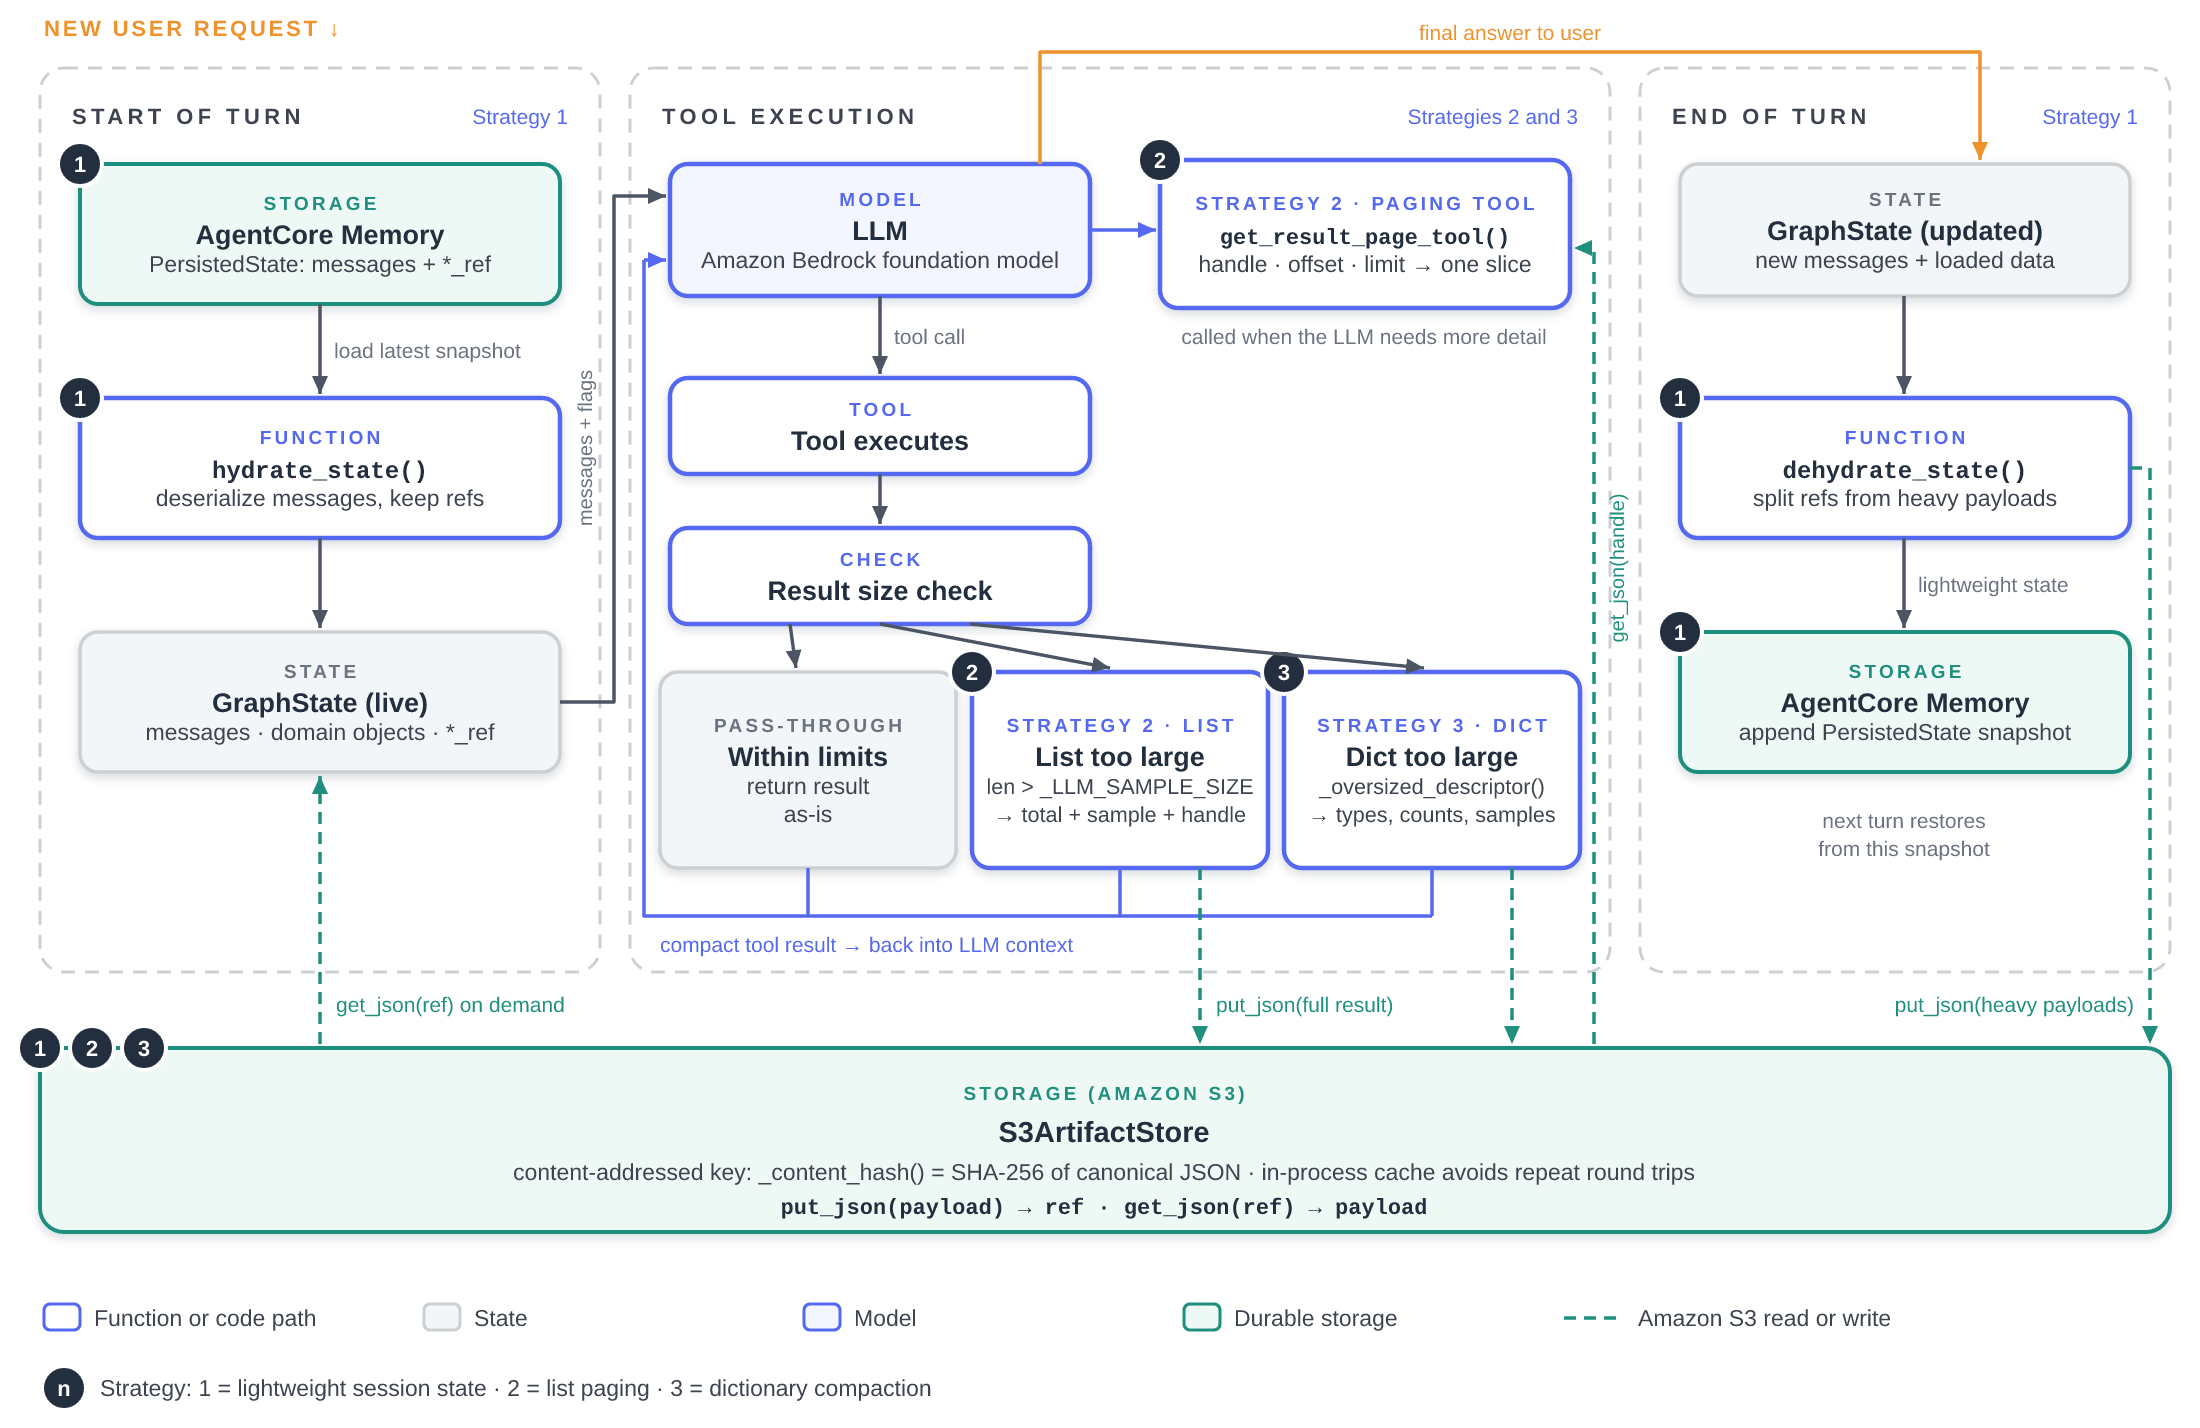
图 3:一轮 agent 中三个优化策略的概览
在一轮开始时,hydrate_state() 函数从 AgentCore memory 恢复轻量会话状态。当工具返回超大的列表或字典时,agent 把完整结果存入 Amazon Simple Storage Service (Amazon S3),并把一个带 handle 的紧凑摘要交给模型。模型随后可以用 get_result_page_tool() 取回更多细节。在一轮结束时,dehydrate_state() 函数把重型 payload 写入 S3ArtifactStore,只把引用保存到 AgentCore memory。下面各节详细说明每个策略。
前置条件
要实施这些策略,请确保以下条件就绪:
一个能访问 Amazon Bedrock 和受支持模型的 AWS 账户。 一个用于存放 artifacts 的 Amazon S3 桶。 已启用 Amazon Bedrock AgentCore memory 以持久化会话状态的 Amazon Bedrock AgentCore。 一个基于 LangGraph 的 agent(或等价的图编排框架),支持工具调用。 一个 Python 3.12+ 环境,装有 boto3、langchain-core 与 langgraph。
优化策略
配套代码见这个 GitHub repository。
策略 1:持久化轻量会话状态,外置重型 artifacts
我们的第一个优化是改变会话状态的持久化方式。最初,大型 payload 被存得离对话状态太近。于是我们把重型 artifacts(request JSON、response JSON、校验数据以及其他大型派生 payload)搬到 Amazon S3。这样 AgentCore memory 只持久化指向这些对象的稳定引用,让会话状态保持轻量。
为此,我们引入了一套专用的持久化状态 schema,只保留轻量字段与 artifact 引用。实时图状态仍包含解析好的领域对象供工具执行使用,但持久化写入的是脱水后的形式。运行时,工具按需用这些引用 hydrate 重型 payload,而不是每一轮都加载全部内容。
写进 AgentCore Memory 的就是这个 PersistedState schema:
class PersistedState(TypedDict, total=False): """Serialized session state for AgentCore Memory.
Heavy fields (request, responses) are stored in S3 and referenced by key. Lightweight fields are stored inline. """ messages: List[Any] # LangChain-serialized messages request_ref: Optional[str] # S3 key for raw request JSON responses_ref: Optional[str] # S3 key for raw responses JSON list cache_data_ref: Optional[str] # S3 key for cache_data payload validation_report_ref: Optional[str] # S3 key for validation_report payload basic_stats_ref: Optional[str] # S3 key for basic_stats payload
更新后的 GraphState 在实时领域对象之外,也镜像了这些引用:
class GraphState(TypedDict): """LangGraph state that combines messages with application data.""" messages: Annotated[List[BaseMessage], add_messages]
... (same domain fields as original graph state)
Artifact references for persistence
request_ref: Optional[str] # S3 key reference for raw request JSON responses_ref: Optional[str] # S3 key reference for raw responses JSON list cache_data_ref: Optional[str] # S3 key ref for cache_data payload validation_report_ref: Optional[str] # S3 key ref for validation_report payload basic_stats_ref: Optional[str] # S3 key ref for basic_stats payload
dehydrate_state 函数会把重型 payload 从实时状态中剥离,返回轻量持久化形式以及需要上传的 artifacts:
def dehydrate_state(state: GraphState) -> Tuple[PersistedState, Dict[str, Any]]: persisted: PersistedState = { "messages": [dumpd(m) for m in state.get("messages") or []], "request_ref": state.get("request_ref"), "responses_ref": state.get("responses_ref"),
... (remaining ref fields)
} artifacts: Dict[str, Any] = {} if state.get("request_raw") is not None: artifacts["request_ref"] = state["request_raw"]
... (see GitHub repository for full implementation)
return persisted, artifacts
再水化(rehydration)则反向执行这一过程。会话恢复时,我们重建实时图状态:反序列化 LangChain messages、把原始 payload 重新解析成领域对象,并恢复每一个引用键,好让后续轮次能找到各自的 artifacts:
def hydrate_state( persisted: PersistedState, request_raw: Optional[Dict[str, Any]] = None, responses_raw: Optional[List[Dict[str, Any]]] = None, ) -> GraphState: """Reconstruct a live GraphState from its persisted form.""" messages = [load(m, allowed_objects="messages") for m in persisted.get("messages") or []] request = TOPTRequest.from_dict(request_raw) if request_raw else None responses = [TOPTResponse.from_dict(r) for r in (responses_raw or [])] return { "messages": messages, "request": request, "responses": responses,
... (remaining fields restored from persisted refs, see GitHub repository)
}
脱水和再水化都依赖 artifact store 为每个 payload 返回一致的引用。我们没有生成随机 key,而是从 payload 本身推导引用。这种做法的名字叫内容寻址(content addressing):用排序后的键与紧凑分隔符序列化 JSON,再用这些字节的 SHA-256 摘要作为引用。
_content_hash 辅助函数从可 JSON 序列化的 payload 生成确定的 SHA-256 引用:
def _content_hash(payload: Any) -> str: return hashlib.sha256(_canonical_bytes(payload)).hexdigest()
内容寻址让写入具备幂等性。相同的 payload 映射到同一个 key,因此某一轮重新序列化一个未变的 request JSON 时,会复用桶里已有的对象,而不是再次上传。这个由 S3 支撑的存储暴露 put_json 与 get_json 接口。它还维护一个小小的进程内缓存,因此当前调用中已经读写过的 payload 不需要再走一次 S3 往返。
S3ArtifactStore 类在 put_json/get_json 接口外封装了进程内缓存与内容寻址的 key:
class S3ArtifactStore: """Content-addressed artifact store backed by Amazon S3.""" def __init__(self, bucket=None, prefix=None, region=None) -> None: self.bucket = bucket or os.getenv("SESSION_STATE_BUCKET") self.prefix = (prefix or os.getenv("ARTIFACT_STORE_PREFIX", "artifacts")).strip("/")
... (boto3 session setup, see GitHub repository)
self._cache: Dict[str, Any] = {}
def put_json(self, payload: Any) -> str: ref = _content_hash(payload) with self._lock: if ref in self._cache: return ref # Identical content already uploaded, skip PUT self._s3.put_object(Bucket=self.bucket, Key=self._key(ref), Body=_canonical_bytes(payload))
... (cache update)
return ref
def get_json(self, ref: str) -> Any: with self._lock: if ref in self._cache: return self._cache[ref]
... (S3 fetch and cache, see GitHub repository)
artifact_store = S3ArtifactStore()
把重型 artifacts 外置到 S3、只持久化轻量引用,降低了每轮延迟以及 AgentCore memory 中存储的数据量。重型 payload 不再内联持久化之后,工具调用的返回结果成了上下文 token 的主要消耗方,这促使我们引入结果分页。
策略 2:按需对大型结果列表分页
即使把重型 payload 的持久化搬到了 Amazon S3,工具响应阶段仍存在严重的 token 瓶颈。许多工具结果太大,带来两个问题。第一,模型只需要一小部分时,我们却把整个列表发过去,使每一轮更慢、更贵。第二,这些完整列表 payload 被注入上下文,在多轮对话中很快就把上下文窗口吃掉。
有些情况下,单个工具响应就超过 80,000 个 token,而随着用户继续与 agent 交互,成本还会叠加。我们希望在默认不发送全部内容的前提下保留完整的数据访问。为此,我们为大型工具输出引入了按需结果分页。工具不再返回完整列表,而是返回一个紧凑 payload,其中包含总数、一个小样本以及一个结果 handle。
当工具结果超过样本大小的阈值时,完整列表存入 S3,只向模型返回紧凑摘要:
if len(result) > _LLM_SAMPLE_SIZE: handle = artifact_store.put_json(result) return json.dumps( { "_oversized": True, "_result_handle": handle, "total": len(result), "sample": result[:_LLM_SAMPLE_SIZE], }, default=str, )
这个 handle 指向 S3 中存储的完整结果。当 agent 需要更多细节时,它带着 handle 调用分页工具,只请求所需的那一片数据,例如通过 offset 与 limit。
get_result_page_tool 函数让模型按 handle、offset 与 limit 取回已存结果的更多分片:
def get_result_page_tool(handle: str, field: Optional[str] = None, offset: int = 0, limit: int = 50): payload = artifact_store.get_json(handle) if isinstance(payload, list): return { "handle": handle, "offset": offset, "limit": limit, "total": len(payload), "items": payload[offset: offset + limit], }
... (dict field extraction, see GitHub repository)
按需分页把完整列表留在 S3,每轮只提供请求的分片,从而控制上下文增长并显著降低 token 用量。不过,并非所有超大输出都是列表。有些工具返回的是大型字典,需要另一种压缩办法。
策略 3:压缩超大的字典输出
与列表不同,字典输出包含深度嵌套的结构化数据,它们对推理有用,但逐字放进每一轮通常太贵。我们需要一种紧凑表示,既能保留结构线索,又能大幅削减 token 占用。
为此,我们为超大字典输出引入了基于描述符的压缩。我们不再完整返回超大字典,而是返回一个紧凑描述符:
列表字段用计数与样本表示。 嵌套字典用键的数量概括。 标量值在有用时保持内联。
完整 payload 存入 artifact store,响应中包含一个结果 handle。当 agent 需要更深的细节时,用该 handle 只取所需数据。这种响应格式对模型来说仍然可导航,同时显著减少了不必要的 token 用量。
_oversized_descriptor 函数为字典 payload 构建紧凑的结构摘要,保留字段类型与样本数据,但不含完整内容:
def _oversized_descriptor(payload: Dict[str, Any], handle: str) -> Dict[str, Any]: fields: Dict[str, Any] = {} for key, value in payload.items(): if key.startswith("_"): continue if isinstance(value, list): fields[key] = {"type": "list", "count": len(value), "sample": value[:5]} elif isinstance(value, dict): fields[key] = {"type": "dict", "keys": len(value)} else: fields[key] = {"type": "scalar", "value": value} return {"_oversized": True, "_result_handle": handle, "fields": fields}
如果序列化后的输出仍超出字符上限,兜底逻辑会存下完整 payload,并用其描述符替换响应:
content = json.dumps(llm_view, default=str) if len(content) > _MAX_TOOL_CONTENT_CHARS: if handle is None: handle = artifact_store.put_json(full_view) content = json.dumps(_oversized_descriptor(full_view, handle), default=str) return content
轻量持久化状态、按需分页与字典压缩到位之后,token 增长变得可预期,即使面对数 MB 的数据集,agent 也保持响应。
结果
为了验证这三个策略的效果,我们在同一数据集上用同一组问题,对优化前和优化后的 agent 版本各跑了一遍。然后在 Amazon Bedrock AgentCore Observability(AgentCore 的一项能力)中比较 token 用量与延迟,观察到成本与响应性都有明显改善。
在一次 5 个问题的对话运行中,总 token 用量下降约 71%,从 ~289,500 降到 ~82,900 个 token;平均 trace 延迟下降近 80%,从 15.4 秒降到 3.1 秒(图 4)。在 100 个样本问题上(图 5),总 token 从 23.6 M 降到 8.5 M(64%),平均 trace 延迟从 7,930 ms 降到 2,461 ms(69%)。
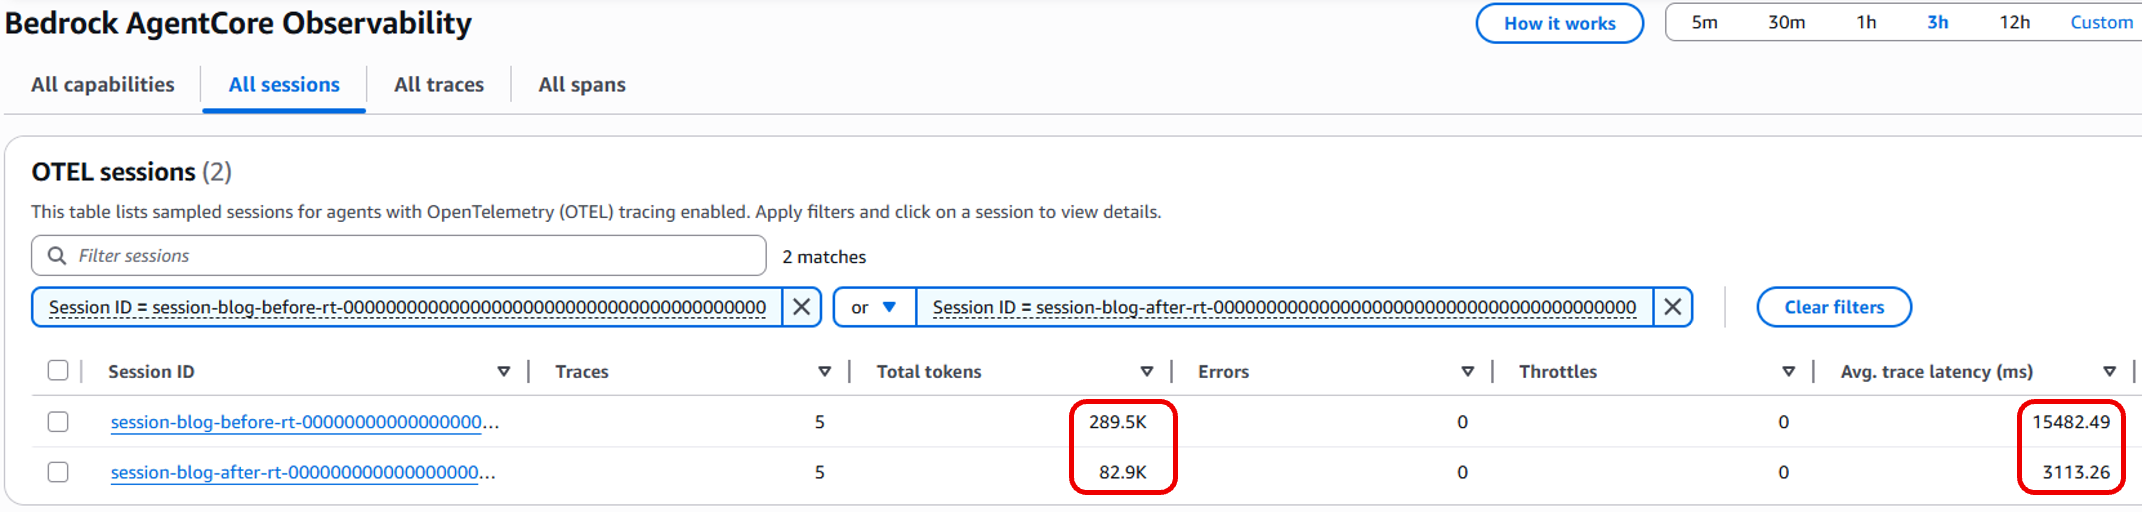
图 4:OTEL 会话对比
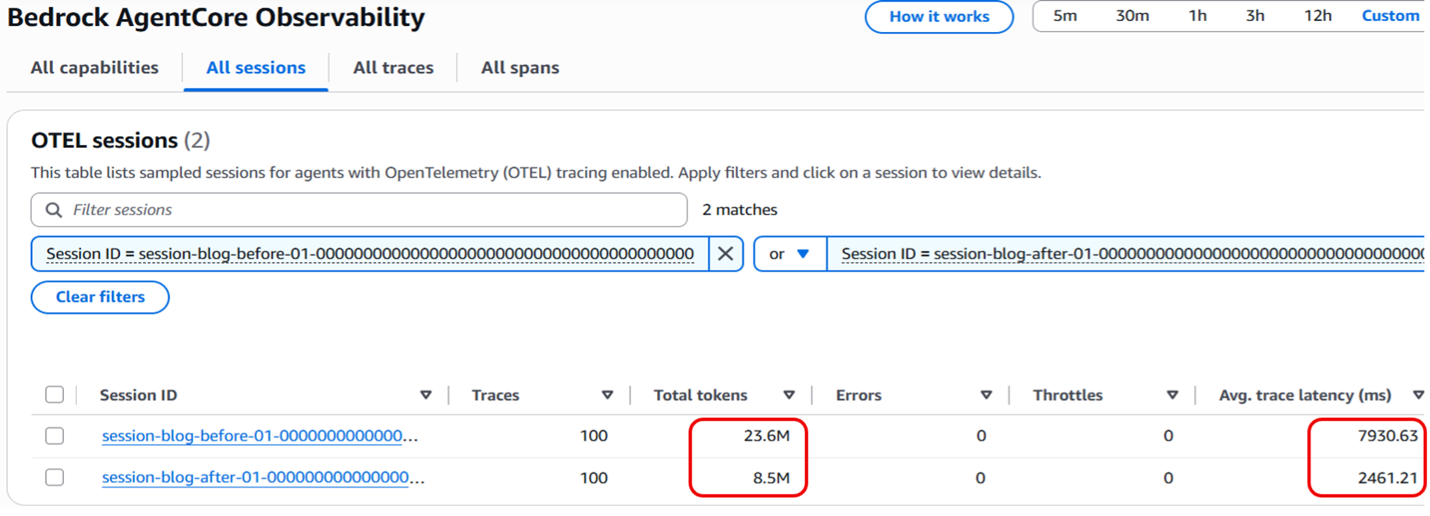
图 5:100 个样本问题的 OTEL 会话对比
效果在大型单轮 payload 上最为显著。表 1 拆解了最重的一次单次查询(列出每个校验类别下的有效机组)的逐轮影响。
指标优化前优化后降幅 输入 token~32,000~8,00075% 输出 token~2,80047783% 单轮延迟~165 s9.9 s94%
表 1:输入、输出与延迟的影响
图 6 与图 7 展示了优化前后对应的 trace 细节。
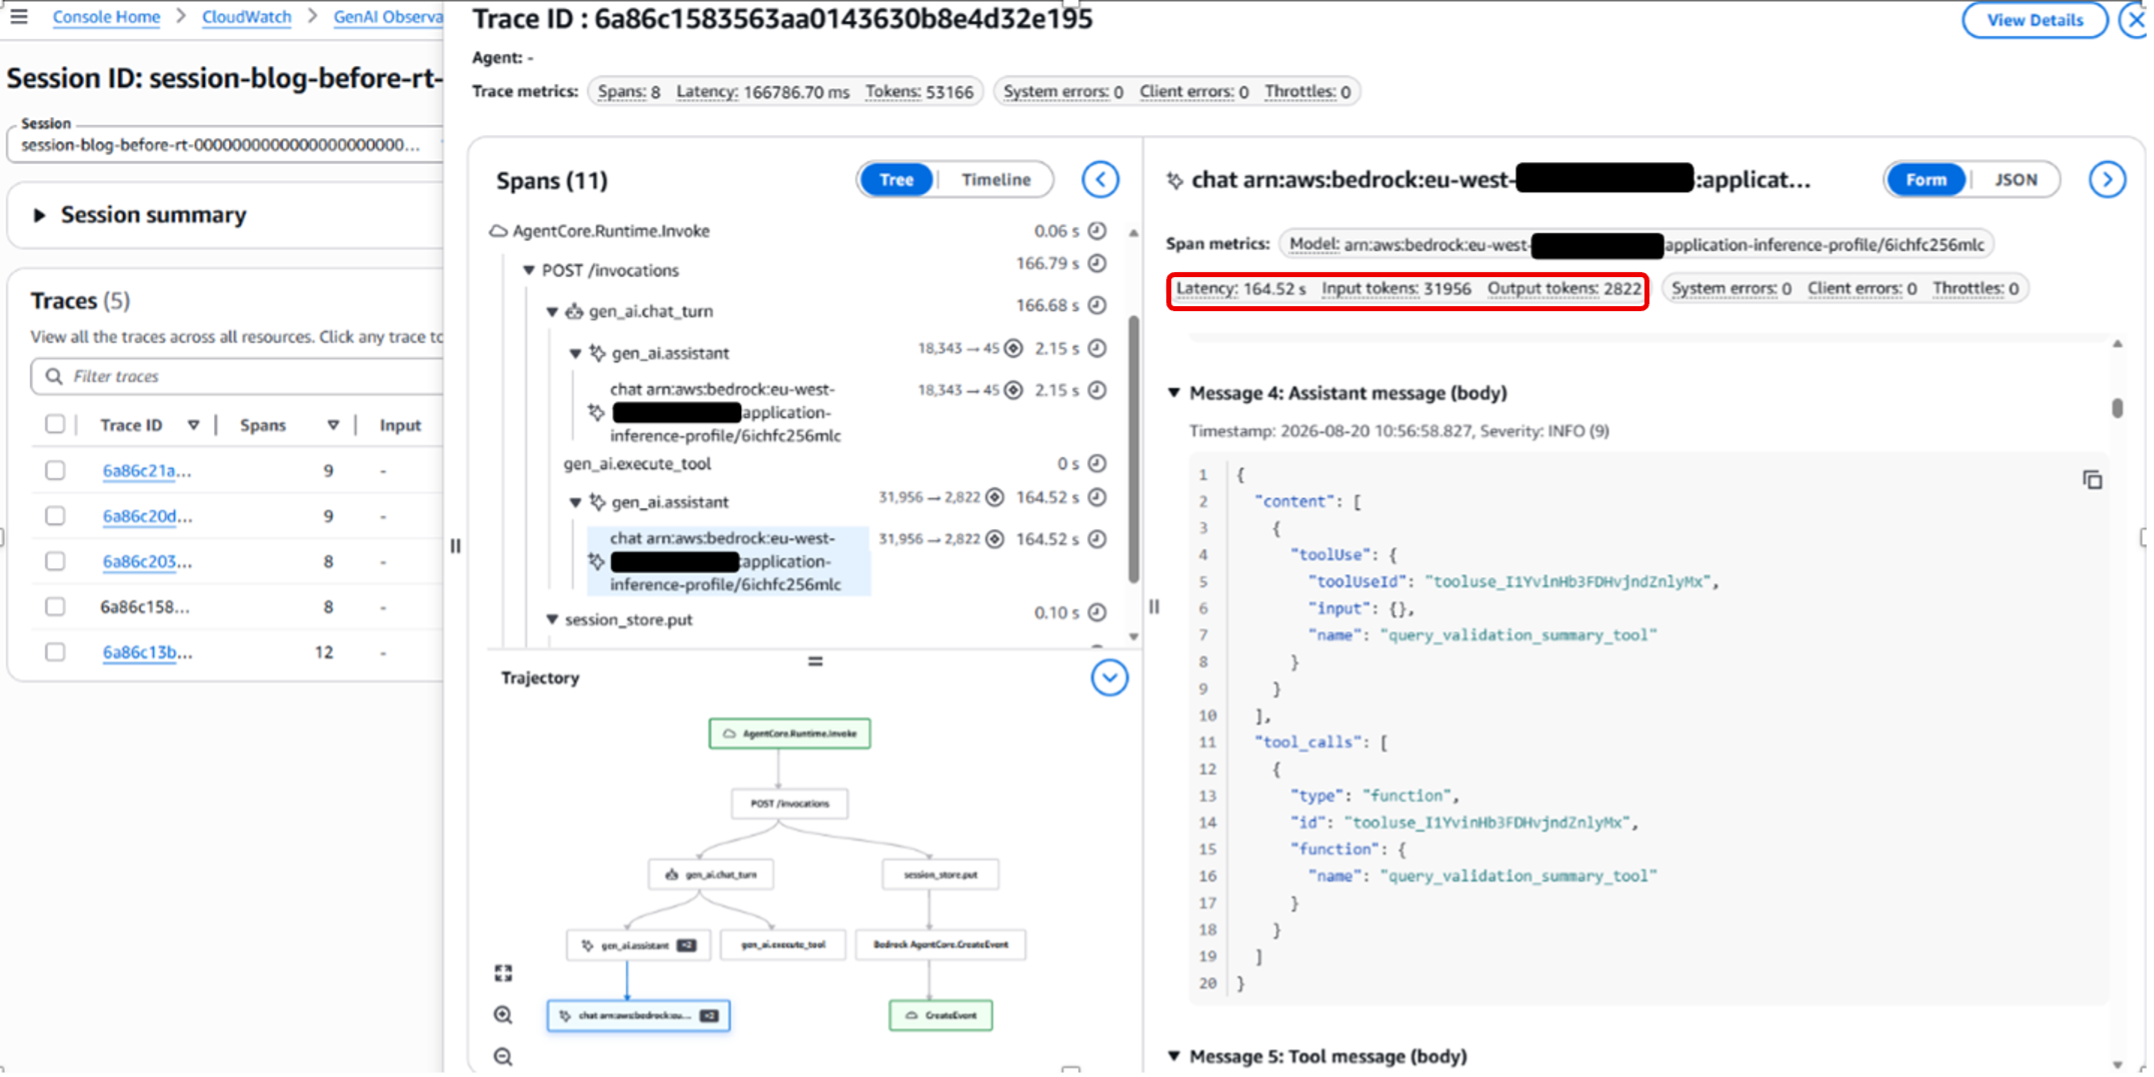
图 6:优化前的 trace 细节
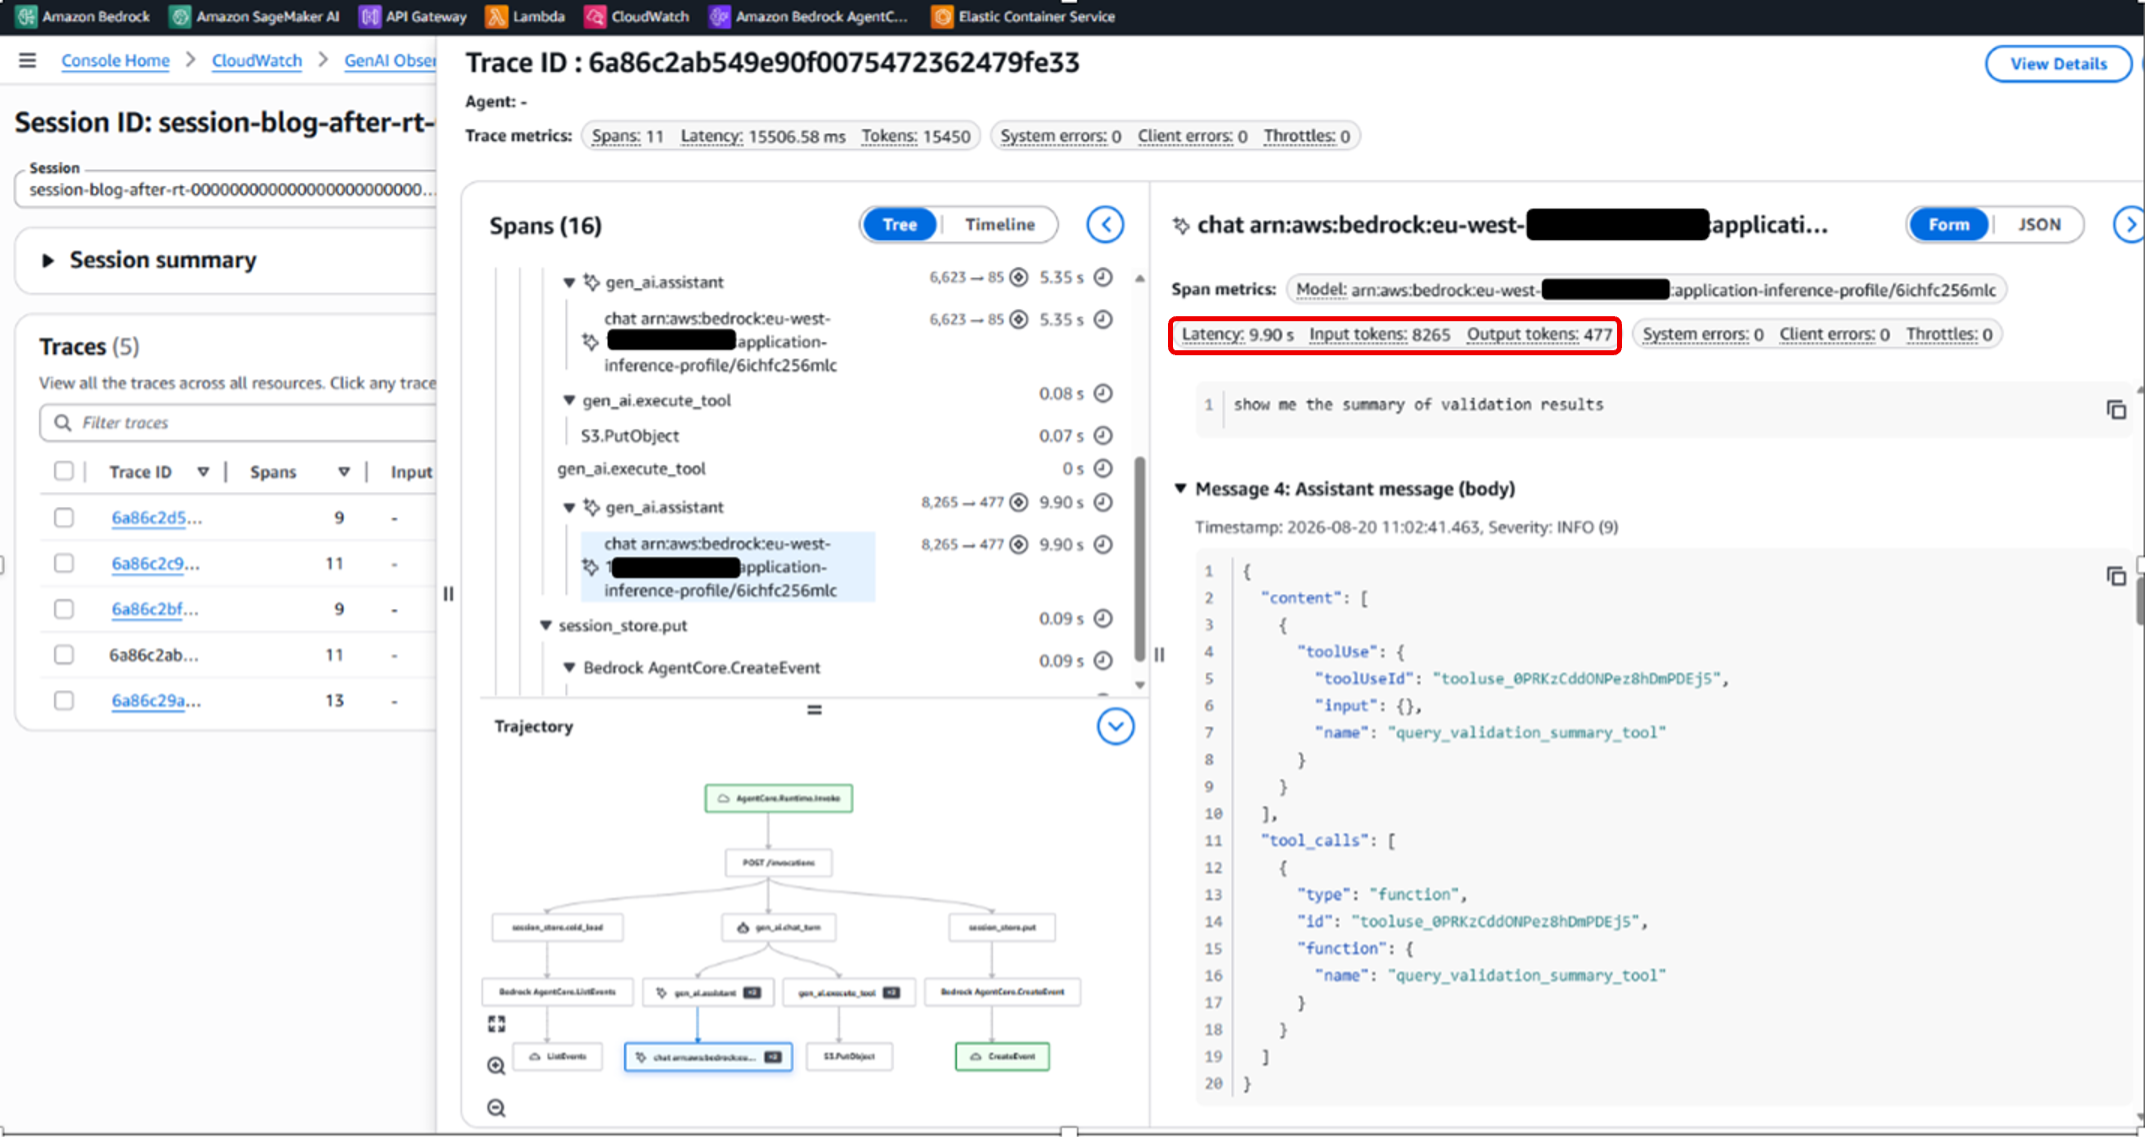
图 7:优化后的 trace 细节
这些收益主要来自避免在每一轮都把完整 payload 注入模型上下文。现在模型先收到紧凑摘要,只在需要时才取回额外细节。
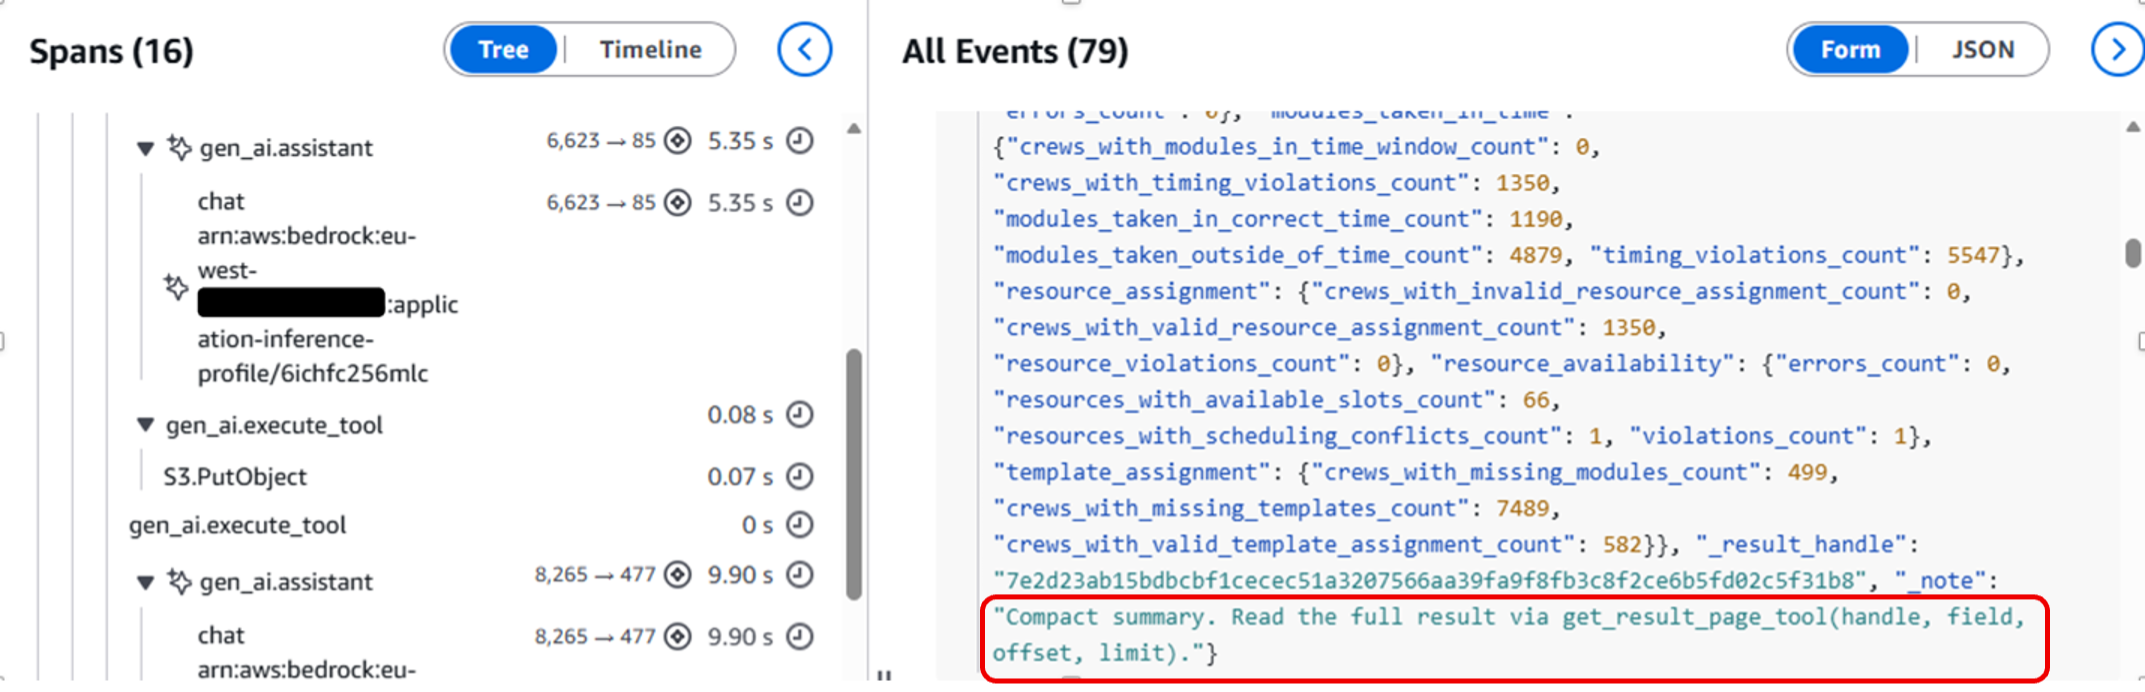
图 8:紧凑摘要事件
这种改善在 trace 时间线上也看得到:优化前的一轮拖到接近 2 分 46 秒,而优化后的一轮大约 15 秒完成(图 9)。
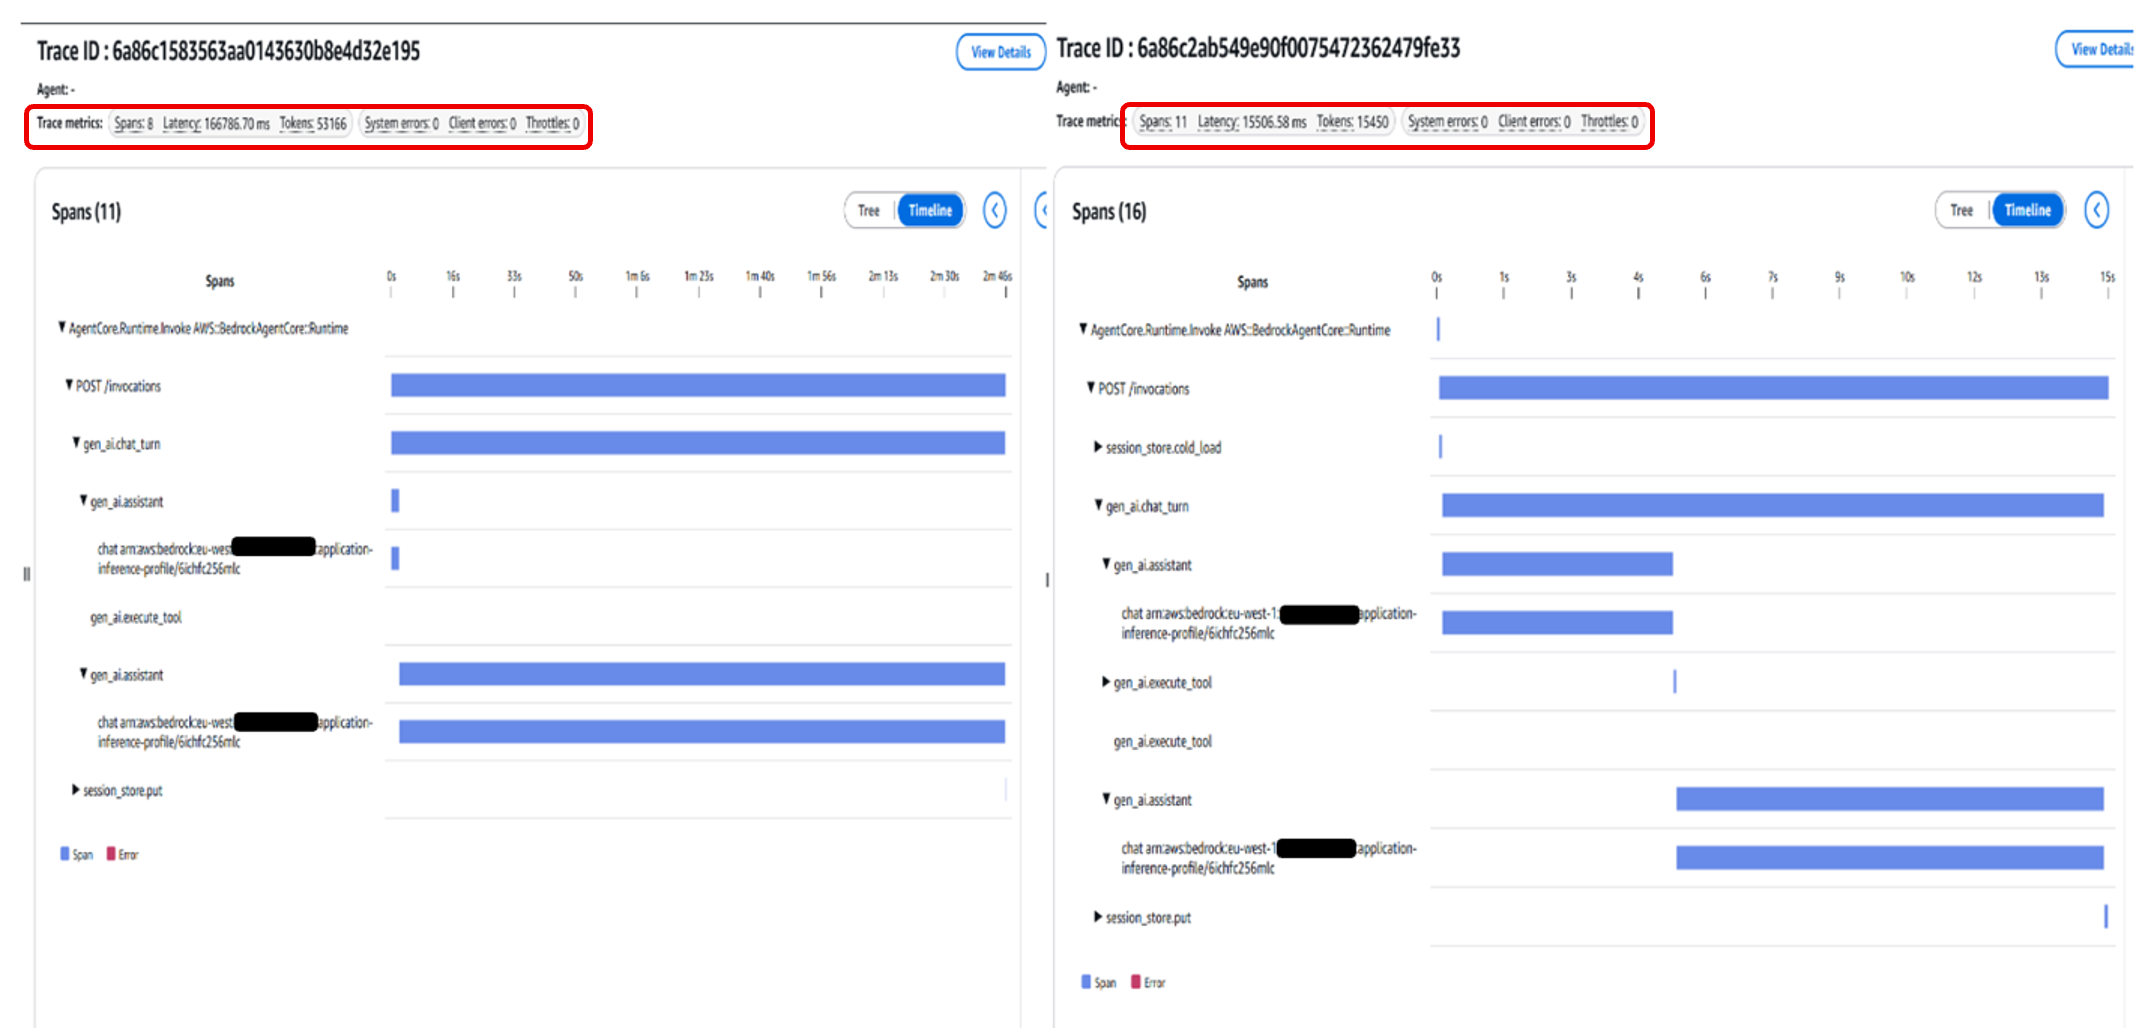
图 9:优化前后时间线
这些改动也改善了较长对话中的表现。跨轮次的上下文增长变得更可预期,即使用户在大型数据集上追问后续问题,agent 也保持响应。在实践中,这把系统从不断叠加的 token 成本,转变成一种更可控、由需求驱动的访问模式。
最重要的是,这些收益没有牺牲能力。完整 payload 仍保存在 artifact 存储中,任何时候需要更深的检查都可以通过 handle 取回。在 Flightscape,这种模式为把对话式 AI 能力引入复杂的航空公司运营工作流打下了基础,让底层的 AI 体验保持可扩展、成本高效。
清理
为避免持续计费,请删除你为本次演练创建的资源:
清空(并可选地删除)用于 artifact store 的 S3 桶,或删除 artifact 前缀(例如 artifacts/)下的所有对象。 删除测试期间创建的所有 Amazon Bedrock AgentCore agent 以及关联的 AgentCore memory 会话。 移除为访问 S3 或 Bedrock 而创建的 AWS Identity and Access Management(IAM)角色与策略。 删除 agent runtime 生成的 Amazon CloudWatch 日志组。 移除为本次演练预置的任何 Amazon Virtual Private Cloud(Amazon VPC)终端节点或网络资源。
结论
如果你的 Amazon Bedrock AgentCore agent 要处理大型 JSON 数据,先找出哪些工具输出主导了你的上下文窗口。从把 artifacts 外置到 S3 开始(策略 1),因为它是其他优化的基础;然后按需加入分页(策略 2)与压缩(策略 3),改善 agent 的 token 用量与延迟。要开始动手,克隆这个 GitHub repository 并把策略适配到你自己的 agent。想进一步了解用 AgentCore 与 LangGraph 构建 agent,请参阅 Amazon Bedrock AgentCore 文档与 LangGraph 框架文档。
关于作者