在线AI教程 / AI部署
[Amazon Bedrock] SageMaker Inference 现已支持 Multi-Instance GPU,以最大化模型端点的 GPU 利用…
人工智能 SageMaker Inference 现已支持 Multi Instance GPU,以最大化模型端点的 GPU 利用率 当您将模型部署到 GPU 端点时,能够请求的最
人工智能
SageMaker Inference 现已支持 Multi-Instance GPU,以最大化模型端点的 GPU 利用率
当您将模型部署到 GPU 端点时,能够请求的最小 GPU 资源单元是一整颗加速卡。
这种限制可能会带来双重代价。首先,您无法在一台实例上托管超过其加速卡数量的模型。一台 ml.p4d.24xlarge 配备 8 颗 A100,因此无论每个模型需要 40 GB 还是 14 GB 显存,它都只能容纳 8 个模型。其次(也更隐蔽的是),它使每次部署都演变成对“选择哪种完整 GPU 来部署”的抉择。随着并发量和提示词长度的增长,旧代实例上的完整 GPU 开始显得力不从心,但新一代实例上的完整 GPU 又超出您模型所需。您最终要么面临性能供给不足,要么为永远用不上的算力买单。
今天,Amazon SageMaker Inference 正式支持 GPU 分区(GPU partitioning),该技术利用 NVIDIA Multi-Instance GPU (MIG) 将物理 GPU 划分为相互独立的分区。每个分区获得该 GPU 计算单元的固定份额以及专用的显存块,并在硬件层面实施强隔离。这同时改变了上述两项限制:您可以在每个分区中放置不同的模型,并且可以选择更新一代加速卡的部分算力份额,而不再必须在两代卡之间二选一去租用整卡。
本文将涵盖这两个方面。第一部分是直接收益:部署数量超过物理 GPU 数量的模型,并在模型之间实现隔离。第二部分则是客户在谈到成本时最关心的问题:分区的细粒度如何帮助您选择大小适中的算力单元,以及我们在实际测试中衡量的具体数据。
在继续阅读之前需要了解一点:GPU 分区适用于使用推理组件(inference components)的端点,该结构可用于在单个端点上部署多个模型并设置每个模型分配的计算资源。GPU 分区正是直接构建在推理组件之上的。分区是组件申请的一种资源,就像它此前申请 CPU 和内存一样。如果您尚未使用过推理组件,这篇博文对其进行了介绍。单模型端点、Serverless 端点以及异构实例池不支持分区。
客户现有的做法,以及为什么每种方案都不尽人意
当模型数量超过物理加速卡数量时,您此前有三种选择。
运行更少、更大的端点并加大批处理粒度 – 这能提高利用率,但仅在模型可互换时才有效。而包含微调变体或按租户定制模型的组合显然无法互换。
使用多模型端点(Multi-Model Endpoints)– 这类端点按需在共享 GPU 上加载和卸载模型,适合稀疏、突发的流量。但模型在没有隔离的情况下共享设备,因此针对某个模型的重度请求会影响其他模型。未被加载的模型在首次调用时还要承担冷启动加载惩罚。
转向自建 Kubernetes – 这正是需要真正 GPU 分区的客户此前不得不走的路。MIG 在那里虽然可用,但您必须自行承担驱动版本管理、分区配置、设备插件(device plugin)、调度以及在整个机群中保持一致性的负担。为了利用实例原本就具备的硬件能力,这需要投入大量的运维精力。
为什么选择 MIG
NVIDIA Multi-Instance GPU (MIG) 可将一颗物理 GPU 划分为多达 7 个实例(具体取决于 GPU 型号)。每个实例拥有独立的计算单元、缓存、显存和显存带宽。因为这种划分是在硬件层面而非软件层面完成的,所以能够提供其他共享机制无法给予的保证:
可预测的延迟 – 每个分区拥有专用的显存带宽,因此一个模型的流量激增不会波及另一个模型的 p99 延迟。 故障隔离 – 崩溃或显存溢出错误会被限定在自身分区之内,而不会导致整颗 GPU 上的所有模型全部宕机。 大小适配的容量 – 中小型模型获得契合其需求的分片,无需占用整颗 GPU。您也可以在同一设备上混合搭配不同大小的分片。 无冷启动 – 每个模型独占自己的分区并保持常驻加载,没有加载惩罚,也不会被驱逐。 租户隔离 – 分区之间的显存保护由硬件强制执行,这让安全和合规审计变得更简单。 可靠的规划与计费分摊 – 分区的运行表现不受邻居影响,因此压测表现能够准确反映生产实际。GPU 成本也可以清晰归因到具体模型、团队或租户。
分区存在一些值得事先了解的边界。最大分区数取决于具体的加速卡型号,且永远不会超过 7 个。MIG 本身仅允许在其分区空闲时更改布局,而在 SageMaker AI 上,这意味着必须在创建端点时选定布局。需要超过一颗 GPU 的模型仍然需要整卡设备。在这些边界之内,您无需为每个模型独占整卡即可享有独立 GPU 的隔离性。
无需平台运维负担的分区
在此之前,使用 MIG 意味着必须自行搭建和维护 Kubernetes 技术栈。Amazon SageMaker AI 上的 GPU 分区消除了这一环节:您只需为模型选择一个分区 profile,SageMaker AI 便会自动处理 GPU 配置、调度放置和弹性伸缩。您在托管端点上即可直接获得硬件隔离的 GPU 共享能力,而无需维护底层平台。
Salesforce 从一开始就参与了这项工作,帮助定义需求并验证了最初的实现。
“NVIDIA MIG 将单颗 GPU 划分为多个隔离的实例,每个实例都配备专用的计算和显存资源。Salesforce 认为这是一项重要能力,因为许多推理工作负载并不需要整颗 GPU。MIG 让我们能够安全地整合工作负载,大幅提升 GPU 利用率,降低推理成本,并保持可预测的性能和强隔离。 这项能力将帮助我们在不同的用例中更高效地扩展 AI 推理。Salesforce 协助定义了需求,验证了初始解决方案。我们目前正准备利用具代表性的生产工作负载验证该方案,并与 AWS 一起展示强劲的客户需求。我们相信 MIG 支持将为企业客户带来显著的技术与业务价值。” — Richard Chang, Software Engineering Architect, Salesforce
工作原理
GPU 分区在您现有的 API 调用中增加了两个可选字段。没有新增任何 API 操作、资源类型或 AWS Identity and Access Management (IAM) 权限操作,且省略这两个字段的端点与现在的表现完全一致。
AcceleratorPartitionLayouts 放在 CreateEndpointConfig 的生产变体(production variant)中,用于声明每颗加速卡如何划分:
{ "EndpointConfigName": "multi-model-partitioned", "ExecutionRoleArn": "
A100 拥有 7 个可供划分的计算分片。上述布局用满了全部 7 个分片,因此 p4d 实例上的 8 颗 A100 中的每一颗都承载 3 个分区,该端点总共提供 24 个分区(每种类型各 8 个)。
切分规则是统一生效的。一个布局配置项描述了一颗加速卡如何切分,并且该变体中每台实例上的每颗加速卡都按相同方式划分。该列表与物理位置无关,因此配置项不会固定映射到具体的某颗 GPU。
AcceleratorPartitionType 放在推理组件上,用于选择该模型运行在哪个分区上:
{ "InferenceComponentName": "summarizer", "EndpointName": "multi-model-partitioned", "VariantName": "AllTraffic", "Specification": { "ModelName": "summarizer-model", "ComputeResourceRequirements": { "AcceleratorPartitionType": "mig-4g.20gb", "NumberOfAcceleratorDevicesRequired": 1, "NumberOfCpuCoresRequired": 1, "MinMemoryRequiredInMb": 2048 } }, "RuntimeConfig": { "CopyCount": 1 } }
组件的每个副本占用一个所请求类型的分区。由于实例上每种类型各有 8 个分区,增加 CopyCount 就会在空闲分区上放置更多副本。这对于处理高并发的小模型非常有用,避免单进程导致 GPU 处于等待请求的状态。
此处的 NumberOfAcceleratorDevicesRequired 始终为 1。在设置了分区类型时,它代表一个分区而不是一整颗加速卡。NumberOfCpuCoresRequired 和 MinMemoryRequiredInMb 仍用于描述宿主机 CPU 和宿主机内存,因为 GPU 显存来自所选的分区类型。
调用方式保持不变。InvokeEndpoint 通过推理组件名称寻址模型,其占用的具体分区绝不会出现在请求中。
分区切分在端点置备(provisioning)期间完成。当端点达到 InService 状态时,所有加速卡均已完成划分且分区均为空,这是一种正常有效状态,因为组件是在此之后部署上来的。在我们的测试中,划分加速卡大约使置备时间增加了 17 秒。其余时间均为常规的实例启动与容器拉取耗时。
各 GPU 的分区配置 Profile
可供使用的 profile 是 GPU 本身的固有属性,因此首先需要确认您的实例类型搭载的是哪款 GPU,并在 NVIDIA 支持的 MIG profile 中进行查询,该文档是关于完整 profile 集合以及单设备上合法组合的权威参考。
Instance familyAcceleratorGPU memoryGranularity (compute / memory)Available partition profilesMax partitions per GPU P4dNVIDIA A10040 GB7 / 8mig-1g.5gb, mig-1g.10gb (see driver note), mig-2g.10gb, mig-3g.20gb, mig-4g.20gb, mig-7g.40gb7 P5NVIDIA H10080 GB7 / 8mig-1g.10gb, mig-1g.20gb, mig-2g.20gb, mig-3g.40gb, mig-4g.40gb, mig-7g.80gb7 G7NVIDIA RTX PRO 4500 Blackwell32 GB2 / 2mig-1g.16gb, mig-2g.32gb2 G7eNVIDIA RTX PRO 6000 Blackwell Server Edition96 GB4 / 4mig-1g.24gb, mig-2g.48gb, mig-4g.96gb4
Profile 名称的解读方式为计算单元数后接显存大小:mig-3g.40gb 占用 3 个计算单元和 40 GB 显存。细粒度(Granularity)列决定了布局的组合上限。A100 和 H100 在计算上划分为 7 等份,在显存上划分为 8 等份;而 G7 划分为 2 等份,G7e 划分为 4 等份。即使分片数量相同,不同 GPU 之间的 profile 名称也可能不同,因此在跨实例族迁移布局时,切勿在未对照此表核验的情况下直接套用。
在这些限制之内,您拥有充分的选择空间。在 P4d 或 P5 上,您可以划分 7 个最小规格的 profile,或者 2 个 3g 分区,或者像前文示例中那样采用 4g 加 2g 加 1g 的布局,也可以将整颗设备作为一个完整分区。在 G7e 上,您可以划分 4 个最小规格分区,或者 2 个 1g 搭配 1 个 2g,或者 2 个 2g,抑或整卡使用。在 G7 上,则可选择两个分区或单分区。
3g profile 是最值得关注的一个,因为它的两个维度并不对称:它占用 7 个计算单元中的 3 个,但占用 8 个显存单元中的 4 个。两个 3g 分区就会占满整颗 GPU 的显存,旁边无法再容纳任何其他分区。
高层规则: 布局中的每个 profile 都必须是您的 GPU 所支持的规格,且各 profile 累加后的计算单元与显存单元不得超过单颗设备所能提供的上限。这两项在创建端点配置时均会进行校验,其中任何一项不满足都会被直接拒绝,而不会降级回整颗加速卡。
P4d 驱动注意事项: mig-1g.10gb 需要 R525 或更高版本的 NVIDIA 驱动,而默认的 P4d 镜像搭载的是 470.256.02。如果在默认镜像上请求该规格,切分会直接失败且报错信息中不会明确指出该 profile。请在生产变体上将 InferenceAmiVersion 设置为 al2023-ami-sagemaker-inference-gpu-4-1,以获取搭载 580 系列驱动的镜像,该镜像支持该 profile。
为您的工作负载选择合适的布局
选得好,与选出一个仅仅能被系统接受的布局,是两码事。分区以固定比例为您提供算力与显存,而这两者在推理过程中扮演着不同的角色。
计算单元是 Prefill 阶段所必需的。 Prefill 负责读取提示词并构建其表征。这是计算密集型阶段,其扩展性取决于分区包含的流式多处理器(SM)数量以及对应的 TFLOPs。您的输入越长、同时到达的提示词越多,计算单元对首字延迟(TTFT,Time to First Token)的影响就越具决定性。
显存单元是 Decode 阶段以及承载容量所必需的。 生成 token 的每一步都需要重新读取模型权重,因此 Decode 阶段受显存带宽限制而非纯数学算力,同时显存还决定了可容纳的 KV cache 上限。该上限反过来又决定了您可以支持的上下文长度以及能够并发处理的序列数量。
几乎没有任何实际生产负载只依赖其中单一维度,因此目标不是二选一,而是选择支持您具体用例的最佳组合。 选择 profile 时,其比例应满足您最繁重阶段的需求,同时兼顾另一阶段的充足供给。在计算端,关键在于提示词的长度以及瞬时到达的请求量。在显存端,关键在于输出长度、上下文窗口和并发度。
显存是两者中更容易被低估的一个,因为一个分区必须承载三样东西,而不仅仅是模型本身:模型权重(对于 8B 的 FP16 模型约为 16 GB);KV cache(其大小取决于您计划支持的上下文长度和并发序列数,这是人们往往遗漏且会随流量增长的部分);以及 1–2 GB 用于 CUDA 上下文和推理服务进程的运行时开销。在选择 profile 之前务必将这些累加起来,因为仅按模型权重大小规划的分区虽然能成功加载模型,但在负载下会崩溃,或者悄无声息地将上下文截断为远短于您配置的值。作为具体参考,同一个 8B 的 FP16 模型在 40 GB 的分区上可以轻松支持 8,000 token 的上下文。
MIG 最能发挥价值的场景
中小型模型组合 – 最直接的场景。微调变体、嵌入模型、重排器和分类器,每个模型原本都会闲置加速卡的大部分资源,现在可以共享单颗卡。
多租户模型服务 – 当您为每个客户托管一个模型时,MIG 在它们之间提供了硬件边界:某个分区内的进程无法读取另一个分区的显存或抢占其吞吐量。不过,请客观理解这一隔离边界。同一实例上的模型仍然共享宿主机 CPU、系统内存、存储、网络和端点路由,因此分区是针对 GPU 的隔离机制,而非完备的多租户边界。
单实例上的多阶段流水线 – 语音转写模型、说话人分离模型与语言模型,或者嵌入器、重排器与生成器。每个阶段均是其独立分区上可单独寻址的组件,各阶段之间的网络跨跳得以消除。
请求链路中的小型模型 – 每个请求都必须经过的安全分类器或 guardrail 模型,虽然独立占用一颗加速卡并不划算,但由于无需与主模型进行时间分片轮转,因此能保证可预测的延迟。
候选模型与金丝雀发布(Challengers and canaries)– 在负责生产流量的模型旁边,利用一个小分区运行候选模型,而无需单独搭建第二套端点。
性能表现:更先进 GPU 的一小片 vs 旧代 GPU 的一整颗
除了装箱整合(bin-packing)之外,您获得的另一项好处是高端 GPU 上的细粒度选择:在部署模型时拥有更多 GPU 规格可选,并且能自主抉择哪一款最适合您。每颗受支持的加速卡都细分为若干种尺寸,因此实用的思考方式是将每个 profile 视为一种独立的 GPU 规格选项,与您原本可供选择的整颗加速卡并列。这在考虑更大或更新的实例类型时尤为重要,因为升级不再是非全即无的单选题:您可以根据工作负载所需,按其发布的任意规格选取那颗更强 GPU 的一部分,而无需为整颗加速卡买单。
为了验证这是否划算,我们将 H100 上的一个 mig-3g.40gb 分区与一整颗未划分的 A100-40GB 进行了对比。两者的 GPU 显存相当,这提供了一种清晰纯粹的对照,以观察更先进实例的一个切片能够拥有多么强大的性能。
我们使用 genai-bench 生成负载,从同一客户端向两个端点施加压力,确保 GPU 是唯一的变量。两端均在生产级 SageMaker 实时端点上运行 Llama-3.1-8B-Instruct(各一个模型副本),使用完全相同的容器镜像、分词器和客户端配置。两者均通过 SageMaker AI 原生兼容 OpenAI 的路由调用。我们测试了五种流量特征(表示为 D(输入 token, 输出 token),从短提示词到长上下文摘要),每种均覆盖 2 到 512 的并发梯度。
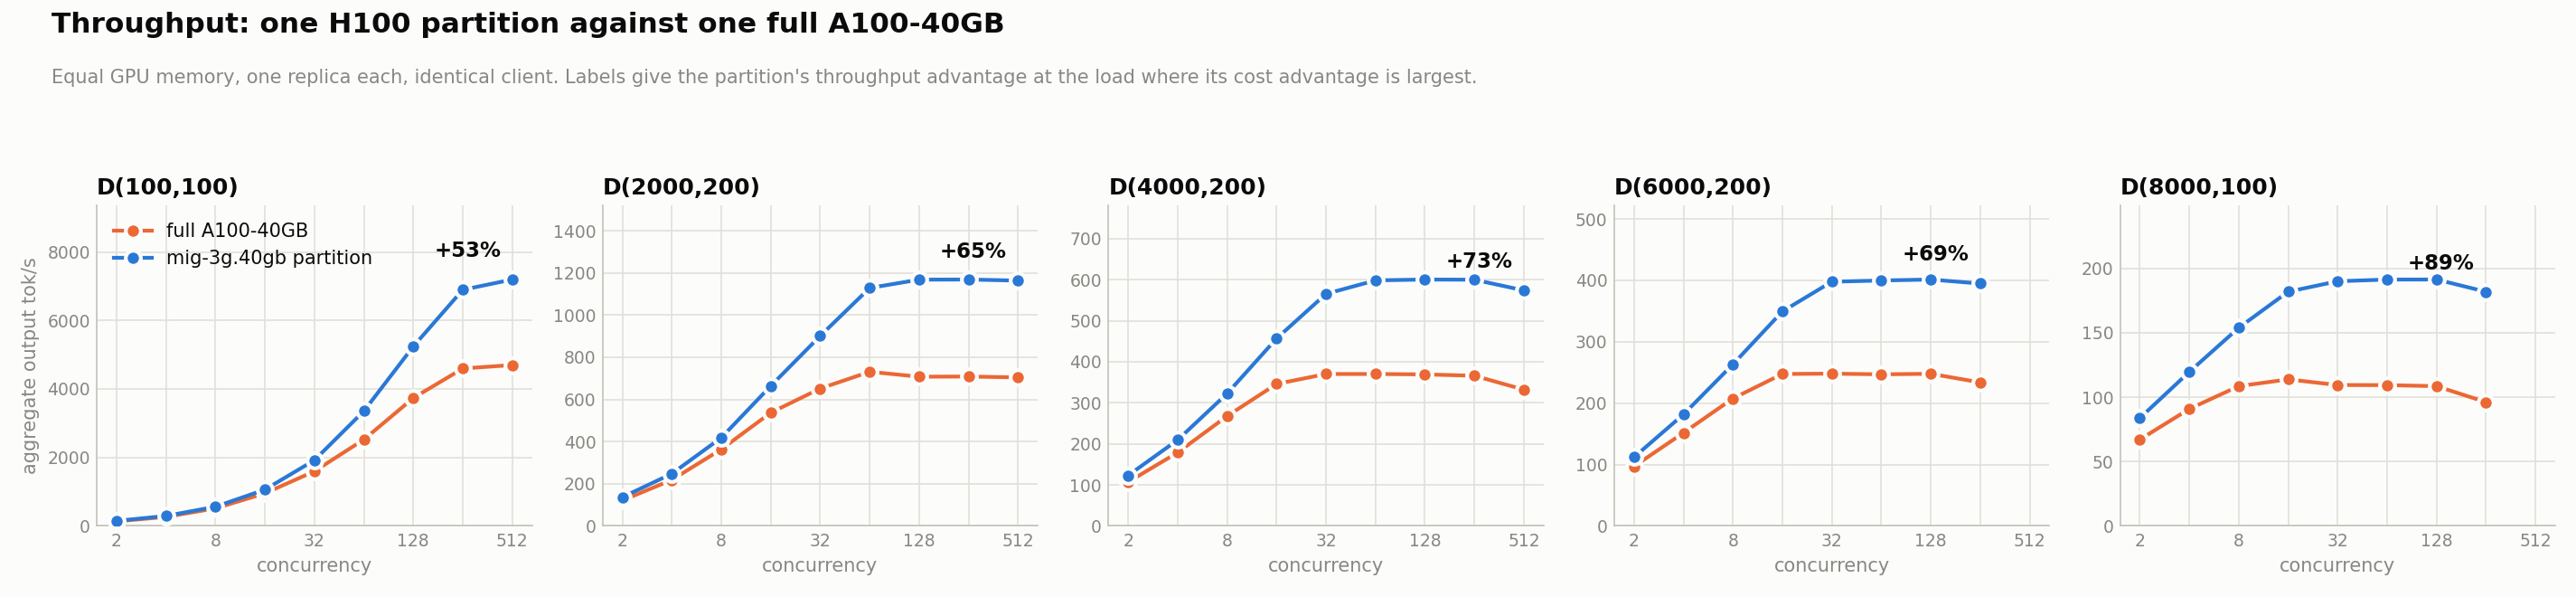
Figure 1: Aggregate output tokens per second for one mig-3g.40gb partition of an H100 against one full A100-40GB, across five traffic shapes and a concurrency ladder from 2 to 512
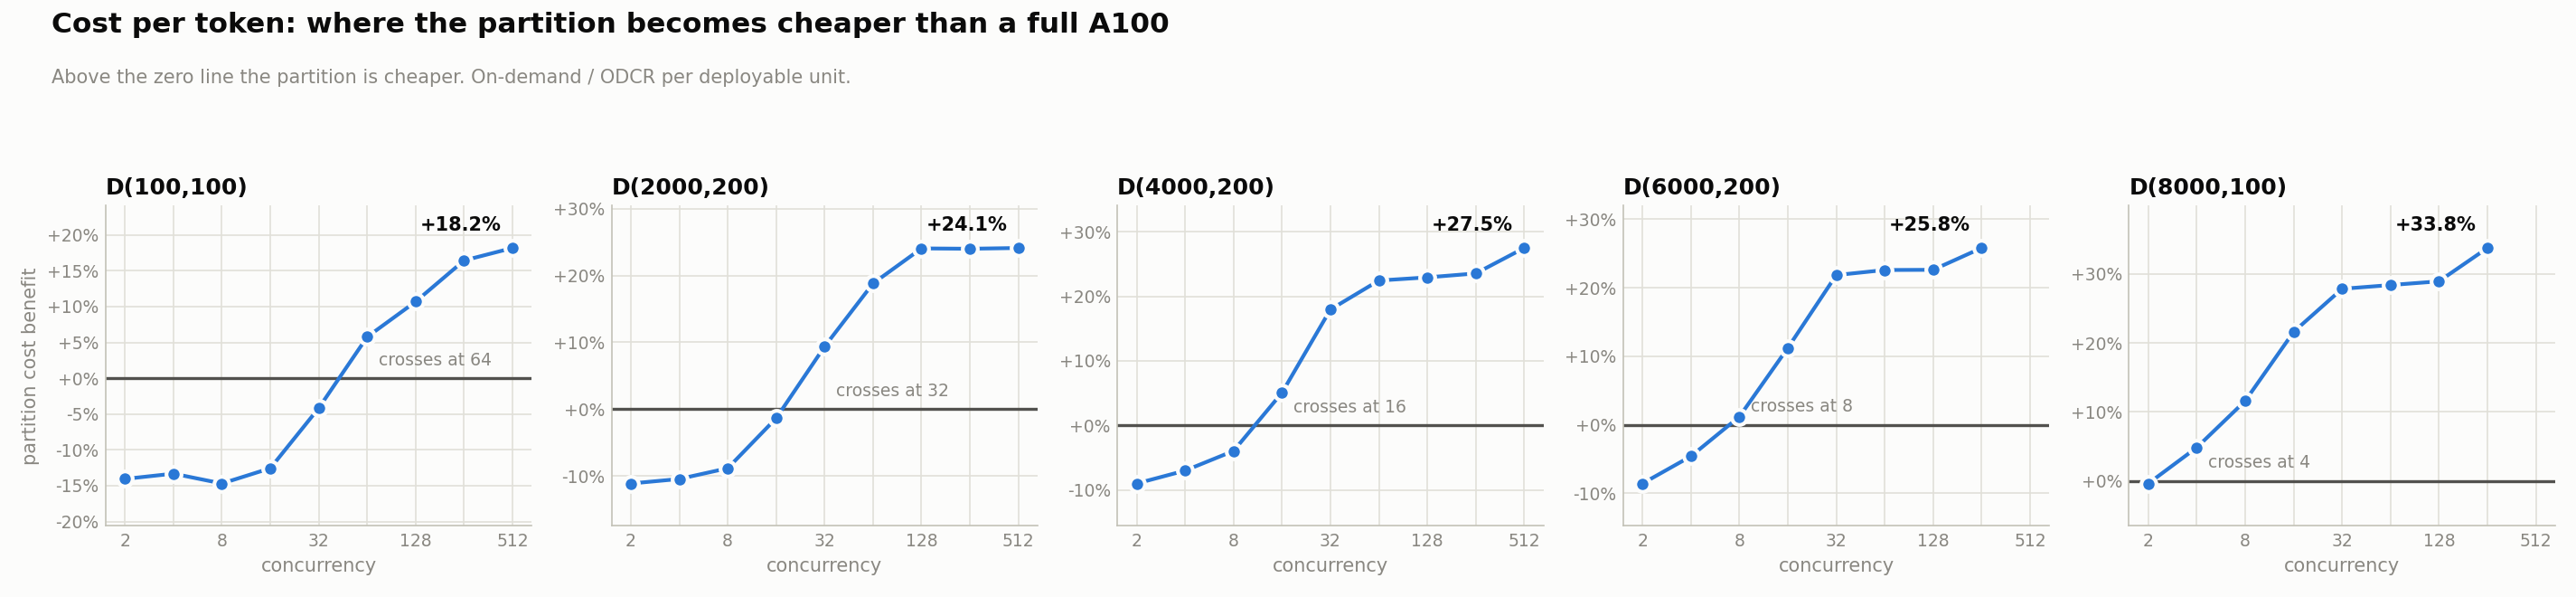
Figure 2: Partition cost benefit per million output tokens against concurrency for the same five traffic shapes
有四点表现尤为显著:
分区在所有场景下都更快 – 在所有场景、所有并发下,分区提供的每秒聚合输出 token 数均更高;在各场景成本效益最大的负载点上,性能优势达到 53% 至 89%;同时在每个场景下 token 间延迟也均更低,降幅达 8.9% 至 42.1%。随着负载增加,差距进一步拉大。 在所有情况下首 token 时间均更短,降低了 5.6% 至 47.5%。 在成本上,每百万输出 token 便宜 18–34%,且拐点随着提示词变长而更早出现。 100 token 提示词的拐点在并发 64,而 8,000 token 提示词在并发 4 时就已越过拐点。在拐点之下,整颗 A100 是更经济的单元。这些价格均基于按需计费,在分析时测算的单价为美国西部(俄勒冈)AWS Region 的 ml.p4d.24xlarge 每小时 25.251286 美元,ml.p5.48xlarge 每小时 63.296000 美元。仅用于我们自己的分析,我们将整台实例的成本除以其承载的单元数推导出单元成本:p4d 上为 8 个单元,p5 上为 16 个单元(此时我们的分区相当于半颗 GPU)。 在长上下文流量的高并发顶点,A100 停止了响应服务。 在 6,000 和 8,000 token 的工作负载下,A100 有三分之一到一半的请求因超时超出服务链路截止期限而失败,而分区则没有发生任何失败。这正是这两张图表中对应曲线提前终止的原因。
请将此视为具体情况具体分析的对比,而非绝对结论。 有益的思维模型是将可用的 GPU 切片视为独立的 GPU 类别。将它们与完整加速卡列在一起,算出您的流量对算力和显存的真实需求,并在您自己的工作负载上进行对照验证。对于高并发、长输入流量,该分区在性能和成本上均胜出。对于短输入或低并发工作负载,整颗 A100 仍然更划算。分区不是一刀切的万能解法。它赋予了您更多规格选项,以便您可以选择最契合您工作负载的那一款。
在确定布局前需要了解的事项
分区会改变端点的形态,在设计端点之前有若干特性值得深入了解。
组件的分区类型在其生命周期内是固定的。将模型迁移到其他 profile 意味着需要创建一个新的组件。更改端点的切分规则意味着需要创建新端点并进行流量迁移,因为更新端点配置不会对正在运行的宿主机重新切分。这使得分区非常契合相对稳定的模型组合,而不适合每天大幅变动的混合场景。
所请求的 profile 必须存在于端点的布局声明中。系统不会降级回整颗加速卡,因此如果组件请求了该变体未声明的 profile,将被直接拒绝。
分区适用于推理组件端点上的实时推理。不支持 Serverless 端点和异构实例池,且异步调用无法直接寻址推理组件,因此异步工作负载不在支持范围内。
您仍将按整台 GPU 实例付费,与目前一致。分区提高了您对该实例的利用率,但不会改变其实例小时单价。
最后,确实需要完整加速卡甚至多卡的模型,应当继续独占整卡。任何分区都无法跨越物理加速卡。
支持的实例与 Region
GPU 分区在 P4d、P5、G7 和 G7e 实例族上提供支持。支持是在实例族级别提供的,因此覆盖该族内更小的尺寸规格。
它在以下 AWS Region 可用:美国东部(弗吉尼亚北部)、美国东部(俄亥俄)、美国西部(俄勒冈)、亚太地区(新加坡)、亚太地区(东京)、欧洲(法兰克福)以及欧洲(爱尔兰)。
各 Region 的实例可用性有所不同,因此请确认您选择的实例类型在目标 Region 有售,且您拥有该实例的端点使用配额。
快速上手
要对 GPU 端点进行分区,请评估您的各个模型所需的显存与算力,挑选契合的 profile,在端点配置上声明布局,并将每个模型作为向该布局请求 profile 的推理组件进行部署。模型的调用方式不会发生任何变化。
有关 API 参考、各实例族的完整 profile 列表以及分步操作演练,请参阅 Amazon SageMaker AI 开发人员指南中的 GPU partitioning。
若要亲自尝试,可运行 GPU partitioning sample notebook,该示例在单个 GPU 端点的各个分区上部署了多个模型。
在进行容量规划时,这一更深远的转变值得牢记。每颗受支持的加速卡现在都提供了多种尺寸规格。对于给定的模型而言,究竟是选择新一代 GPU 的一个分区,还是旧代 GPU 的整颗加速卡,不再是一个需要靠“向上取整”来做决定的问题。这是一个您可以实测验证的选择。
关于作者