在线AI教程 / AI部署
[OpenRouter] Self-Hosted LLM vs API: When Does Self-Hosting Pay Off
自托管 LLM 对比 API:自托管什么时候才划算 OpenRouter ·11/12/2026 如果你为一个开放权重模型付着 API 账单,大概会想:自己买块 GPU 会不会更便
自托管 LLM 对比 API:自托管什么时候才划算
OpenRouter ·11/12/2026
如果你为一个开放权重模型付着 API 账单,大概会想:自己买块 GPU 会不会更便宜。GPU 租金是按小时收的,忙也好闲也好都得付;而 API 只按你用掉的 token 收费。
只有当你的流量能让 GPU 在足够多的时间里保持忙碌,自托管 LLM 才更便宜。按 2026 年 10 月 8 日的价格,一个 27B 模型跑在一块租来的 RTX 3090 上,约 12% 负载即可回本;而一个大型 mixture-of-experts 模型跑在租来的 H200 上,永远赢不了最便宜的 zero-data-retention(ZDR)API endpoint。
本文用我们 API 里各供应商的实时价格算清这个回本点,再说明我们的数据控制如何覆盖隐私需求。
TL;DR
回本负载 = GPU 每小时租金 ÷ 同样一小时 token 走 API 的花费。低于这个负载,API 更便宜。 DeepSeek V4.1 Flash 跑在四块租来的 H200 上,对最便宜的 ZDR endpoint 永远回不了本。跑在两块 B200 上,按我们找到的最低租金也要 76% 负载。 按 10 月 8 日价格,Qwen3.8 27B 跑在一块每小时 $0.50 的 RTX 3090 上,6% 到 12% 负载即可回本,但每个用户只能拿到约 15 token/秒。 外界公布的自托管成本约每百万 token 一美分,多半只算了缓存输入 token——而这类 token 走 API 也几乎不花钱。 多数隐私要求并不需要自托管。provider.zdr 把请求限定在 zero-data-retention endpoint,我们的 EU 与 US 域名则把请求留在区域内。
怎么算自托管划不划算?
取 GPU 的一小时,用两种方式给它定价。一边是租金,另一边是:在用户能接受的速度下,这块 GPU 一小时内能服务的 token,走 API 要收多少钱。
break-even load = GPU rent per hour / API cost of one fully loaded GPU-hour of tokens
回本负载 30% 的意思是:在你租用它的所有小时里,GPU 得有 30% 的时间在忙,才会比 API 便宜。任何超过 100% 的数值,都意味着哪怕 GPU 一刻不停,也是 API 赢。
两边必须按同一种 token 构成来定价,因为输入、缓存输入和输出 token 的 API 价格差别很大。我们还把工程时间、以及为流量高峰预留的余量都排除在外,所以本文每个回本点都是下界。
同一个开放权重模型,API 要花多少钱?
多数开放权重模型由多家供应商提供服务。每一家都在自己的硬件上跑一份自己的权重副本,定自己的价。我们的 endpoints API(GET /api/v1/models/{author}/{slug}/endpoints)返回某模型所有供应商的价格与精度,GET /api/v1/endpoints/zdr 则列出带 ZDR 政策的 endpoint。截至 2026 年 10 月 8 日,它们返回的是:
模型Endpoints(ZDR)输入 $/M缓存输入 $/M输出 $/M qwen/qwen3.8-27b18 (14)0.024 to 0.990.02 to 0.991.49 to 5.25 deepseek/deepseek-v4.1-flash31 (24)0.016 to 0.450.0007 to 0.200.14 to 1.80
同一份权重,最贵供应商对 Qwen3.8 27B 输出的收费是最便宜者的 3.5 倍,对 DeepSeek V4.1 Flash 则接近 13 倍。只拿单一标价算出来的回本点,可能差得很远。供应商提供的精度也从 fp4 到 bf16 不等,我们的 LLM quantization post 测了这会让答案变多少。
真实工作负载我们付了多少
推理模型在作答前会花输出 token 来「思考」,agent 则每一轮都把整段上下文重发一遍。于是我们给每个模型跑两种工作负载,强制启用 ZDR,并用 GET /api/v1/generation 给每次请求定价——它报的是供应商实际计费的 token 与费用:
工作负载模型请求数输入 token(缓存占比)输出 token(推理占比)成本每 100 万输出 token 对一份 5k-token 文档聊天DeepSeek V4.1 Flash1053,330 (68%)12,476 (97%)$0.0110$0.88 8 轮 agent,60k-token 上下文DeepSeek V4.1 Flash8504,747 (75%)28,509 (83%)$0.0243$0.85 对一份 5k-token 文档聊天Qwen3.8 27B1072,329 (56%)25,084 (97%)$0.0694$2.77 7 轮 agent,85k-token 上下文Qwen3.8 27B7595,223 (100%)81,870 (99%)$0.1900$2.32
最后一列是把含输入在内的全部成本除以输出 token。几乎每个输出 token 都是推理 token,而一份自托管的同款模型,产出它们要耗掉同样的 GPU 时间。Qwen3.8 27B 还在 7 个 agent 轮次中的 3 个里,思考途中就撞上了我们 16,000-token 的上限。本文全部 API 运行加起来花了 $0.49。
跑一个自托管 LLM 要花多少钱?
这些 GPU 不是我们自己租的。自托管一侧用的是已公布的 benchmark 和租赁价,所以每一行都请当作假设:
配置每 GPU 吞吐来源每 GPU 小时租金 DeepSeek V4.1 Flash,4x H200,vLLM fp4,32 个并发会话35,084 输入 + 231 输出 tok/s,95% 输入命中缓存,每用户 71 tok/sInferenceX agentic traces,2026-09-21$2.90(InferenceX 零售档)、$4.59(RunPod) DeepSeek V4.1 Flash,2x B200,vLLM fp4,32 个并发会话117,225 输入 + 683 输出 tok/s,96% 缓存,每用户 232 tok/sInferenceX,2026-10-03$3.70(InferenceX 零售)、$6.79(RunPod)、$6.89(Lambda) Qwen3.8 27B,1x RTX 3090,vLLM W4A16,64 并发128 token 进 / 512 出时为 942 输出 tok/s,每用户约 15 tok/sHyperQwen benchmarks$0.50(RunPod),自有卡则约 $0.05 电费(250 W,按 EIA 2026 年 7 月美国居民电价)
DeepSeek V4.1 Flash 有 552B backbone 参数,因此需要多 GPU 节点。Qwen3.8 27B 是稠密模型,4 bit 下能装进一块 24 GB 卡。
吞吐是「每 GPU」口径,与 InferenceX 的报法一致,所以本文每项成本都是每 GPU 小时。每用户速度只计生成回答的那段时间,而这些 agentic 会话有大量时间花在 prefill 上,因此它不能直接乘出总量。3090 那个数字来自 HyperQwen 深度打过补丁的 vLLM 构建,请当作最好情况。
我们用的是它的端到端数字(含 prefill),而不是那个 1,035 tok/s 的纯 decode 头条值。HyperQwen 测的是 128-token prompt,而我们的聊天 prompt 长得多,所以对聊天构成,我们依据它实测的 prefill 与 decode 速率估算为每秒 565 个输出 token。
自托管什么时候才划算?
对每种配置,我们取 benchmark 测出的那一小时 token,拆成未缓存输入、缓存输入和输出,按该模型每一个 ZDR endpoint 给这份构成定价,再用租金去除。API 价格取自 2026 年 10 月 8 日:
配置每 GPU 小时租金同一小时走 API 的成本,最便宜 ZDR / 中位 ZDR对最便宜 ZDR 的回本负载对中位 ZDR 的回本负载 DeepSeek V4.1 Flash,4x H200$2.90$1.70 / $3.54永远不82% DeepSeek V4.1 Flash,4x H200$4.59$1.70 / $3.54永远不永远不 DeepSeek V4.1 Flash,2x B200$3.70$4.87 / $9.9576%37% DeepSeek V4.1 Flash,2x B200$6.79$4.87 / $9.95永远不68% Qwen3.8 27B,1x RTX 3090,短 prompt$0.50$5.89 / $8.358%6% Qwen3.8 27B,1x RTX 3090,我们的聊天构成(估算)$0.50$4.33 / $6.1412%8% Qwen3.8 27B,自有 RTX 3090,仅电费$0.05$5.89 / $8.351%1%
「永远不」指即便 100% 负载,租金也高于 API 成本。价格变动很快。10 月 19 日,Qwen3.8 27B 新增的一个 ZDR endpoint 输出每百万 token 收 $0.50,把短 prompt 的回本点推到了约 29%。
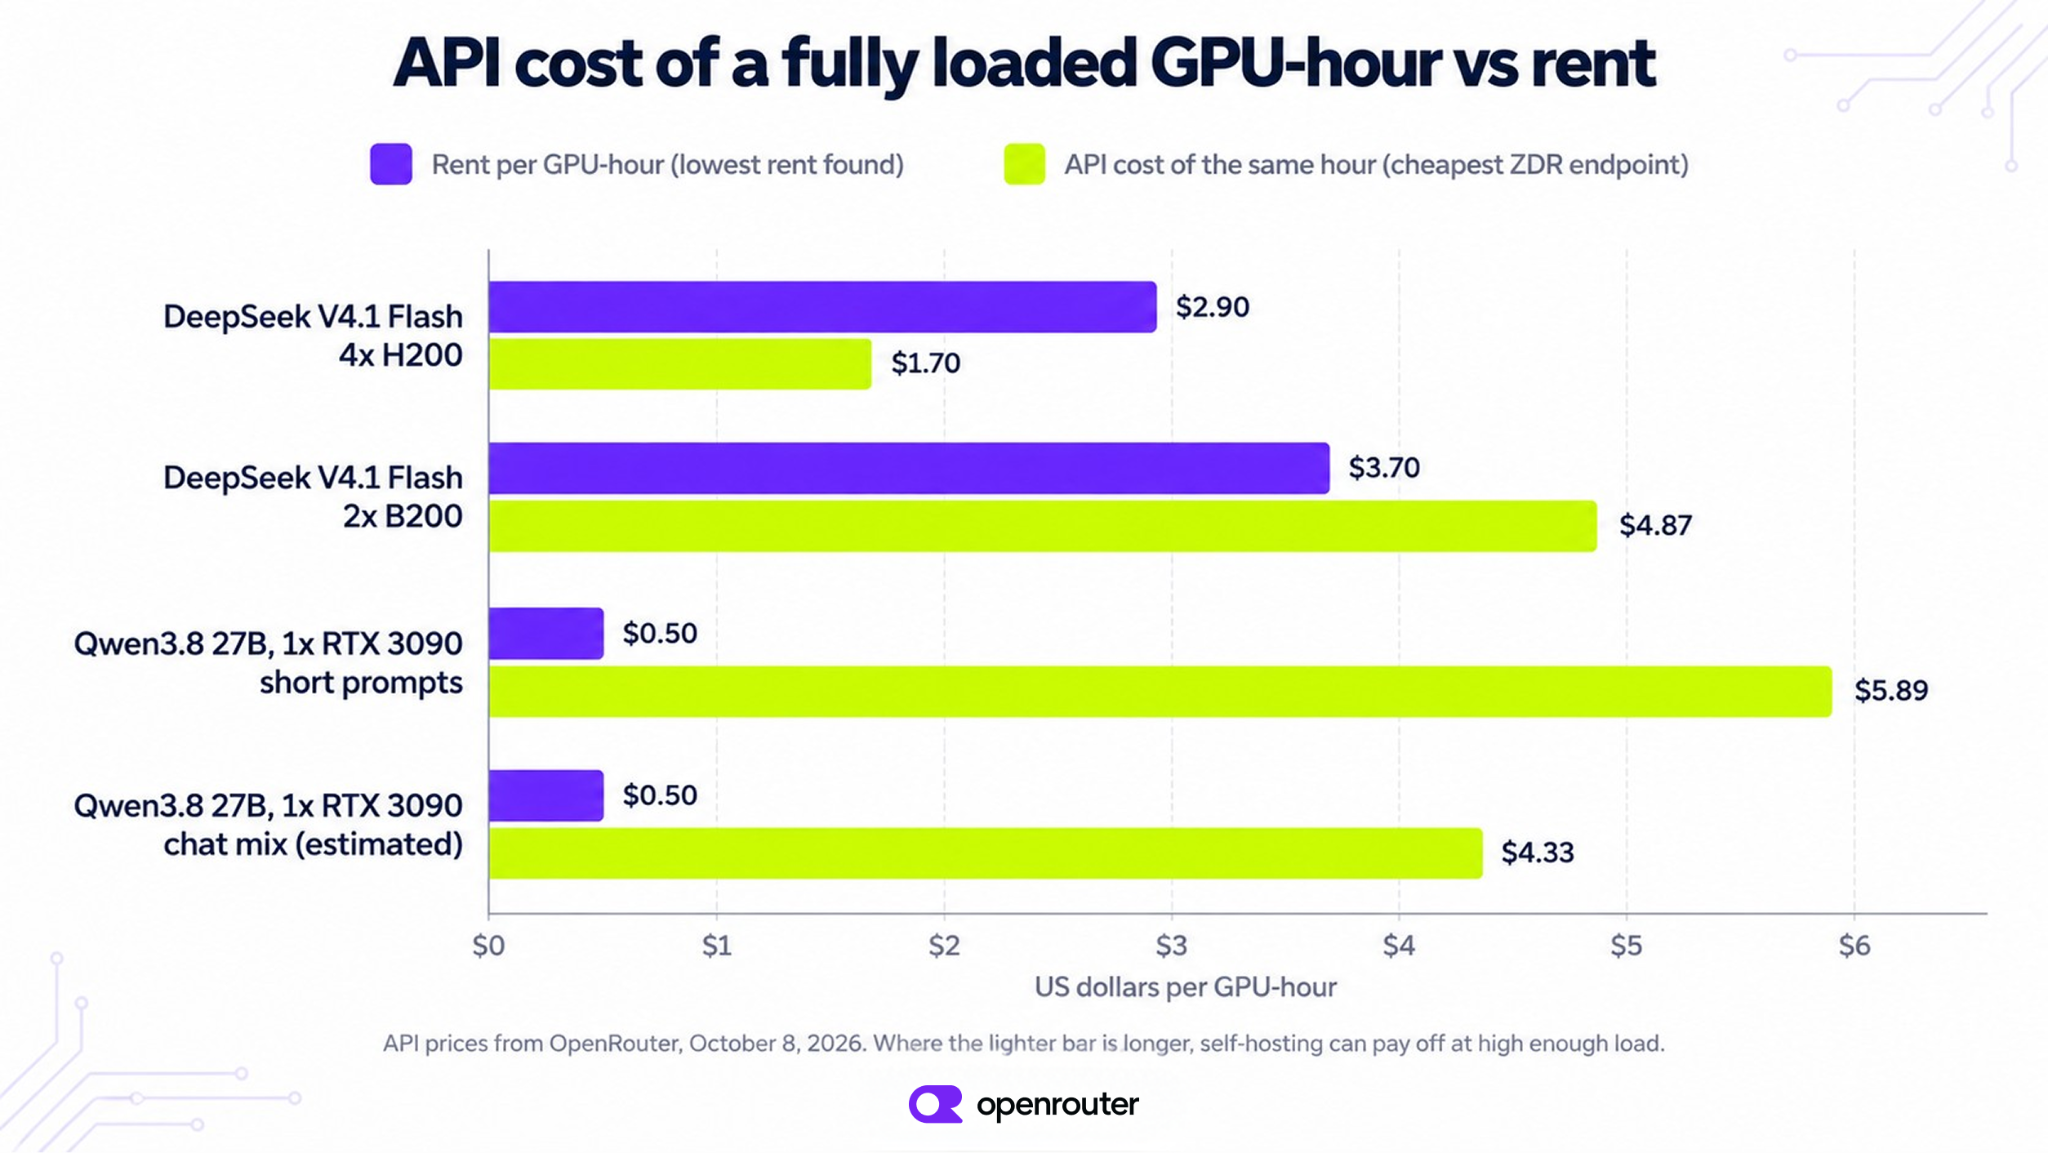
从你实际的负载出发。只在上班时间来的流量,一周 168 小时里占 40 小时,最多让 GPU 忙 24%。按 10 月 8 日价格,这排除了所有 DeepSeek 行,只剩 3090。对照 10 月 19 日那个 endpoint,3090 需要约 29%,所以下单前先查当前价格。一个全天候跑的批处理流水线能到 70%,这按中位 ZDR 价把两行 B200 都带进了射程,但按最便宜价仍一行都不行。
换成月度口径,租来的 3090 每月 $365,在我们这份聊天构成下,跑约 1.7 亿输出 token 后回本。双 B200 节点按零售租金每月 $5,402,得先服务 27 亿输出 token 才能赢过最便宜的 ZDR endpoint。
小模型之所以胜出,是因为它的 API 价格相对所需硬件偏高。供应商对 Qwen3.8 27B 输出每百万 token 收 $1.49 到 $5.25,而一块每小时 $0.50 的卡一小时能产出约 340 万个这样的 token。DeepSeek V4.1 Flash 正相反:24 个 ZDR endpoint 争它的流量,最便宜的每百万输出 token 只收 $0.18。
3090 的低成本附带着速度上的取舍。它是靠同时服务 64 个请求、每个约 15 token/秒才达到那个吞吐的。这对聊天界面已经偏慢,对一个在作答前要写数千个隐藏 token 的推理模型就更慢。在我们拉取数据前 30 分钟里,Qwen3.8 27B 的 18 个 API endpoint 中位速度为 45 token/秒,最快的是 474。
为什么公布出来的自托管成本看着那么低?
如果你见过自托管被报成每百万 token 约一美分,原因通常在 token 构成。InferenceX 按 hyperscaler 价格,把 H200 上的 DeepSeek V4.1 Flash 算作每百万 token $0.012。那个数字是每百万总 token,而在它的 agentic 工作负载里,99% 是输入 token,其中 95% 由 prefix cache 命中。走 API 时,该模型的缓存输入每百万只要 $0.0007 到 $0.20,所以这些 token 无论哪边都便宜。
改按输出 token 计价,同样这块 H200 在 $2.90 零售租金下,还没算任何输入就是每百万 $3.49;而最便宜的 ZDR endpoint 收 $0.18。
为了隐私,需要自托管吗?
隐私是自托管的另一个常见理由,而其中大部分需求走 API 就能满足。在请求上设 provider.zdr,会把它限定在「供应商不存储你的 prompt 或 completion」的 endpoint。若你的 ZDR 设置还允许 Safety Retention endpoint,那些 endpoint 可能为检测滥用而保留 prompt 和响应,所以只有在你完全不需要留存时才选纯 ZDR。带隐式缓存的供应商也可能短时间持有派生出的 KV-cache 数据,见我们的 implicit caching explainer。你也可以在全账户、按模型组,或在覆盖特定 API key 的 guardrail 里强制 ZDR。在 Business 和 Enterprise 套餐里,发往 eu.openrouter.ai 或 us.openrouter.ai 的请求只跑在该区域内的 endpoint 上,出不去时宁可失败也不离开。
下面这个脚本把两条路径都试了一遍,其中两次请求我们预期会失败:
"""The privacy paths: ZDR per request, a ZDR conflict, and EU in-region routing.""" import os
import requests
KEY = {"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"} MSG = [{"role": "user", "content": "Reply with the word ok."}]
def ask(base, model, provider=None): body = {"model": model, "messages": MSG, "max_tokens": 400, "provider": provider or {}} r = requests.post(f"{base}/api/v1/chat/completions", json=body, headers=KEY, timeout=120) data = r.json() if r.status_code == 200: return f"{r.status_code} served by {data['provider']}" return f"{r.status_code} {data['error']['message']}"
GLOBAL, EU = "https://openrouter.ai", "https://eu.openrouter.ai"
print("1. ZDR on, any provider: ", ask(GLOBAL, "deepseek/deepseek-v4.1-flash", {"zdr": True})) print("2. ZDR on, only DeepSeek API:", ask(GLOBAL, "deepseek/deepseek-v4.1-flash", {"zdr": True, "only": ["deepseek"]})) print("3. EU domain, DeepSeek: ", ask(EU, "deepseek/deepseek-v4.1-flash")) print("4. EU domain, GLM 5.3 + ZDR: ", ask(EU, "z-ai/glm-5.3", {"zdr": True}))
eu_models = requests.get(f"{GLOBAL}/api/v1/models", params={"region": "eu"}, timeout=60).json()["data"] print(f"5. models eligible for EU in-region routing: {len(eu_models)}")
2026 年 10 月 8 日记录的输出:
- ZDR on, any provider: 200 served by Decart
- ZDR on, only DeepSeek API: 404 No endpoints found matching your data policy (Zero data retention). Configure:
- EU domain, DeepSeek: 404 No endpoints found supporting your data region.
- EU domain, GLM 5.3 + ZDR: 200 served by Inceptron
- models eligible for EU in-region routing: 72
两道过滤都在我们挑供应商之前生效,因此它们缩小的是候选 endpoint 列表,而不是事后改路由。开了 zdr 后,DeepSeek 自家 API 因为会留存数据而出局;再用 only 把请求钉死在该供应商上,就一个 endpoint 都不剩,于是返回第一个 404。EU 域名只保留我们在欧洲接入的 endpoint。DeepSeek V4.1 Flash 一个都没有,所以第三次请求失败,而不是悄悄跑去美国。要用 EU 路由,就从 GET /api/v1/models?region=eu 里挑一个有 EU endpoint 的模型,那次列出了 72 个模型,其中包括 GLM 5.3。
ZDR 有一个边界。你的 prompt 仍在供应商的 GPU 上被处理,所以它并不给你对硬件的控制权。若你的政策要求模型跑在你自己掌控的部署上,Private Endpoints(Enterprise 套餐)会把你专属或微调过的部署加进某个目录模型的供应商列表。它必须托管在我们支持 BYOK 的供应商处,你的团队用同一个 slug 调用它,若你把公共 endpoint 也列进去,它们仍可作为回退保留。若数据绝不能离开你自管的硬件,那就自托管,并按上面的回本表给硬件定容。我们的 ZDR explainer 和 data residency guide 更细地比较了这些选项。
能既自托管又用 API 吗?
能,而且对多数团队来说,回本表指向的正是这种搭配。GPU 只在高负载下才划算,所以按你流量的稳定基线给自有硬件定容——在那儿它一直忙;把高峰溢出的部分交给 API——在那儿你只为用掉的付钱。
之所以行得通,是因为 vLLM 和 SGLang 暴露的是与我们相同的 OpenAI-compatible chat API。客户端只要改 base URL、key 和模型名就能在两者间切换。连接出错、或你的服务器队列满时返回 429 / 503,就回退到 API。在 API 一侧设 provider.zdr,让溢出流量也保持 zero data retention。若你的政策要求 prompt 留在自管硬件上,就别往 API 溢出。
这套搭配有两处会出问题。若你本地副本的精度与 API endpoint 不同,同一个 prompt 可能得到不同答案,因此要用 provider routing 把 API 一侧钉到相匹配的量化。另外,一段对话中途换后端会丢掉它的 prompt cache,所以每场对话一旦开始就固定留在其中一侧。
常见问题
自托管 LLM 值得吗?
单看成本,只有你能让 GPU 保持忙碌时才值得。按我们的数字,Qwen3.8 27B 跑在租来的 RTX 3090 上,6% 到 12% 负载回本;DeepSeek V4.1 Flash 跑在租来的数据中心 GPU 上,需要 37% 以上负载,且对最便宜的 zero data retention endpoint 往往永远回不了本。隐私与可控性则可以在任何负载下为自托管提供理由。
哪个 LLM 最适合自托管?
能装进一块 GPU 的模型最合适,因为既避开了多 GPU 服务器,其 API 价格也留出了最大的省钱空间。例如 Qwen3.8 27B 在 4 bit 下能跑在一块 24 GB 卡上。我们的 rankings 和 open-weight vs closed-weight comparison 展示了开发者用得最多的模型。
最便宜的自托管 LLM 方案是什么?
一块你已经拥有的 GPU。一块限到 250 W 的 RTX 3090,按 2026 年 7 月美国居民平均电价,每小时电费约 $0.05,因此只要忙约 1% 的时间,就赢过 Qwen3.8 27B 最便宜的 zero data retention endpoint。代价是每个用户响应更慢,以及你自己花在维护上的时间。
我能托管自己的模型、还照样通过 OpenRouter 用吗?
能,在 Enterprise 套餐里。Private Endpoints 把某个目录模型的 slug 路由到你自己专属或微调过的部署,托管在我们支持 BYOK 的供应商处。只有你批准的用户和组织能看见或调用它。
下一步
Zero Data Retention:按请求、按模型组、在 guardrail 里或全账户强制 ZDR。 In-Region Routing:通过 EU 与 US 域名发请求,并用 guardrail 强制区域。 DeepSeek V4.1 Flash 与 Qwen3.8 27B 的模型页列出当前各供应商价格与吞吐。