在线AI教程 / AI部署
[Amazon Bedrock] 用 Amazon SageMaker HyperPod Data Capture 构建模型改进飞轮
人工智能 用 Amazon SageMaker HyperPod Data Capture 构建模型改进飞轮 部署在 Amazon SageMaker HyperPod 上的基础模
人工智能
用 Amazon SageMaker HyperPod Data Capture 构建模型改进飞轮
部署在 Amazon SageMaker HyperPod 上的基础模型,会遇到任何预先整理好的数据集都覆盖不到的输入:特定领域的行话、意料之外的格式、新产品,以及不断变化的用户行为。如果没有生产推理数据的记录,团队就无法检测漂移、找出失败模式,也无法用真实交互来改进模型。
Amazon SageMaker HyperPod 现在提供 Data Capture,这是一项内置能力,可在三个独立的层把实时推理的输入和输出记录到 Amazon Simple Storage Service (Amazon S3),对延迟的影响极小,对模型可用性零影响。
本文在单个 SageMaker HyperPod 集群上完整演练一个示例。一个家电售后工单路由器捕获自己的生产流量,Amazon Athena 查询暴露出新产品盲区,一条 SQL 策略给捕获记录打上标签,再用这些数据做一次微调,让路由器学会认识新产品。我们在模型部署前根本不可能存在的数据上,测量微调前后的准确率。推理算子在一个节点上提供模型服务,训练算子在另一个节点上运行微调。
演练使用合成数据。脚本、清单、SQL、合成数据集和预期输出都放在随附的 GitHub 仓库里。
三层 Data Capture 架构
HyperPod Data Capture 提供三个独立的层,各自位于请求路径上的不同位置。你可以在同一个 dataCapture 块里开启任意组合。
第 1 层:SageMaker endpoint第 2 层:负载均衡器第 3 层:模型 Pod 捕获内容完整的请求/响应 payloadApplication Load Balancer (ALB) 访问日志字段:请求行、状态码、耗时、客户端 IP、user agent完整的请求/响应 payload 以及事件元数据 管理方SageMaker 原生数据捕获ALB 访问日志HyperPod 推理算子(NGINX + OTel collector + S3 uploader sidecar) 最适用于合规、Model Monitor、审计低成本的流量与错误率监控调试、分析、训练数据采集 配置sagemakerEndpoint: — 采样 %、输入/输出、AWS KMSloadBalancer: { enabled: true }modelPod: — 采样 %、输入/输出、buffer、最大 payload 大小、AWS KMS、内容类型
第 1 层和第 3 层都存完整的 payload,两层同时开启会把每条记录存两遍。合规和 Model Monitor 用第 1 层,只需要流量元数据时用第 2 层,打算真正使用 payload 时用第 3 层。本文只用第 3 层。由于第 3 层记录的是完整 payload,其中可能包含姓名、地址和订单号,所以要在这些数据变成训练数据之前先做好保护:用采样、AWS Key Management Service (AWS KMS) 加密(kmsKeyId)、S3 生命周期规则,以及 personally identifiable information (PII) 脱敏(例如借助 Amazon Comprehend)。
先决条件
一个由 Amazon Elastic Kubernetes Service (Amazon EKS) 编排的 SageMaker HyperPod 集群,已安装推理算子(为模型部署设置 HyperPod 集群),并已安装训练算子的 EKS add-on amazon-sagemaker-hyperpod-training-operator(安装训练算子)。 两块可用的 NVIDIA GPU,一块用于提供服务,一块用于训练。我们用 ml.g6e.8xlarge 提供服务、ml.g6e.xlarge 做训练(各配一块 48 GB NVIDIA L40S)。提供服务的 Pod 在 endpoint 的整个生命周期里一直占着它的 GPU,所以只有一块 GPU 时,训练 Pod 会一直停在 Pending。 已为该集群配置好 kubectl。 同一区域里的一个 S3 存储桶。
确认两个算子都已安装。该命令返回两行:
kubectl get crd | grep -E 'inferenceendpointconfigs|hyperpodpytorchjobs' hyperpodpytorchjobs.sagemaker.amazonaws.com 2026-09-21T10:57:14Z inferenceendpointconfigs.inference.sagemaker.aws.amazon.com 2026-08-06T11:58:53Z
方案概览
下图展示了在单个 SageMaker HyperPod 集群上完成演练的五个步骤:把每个请求和响应都捕获到 Amazon S3、用 Athena 分析捕获结果、用一条 SQL 策略打标签、借训练算子在第二块 GPU 上微调,以及在捕获仍开启的情况下并排重新部署。
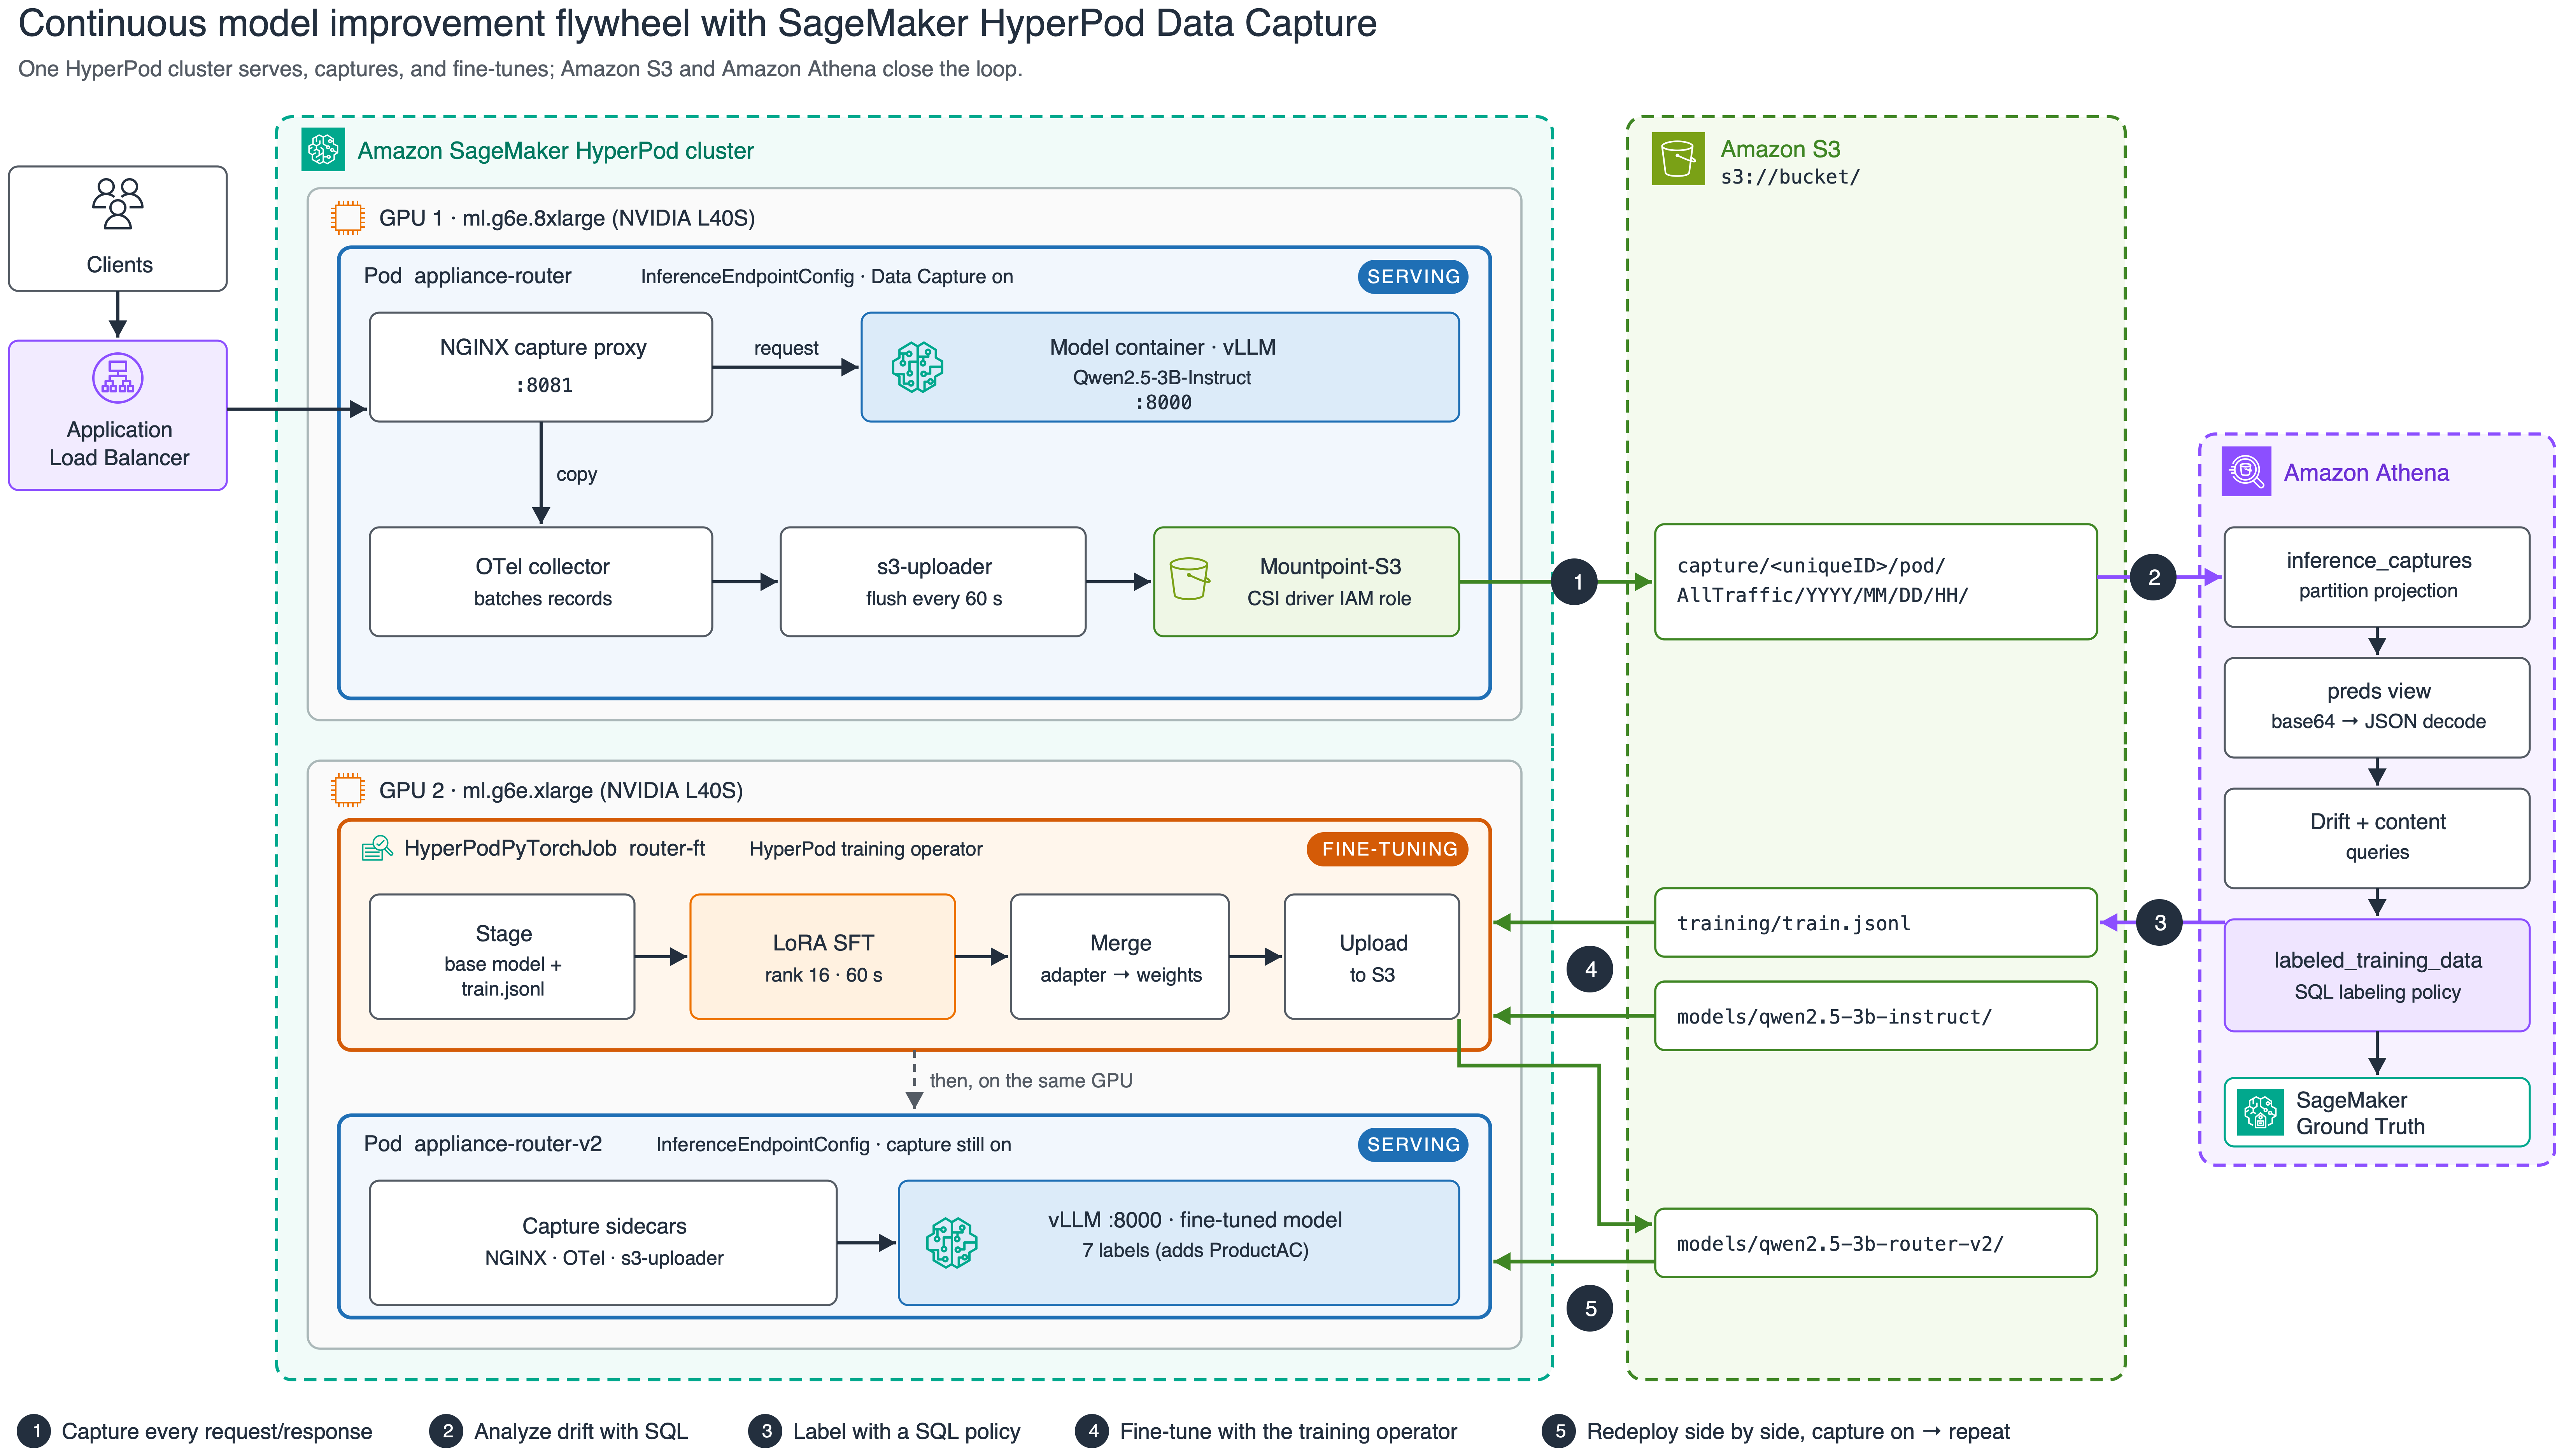
图 1:单个 SageMaker HyperPod 集群上的五步飞轮,从捕获、Athena 分析、打标签、微调到重新部署
推理算子给模型 Pod 加三个 sidecar。穿过 NGINX 代理的每个请求都会被复制到 OpenTelemetry collector,批量处理后经一个 Mountpoint-S3 卷写入 S3。Athena 就地读取这些文件。训练算子把微调作为 HyperPodPyTorchJob 跑在第二块 GPU 上,新模型由同样开启捕获的第二个 endpoint 提供服务。
第 0 步:设置变量
后面每一步都会用到这些变量。改好第一块,再把整段一起粘贴:
--- edit these ---
export EKS_CLUSTER_NAME="my-hyperpod-eks" export AWS_REGION="us-east-1" export BUCKET="amzn-s3-demo-bucket" export SERVE_INSTANCE_TYPE="ml.g6e.8xlarge" # node type for the first endpoint export TRAIN_INSTANCE_TYPE="ml.g6e.xlarge" # node type for the fine-tuning job
--- leave as-is ---
export AWS_DEFAULT_REGION="$AWS_REGION" export ENDPOINT_NAME="appliance-router" export MODEL_LOCATION="models/qwen2.5-3b-instruct" export MODEL_V2_LOCATION="models/qwen2.5-3b-router-v2" export TRAIN_SA="flywheel" # service account with S3 access via EKS Pod Identity aws eks update-kubeconfig --name "$EKS_CLUSTER_NAME" --region "$AWS_REGION" render() { python3 -c 'import os,sys; sys.stdout.write(os.path.expandvars(sys.stdin.read()))'; }
第 1 步:把基础模型暂存到 S3
我们用 Qwen2.5-3B-Instruct,因为它小到大约一分钟就能微调完,而且单块 L40S 放得下。
pip install -q huggingface_hub python3 -c "from huggingface_hub import snapshot_download; \ snapshot_download('Qwen/Qwen2.5-3B-Instruct', local_dir='qwen2.5-3b-instruct')" aws s3 sync qwen2.5-3b-instruct "s3://${BUCKET}/${MODEL_LOCATION}/" --exclude ".cache/*"
第 2 步:IAM 权限
有四个身份需要权限。策略语句参见 HyperPod 上的推理数据捕获。
Mountpoint-S3 CSI driver 角色。 第 3 层捕获通过 Mountpoint-S3 卷写入,driver 以它自己的 IAM roles for service accounts (IRSA) 角色做认证,而不是用 Pod 的服务账户。它需要在捕获存储桶上有 s3:PutObject、s3:AbortMultipartUpload、s3:DeleteObject 权限;如果设置了 kmsKeyId,还要 kms:Decrypt、kms:GenerateDataKey、kms:DescribeKey。缺了这些,endpoint 依然健康、请求照样成功,但不会出现任何捕获。参见 Mountpoint for Amazon S3 CSI driver。 推理算子的执行角色。 它需要在捕获存储桶上有 s3:PutObject;如果设置了 kmsKeyId,还要 kms:Decrypt 和 kms:GenerateDataKey。捕获文件本身是通过 CSI driver 角色写入的,所以没有捕获出现时,先查这个角色。 训练 Pod 的服务账户($TRAIN_SA)。 通过 EKS Pod Identity 获得对基础模型和训练数据的读权限,以及对合并后模型的写权限。 Athena。 对捕获前缀的读权限,再加一个查询结果存放位置。
启用 Data Capture
接下来三步会部署开启第 3 层捕获的路由器,确认 Pod 跑起了捕获 sidecar,并核实记录确实到达了 Amazon S3。
第 3 步:部署开启第 3 层捕获的模型
整个功能就是这个 dataCapture.modelPod.enabled: true 块。其余部分都是一次普通的 vLLM 部署。
cat > endpoint.yaml <<'YAML' apiVersion: inference.sagemaker.aws.amazon.com/v1 kind: InferenceEndpointConfig metadata: name: ${ENDPOINT_NAME} namespace: default spec: replicas: 1 modelName: ${ENDPOINT_NAME} endpointName: ${ENDPOINT_NAME} instanceType: ${SERVE_INSTANCE_TYPE} invocationEndpoint: v1/chat/completions modelSourceConfig: modelSourceType: s3 modelLocation: ${MODEL_LOCATION} s3Storage: bucketName: ${BUCKET} region: ${AWS_REGION}
>>> This is all you need to turn on Tier 3 data capture <<<
dataCapture: s3Uri: "s3://${BUCKET}/capture/" modelPod: enabled: true initialSamplingPercentage: 100 bufferConfig: batchSize: 50 flushIntervalSeconds: 60 payloadConfig: maxPayloadSizeKB: 1024
worker: image: vllm/vllm-openai:v0.10.0 modelInvocationPort: containerPort: 8000 name: http modelVolumeMount: mountPath: /opt/ml/model name: model-weights args: ["--model", "/opt/ml/model", "--served-model-name", "${ENDPOINT_NAME}", "--port", "8000", "--max-model-len", "2048", "--gpu-memory-utilization", "0.90"] resources: requests: { cpu: "2", memory: 16Gi, nvidia.com/gpu: 1 } limits: { nvidia.com/gpu: 1 } YAML render < endpoint.yaml | kubectl apply -f -
上面这个 modelPod 块设了 100% 采样,同时捕获输入和输出——这两项本来就是默认值。要调整的话,在 modelPod 下加这些可选字段中的任意几个:
modelPod: enabled: true initialSamplingPercentage: 50 # capture 50% of requests (default 100) bufferConfig: batchSize: 100 # records buffered per upload batch (default 10) flushIntervalSeconds: 60 # max seconds before a flush (default 60) payloadConfig: maxPayloadSizeKB: 1024 # truncate payloads larger than this (default: no limit) kmsKeyId: "arn:aws:kms:...:key/..." # encrypt captures at rest
第 4 步:等待 Pod 就绪
开启捕获的 Pod 会跑 四个容器:模型、sidecar-reverse-proxy (NGINX)、otel-collector 和 s3-uploader。模型容器和 Pod 的 app 标签都以 modelName 命名。
kubectl get pods -l app=$ENDPOINT_NAME -o custom-columns=\ 'NAME:.metadata.name,READY:.status.containerStatuses[].ready,CONTAINERS:.spec.containers[].name,NODE:.spec.nodeName' NAME READY CONTAINERS NODE appliance-router-849f466476-4f5v8 true,true,true,true appliance-router,s3-uploader,sidecar-reverse-proxy,otel-collector hyperpod-i-0f3fe2684afd6a583
在我们的这次运行里,kubectl apply 之后大约五分钟 Pod 才就绪,其中大部分时间花在下载权重上。
第 5 步:发一个请求,确认捕获落到 S3
通过端口 8081 上的捕获代理发一个推理请求,等过一个刷新间隔后,列出捕获前缀。模型本身监听 8000 端口,发到那里的请求会绕过代理,不会被捕获。
POD=$(kubectl get pod -l app=$ENDPOINT_NAME -o jsonpath='{.items[0].metadata.name}') kubectl port-forward "pod/$POD" 18081:8081 >/dev/null 2>&1 & sleep 5
curl -s \ -H 'Content-Type: application/json' \ -d '{"model":"'"$ENDPOINT_NAME"'","messages":[{"role":"user","content":"my fridge is not cooling"}],"max_tokens":24}'
echo "Waiting for the capture buffer to flush..."; sleep 75 aws s3 ls "s3://${BUCKET}/capture/" --recursive | grep '\.jsonl