在线AI教程 / AI部署
[Amazon Bedrock] Amazon SageMaker JumpStart 上的 OpenFold3:预测生物分子结构
人工智能 Amazon SageMaker JumpStart 上的 OpenFold3:预测生物分子结构 你可以从 Amazon SageMaker JumpStart 部署 O
人工智能
Amazon SageMaker JumpStart 上的 OpenFold3:预测生物分子结构
你可以从 Amazon SageMaker JumpStart 部署 OpenFold3-preview。OpenFold Consortium 与哥伦比亚大学 AlQuraishi Lab 将 OpenFold3 开发为开源生物分子结构预测模型。只需几行代码,通常就能把 OpenFold3 部署到你自己的 AWS 账户中。随后你可以预测蛋白质、DNA、RNA、小分子配体及其所形成复合物的 3D 结构。该 endpoint 在网络隔离下运行,可借此把序列留在你的 AWS 账户内。
如今,计算药物发现团队把结构预测当作工作的核心环节,用于靶点识别、抗体与蛋白质工程,以及基于结构的虚拟筛选。但团队发现,运行这类模型并不轻松:需要 GPU 基础设施、能正常工作的 CUDA 与 PyTorch 软件栈、体积庞大的模型 checkpoint,还要有一层能处理耗时数分钟而非数毫秒的请求的服务层。SageMaker JumpStart 可以替你承担其中大部分工作。OpenFold3 运行在托管式 Amazon SageMaker AI endpoint 上一个由 AWS 维护的容器里。该 endpoint 负责请求排队与 GPU 预热,你也可以再加上 autoscaling。
在这篇文章里,我们会展示如何:
在 SageMaker 异步推理 endpoint 上部署 OpenFold3-preview。 提交结构预测作业并解读结果,包括预测结构与置信度分数。 在多 GPU 实例上并行运行多个预测。 提供你自己的多序列比对(MSA)来提高预测准确度,同时帮助保持序列私密。 在空闲时把 endpoint 缩容到零,帮助降低成本。
OpenFold3 概述
OpenFold3 是一个全原子结构预测模型,根据一组分子的序列预测它们的联合 3D 结构。它并不局限于单条蛋白质链:一次预测就能折叠多链蛋白质复合物、蛋白质–核酸组装体以及蛋白质–配体复合物。
属性详情 开发者OpenFold Consortium / 哥伦比亚大学 AlQuraishi Lab 模型类型全原子生物分子结构预测 输入蛋白质、DNA 和 RNA 序列;小分子配体以 SMILES 表示 输出mmCIF 格式的预测结构,附带置信度指标(pLDDT、PAE、PDE) 版本OpenFold3 0.4.1,of3-p2-155k checkpoint 许可证Apache 2.0 JumpStart 模型 IDhuggingface-proteinfolding-openfold3 支持的实例ml.g6.2xlarge、ml.g6.4xlarge(默认)、ml.g6.12xlarge
OpenFold3 的开发者以 Apache 2.0 许可证发布代码和模型权重,并公开训练数据与方法。研究机构和制药公司可以按该许可证的条款审查模型、对它做 fine-tuning,并在其基础上继续开发。开发者把 OpenFold3-preview 定位为研究预览版。
使用场景
靶点与复合物结构预测 – 为没有实验结构的靶点预测结构,包括多链组装体和蛋白质–核酸复合物。 蛋白质–配体共折叠 – 把蛋白质与以 SMILES 提供的小分子一起折叠,为基于结构的设计生成结合姿态假设。 抗体与蛋白质工程 – 通过预测结构并比较各候选体的置信度来评估设计出的变体。 高通量筛选流水线 – 把大批量预测作业排入一个 autoscaling endpoint,并直接从 Amazon Simple Storage Service (Amazon S3) 处理结果。
为什么 OpenFold3 采用异步推理
大多数 JumpStart 模型(例如大语言模型和嵌入模型)部署到实时 endpoint。实时 endpoint 在单次请求内返回结果,而该请求上限为 60 秒。结构预测则不同:折叠时间随查询中链的数量和长度增长,现实中的蛋白质与复合物往往要花几分钟。
因此,JumpStart 上的 OpenFold3 运行在 SageMaker Asynchronous Inference 上:
把请求上传到 Amazon S3 并调用 InvokeEndpointAsync,调用会立即返回。 endpoint 把请求排队并处理,调用超时最长 1 小时。 endpoint 把结果或错误详情写入你指定的 S3 位置。你可以轮询它,也可以通过 Amazon Simple Notification Service (Amazon SNS) 收到通知。
异步 endpoint 有两个特性尤其适合科学工作负载。其一,它在内部对突发请求排队,因此你可以一次提交大批量序列,而不必自己搭一套作业队列。其二,队列为空时它可以缩容到零实例,帮你避免为两次实验之间的空闲实例付费。
先决条件
要跟着这篇演练动手,你需要:
一个 AWS 账户,以及供 endpoint 使用的 SageMaker AI 执行角色。遵循最小权限原则,这个 AWS Identity and Access Management (IAM) 角色只需对你用于存放请求与结果的 S3 前缀拥有读写权限。更多信息请参阅如何使用 SageMaker AI 执行角色。 运行代码的身份所需的 IAM 权限:创建、描述、调用和删除模型、endpoint 配置与 endpoint,以及对执行角色的 iam:PassRole。若要完成可选的「缩容到零」小节,还需要 AWS Application Auto Scaling 和 Amazon CloudWatch 告警权限。在生产环境中,请把这些权限限定到你的资源,而不要使用 AmazonSageMakerFullAccess 这类宽泛的托管策略。更多信息请参阅异步推理的完成先决条件。 能访问 Amazon SageMaker Studio、SageMaker 笔记本实例或本地 IDE。 SageMaker Python SDK v3 和 py3Dmol,可用 pip install "sagemaker>=3,<4" py3Dmol 安装。 你的 AWS Region 中至少一个 ml.g6.4xlarge endpoint 实例的服务配额;如果要照着多 GPU 小节操作,还需要 ml.g6.12xlarge 的配额。你可以在 Amazon SageMaker 下的 Service Quotas 控制台 查看配额并申请提升。
重要:SageMaker endpoint 在运行期间按实例小时计费,空闲时同样计费。为避免意外产生费用,请按「清理」小节操作,或按本文后面所述配置缩容到零。定价详情请参阅 Amazon SageMaker AI 定价。
在 SageMaker JumpStart 中找到 OpenFold3
打开 SageMaker Studio,在导航窗格中选择 JumpStart。 搜索 OpenFold3。 打开模型卡片,查看模型说明、许可证和支持的实例类型。 从模型卡片打开示例 notebook。其中包含本文展示的完整异步部署演练。
用 SageMaker Python SDK 部署 OpenFold3
首先,根据 JumpStart 配置构建模型,并定义 AsyncInferenceConfig。output 与 failure 路径是 endpoint 写入结果和错误详情的 S3 位置。
import json, time, uuid import boto3 from sagemaker.core.helper.session_helper import Session from sagemaker.core.inference_config import AsyncInferenceConfig from sagemaker.core.jumpstart.configs import JumpStartConfig from sagemaker.core.training.configs import Compute from sagemaker.serve.model_builder import ModelBuilder
session = Session() bucket = session.default_bucket() # sagemaker-{region}-{account-id} prefix = "openfold3-async"
model_builder = ModelBuilder.from_jumpstart_config( jumpstart_config=JumpStartConfig( model_id="huggingface-proteinfolding-openfold3", accept_eula=True, ), compute=Compute(instance_type="ml.g6.4xlarge"), ) model = model_builder.build()
async_config = AsyncInferenceConfig( output_path=f"s3://{bucket}/{prefix}/output", failure_path=f"s3://{bucket}/{prefix}/failure", )
endpoint = model_builder.deploy(inference_config=async_config) endpoint_name = endpoint.endpoint_name print(f"Deployed asynchronous endpoint: {endpoint_name}")
设置 accept_eula=True 表示你已阅读并接受模型的许可条款,这是部署该模型的必要条件。如果你在 SageMaker Studio 之外运行这段代码,还要通过 role_arn="
endpoint 把请求和结果存放在 Amazon S3 中,其中包含你的序列和预测结构。对于专有序列,建议改用专用的 S3 桶或前缀,并使用你自己管理的 AWS Key Management Service (AWS KMS) 密钥做服务器端加密。要用你的密钥加密结果,把它的 ARN 作为 kms_key_id 传给 AsyncInferenceConfig。用桶策略限制访问,只放行运行这套工作流的角色;再添加一条 S3 Lifecycle 规则,让不需要保留的请求和结果对象到期失效。更多信息请参阅 Amazon S3 安全最佳实践。
部署通常在几分钟内完成,其中包括一个预热步骤:容器在每个 GPU 上跑一次简短的预测,以便 endpoint 进入 InService 状态时 GPU 已完成预热。
提示:G6 容量在部分 Region 可能有限。如果部署因 InsufficientInstanceCapacity 失败,可以稍后重试、换一种受支持的实例规格,或改到该模型可用的另一个 AWS Region 部署。
运行一次结构预测
请求是一个 JSON 文档,含一个或多个带名称的 queries,每个 query 列出自己的 chains。同一个 query 里的所有链会作为一个复合物一起折叠;不同 query 则各自独立折叠。
每条链包含以下字段:
molecule_type – protein、dna、rna 或 ligand。 chain_ids – 链标识符列表,例如 ["A"]。要表示相同的拷贝(比如同源二聚体),用 ["A", "B"]。 sequence – 残基序列,用于蛋白质、DNA 和 RNA 链。 smiles – SMILES 字符串,配体链用它代替 sequence。
下面的例子折叠人泛素,这是一种研究得很透彻的 76 残基蛋白质:
s3 = boto3.client("s3") smr = boto3.client("sagemaker-runtime")
payload = { "queries": { "ubiquitin": { "chains": [ { "molecule_type": "protein", "chain_ids": ["A"], "sequence": "MQIFVKTLTGKTITLEVEPSDTIENVKAKIQDKEGIPPDQQRLIFAGKQLEDGRTLSDYNIQKESTLHLVLRLRGG", } ] } } }
1. Stage the request in S3
input_key = f"{prefix}/input/{uuid.uuid4().hex}.json" s3.put_object(Bucket=bucket, Key=input_key, Body=json.dumps(payload).encode())
2. Submit asynchronously -- returns immediately
resp = smr.invoke_endpoint_async( EndpointName=endpoint_name, ContentType="application/json", InputLocation=f"s3://{bucket}/{input_key}", InvocationTimeoutSeconds=3600, ) output_location, failure_location = resp["OutputLocation"], resp["FailureLocation"]
然后轮询 S3,等待结果或失败记录:
def split(uri): b, _, k = uri.removeprefix("s3://").partition("/") return b, k
result = None for _ in range(120): # up to ~30 minutes for loc, is_failure in ((output_location, False), (failure_location, True)): try: body = s3.get_object(Bucket=split(loc)[0], Key=split(loc)[1])["Body"].read() except s3.exceptions.NoSuchKey: continue if is_failure: raise RuntimeError(body.decode()) result = json.loads(body) if result: break time.sleep(15)
if result is None: raise TimeoutError(f"No result yet; check {output_location}") if result.get("status") == "error": raise RuntimeError(result["error"])
输入无效的请求(例如链格式有误,或使用了不受支持的 MSA 名称)仍会生成一个结果对象,只是里面是 "status": "error" 和一条 error 消息,而没有结构。最后那步检查就是把这条消息抛出来。
预测时间随输入规模增长。在我们在 ml.g6.4xlarge 上的测试中,较小的蛋白质比较大的完成得更快。
解读结果
响应里有一个 status、mmCIF 格式的预测 structures 列表,以及与之对应的 confidences。默认情况下,OpenFold3 为每个 query 生成五个扩散样本,因此每个 query 返回五个候选结构。每个样本附带两个置信度文件:详细的 (_confidences.json) 和汇总的 (_confidences_aggregated.json)。汇总文件里有一个 sample_ranking_score,可以用来挑选最佳样本。
import os os.makedirs("structures", exist_ok=True) for s in result["structures"]: path = os.path.join("structures", os.path.basename(s["filename"])) with open(path, "w") as f: f.write(s["content"]) print("saved", path, f'({s["size_bytes"]/1024:.0f} KB)')
summaries = {c["filename"]: c["data"] for c in result["confidences"] if c["filename"].endswith("_aggregated.json")} for name, m in sorted(summaries.items(), key=lambda kv: -kv[1]["sample_ranking_score"]): print(f'{name}: ranking={m["sample_ranking_score"]:.2f} pLDDT={m["avg_plddt"]:.1f} ' f'pTM={m["ptm"]:.2f} ipTM={m["iptm"]:.2f}')
你可以在任意结构查看器中打开 .cif 文件,例如 PyMOL、ChimeraX 或 Mol*。要在 notebook 里内联查看结构,可以用 py3Dmol:
import py3Dmol # pip install py3Dmol view = py3Dmol.view(width=600, height=450) view.addModel(result["structures"][0]["content"], "cif")
pLDDT is stored in the B-factor field: red = low confidence, blue = high
view.setStyle({"cartoon": {"colorscheme": {"prop": "b", "gradient": "roygb", "min": 50, "max": 90}}}) view.zoomTo(); view.show()
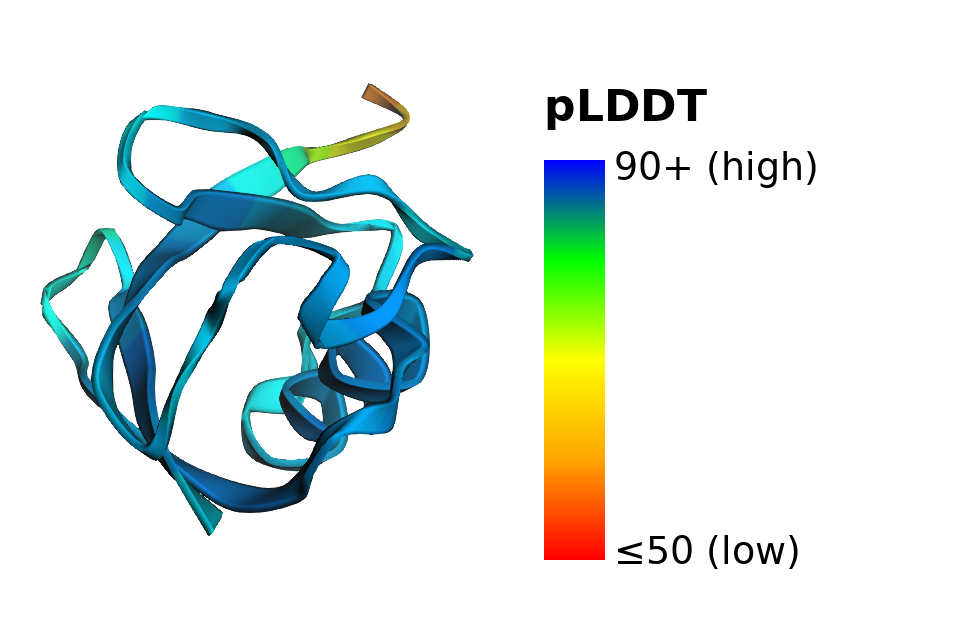
图 1:OpenFold3 预测的泛素结构,用前面的代码渲染,并按每个原子的置信度 (pLDDT) 着色。本文所有图均用 3Dmol.js 渲染(Rego 和 Koes,Bioinformatics, 2015)。
该预测呈现出泛素紧凑的折叠:一片混合 β 折叠贴着一段 α 螺旋。结构大部分是蓝色(高置信度),只有图像顶部柔性的 C 端尾巴偏向黄色和红色,这与实验结构中该尾巴已知的柔性相符。
置信度指标告诉你每个预测有多可信:
pLDDT(predicted local distance difference test) – 局部结构的逐原子置信度,取值 0–100,越高越好;大约 70 以上通常意味着局部结构可靠。汇总文件以 avg_plddt 给出平均值。 pTM 和 ipTM(predicted TM-score and interface pTM) – 对整体折叠、以及链与配体彼此相对位置的总体置信度,取值 0–1。对复合物而言,ipTM 是关键数值。汇总文件还给出每对链的 chain_pair_iptm。 PAE(predicted aligned error) 和 PDE(predicted distance error) – 详细置信度文件里的逐残基对误差估计,用来判断结构域与链的相对位置。
折叠一个复合物
要预测复合物,在同一个 query 里列出多条链。下面这个例子把人碳酸酐酶 II 与它的催化锌离子及药物 acetazolamide 一起折叠。这是一个研究得很充分的复合物,在 Protein Data Bank 中有实验结构(例如 PDB 3HS4):
ca2_sequence = ( "MSHHWGYGKHNGPEHWHKDFPIAKGERQSPVDIDTHTAKYDPSLKPLSVSYDQATSLRILNNGHAFNVEFDDSQDKAVLKGG" "PLDGTYRLIQFHFHWGSLDGQGSEHTVDKKKYAAELHLVHWNTKYGDFGKAVQQPDGLAVLGIFLKVGSAKPGLQKVVDVLDS" "IKTKGKSADFTNFDPRGLLPESLDYWTYPGSLTTPPLLECVTWIVLKEPISVSSEQVLKFRKLNFNGEGEPEELMVDNWRPAQ" "PLKNRQIKASFK" )
payload = { "queries": { "ca2_acetazolamide": { "chains": [ {"molecule_type": "protein", "chain_ids": ["A"], "sequence": ca2_sequence}, {"molecule_type": "ligand", "chain_ids": ["B"], "smiles": "[Zn+2]"}, {"molecule_type": "ligand", "chain_ids": ["C"], "smiles": "CC(=O)Nc1nnc(s1)S(=O)(=O)N"}, ] } } }
这些例子中的蛋白质序列来自 UniProt(P0CG48、P00918)。提交和读取该请求的方式与泛素示例相同。对这类复合物,预测质量很大程度上取决于是否提供 MSA,后面几节会展示这一点。
在多 GPU 实例上并行运行预测
单次 OpenFold3 预测只跑在一个 GPU 上,所以多 GPU 实例不会让单个预测变快;它的用处是让你一次跑多个预测。在 ml.g6.12xlarge 这类带四个 GPU 的多 GPU 实例上,容器会给每个并发请求分配各自的 GPU。要用满所有 GPU,把 max_concurrent_invocations_per_instance 设为实例上的 GPU 数量(ml.g6.12xlarge 是四个):
multi_gpu_builder = ModelBuilder.from_jumpstart_config( jumpstart_config=JumpStartConfig( model_id="huggingface-proteinfolding-openfold3", accept_eula=True, ), compute=Compute(instance_type="ml.g6.12xlarge"), ) multi_gpu_model = multi_gpu_builder.build()
async_config = AsyncInferenceConfig( output_path=f"s3://{bucket}/{prefix}/output", failure_path=f"s3://{bucket}/{prefix}/failure", max_concurrent_invocations_per_instance=4, # = number of GPUs on the instance )
multi_gpu_endpoint = multi_gpu_builder.deploy(inference_config=async_config)
这会创建第二个 endpoint,用完后记得也把它删掉(见清理)。
在我们的测试中,四个并发预测各自跑在单独的 GPU 上,吞吐量增益随蛋白质变大而提高。对较大的蛋白质,按 On-Demand 实例定价计算,我们在 ml.g6.12xlarge 上测得的单次预测成本与 ml.g6.4xlarge 接近。实际结果取决于你的输入和 Region。定价请参阅 Amazon SageMaker AI pricing。
注:ml.g6.12xlarge 容量可能有限。如果你所在的 Region 没有该规格,可以用本文后面介绍的 autoscaling 配置横向扩展到多台 ml.g6.4xlarge 实例来提升吞吐量。
用下表来挑选实例:
工作负载推荐实例理由 单用户交互式探索ml.g6.2xlarge 或 ml.g6.4xlarge一个 GPU 一次处理一个预测,每小时成本在所有受支持实例中最低 团队使用或并发请求突发ml.g6.12xlarge 配 max_concurrent_invocations_per_instance=4四个预测并行运行,无需排队 高通量筛选ml.g6.12xlarge 配 autoscaling在所有受支持实例中单实例吞吐量最高;随队列深度横向扩展,并可回缩到零
用你自己的 MSA 提升预测准确度
OpenFold3 可以接受多序列比对(MSA)作为每条蛋白质链的附加输入。MSA 是一组与你的查询对齐、在进化上相关的序列。这些序列之间的共变信号能提示哪些残基可能彼此接触,因此 MSA 能显著提升许多蛋白质和复合物的预测准确度。
为了帮助把序列留在你的 AWS 账户内,JumpStart endpoint 在网络隔离下运行,不会调用外部 MSA 服务器;它改为接受请求里预先计算好的 MSA。你用现成的流程和序列数据库、在自己掌控的基础设施上生成比对,再传给 endpoint。这种设计对需要保密专有序列的药物发现项目很有帮助。
如果不提供 MSA,endpoint 就只凭序列预测。这对泛素这类小而研究透彻的蛋白质效果不错;但对大多数现实中的靶点和复合物,还是要带上 MSA。本节余下部分会说明具体做法,以及它能把结果改善多少。
自带 MSA
每条蛋白质链都接受一个 precomputed_msa 字段:一个比对列表,每项含 name 以及 A3M 或 Stockholm 格式的比对 content。对于合并后的单个比对(例如 ColabFold MMseqs2 搜索的输出),把名称设为 colabfold_main:
with open("ca2_colabfold.a3m") as f: ca2_msa = f.read()
payload["queries"]["ca2_acetazolamide"]["chains"][0]["precomputed_msa"] = [ {"name": "colabfold_main", "content": ca2_msa} ]
这个例子只有一条蛋白质链。如果一个 query 有多条不同的蛋白质链,就分别为每条计算 MSA,挂到该链的 precomputed_msa 字段上。列在同一个 chain_ids 条目下的相同拷贝(例如同源二聚体)共用一个 MSA。
如果你用别的流程生成 MSA,endpoint 也接受其他比对名称,例如 uniref90_hits、mgnify_hits 和 bfd_uniclust_hits。由于请求先暂存在 S3,你可以发送很大的比对;在我们的测试中,几 MB 的比对也能正常工作。
你可以用 ColabFold(MMseqs2)、HHblits 或 JackHMMER 等工具生成 MSA。为了把专有序列留在自己的环境里,请在你自己的 AWS 基础设施上针对本地托管的序列数据库运行搜索,而不要把序列发到公共服务器。例如,ColabFold 的 colabfold_batch 命令默认使用公共 ColabFold MSA 服务器,因此处理专有序列时应改用 colabfold_search 搭配本地托管的数据库。
MSA 能带来多大差别?
我们把上一节的碳酸酐酶 II、锌与 acetazolamide 复合物在同一个 endpoint 上折叠了两次:一次用单序列模式,一次带上来自 ColabFold MMseqs2 搜索的 MSA。
指标(5 个样本中的第一个)无 MSA有 MSA 平均 pLDDT3098 pTM0.220.98 ipTM0.490.98 锌–His94/His96/His119 距离2.3–9.4 Å各 2.0 Å Acetazolamide 氮–锌距离5.6 Å2.0 Å 预测时间~1.5 分钟~1.5 分钟
带上 MSA 后,OpenFold3 还原出已知的结合模式:锌离子由三个活性位点组氨酸配位,acetazolamide 的磺酰胺氮直接与锌结合,与实验结构一致。没有 MSA 时,蛋白质折叠的置信度很低,结合位点也没有形成。加入 MSA 并没有明显改变预测时间。
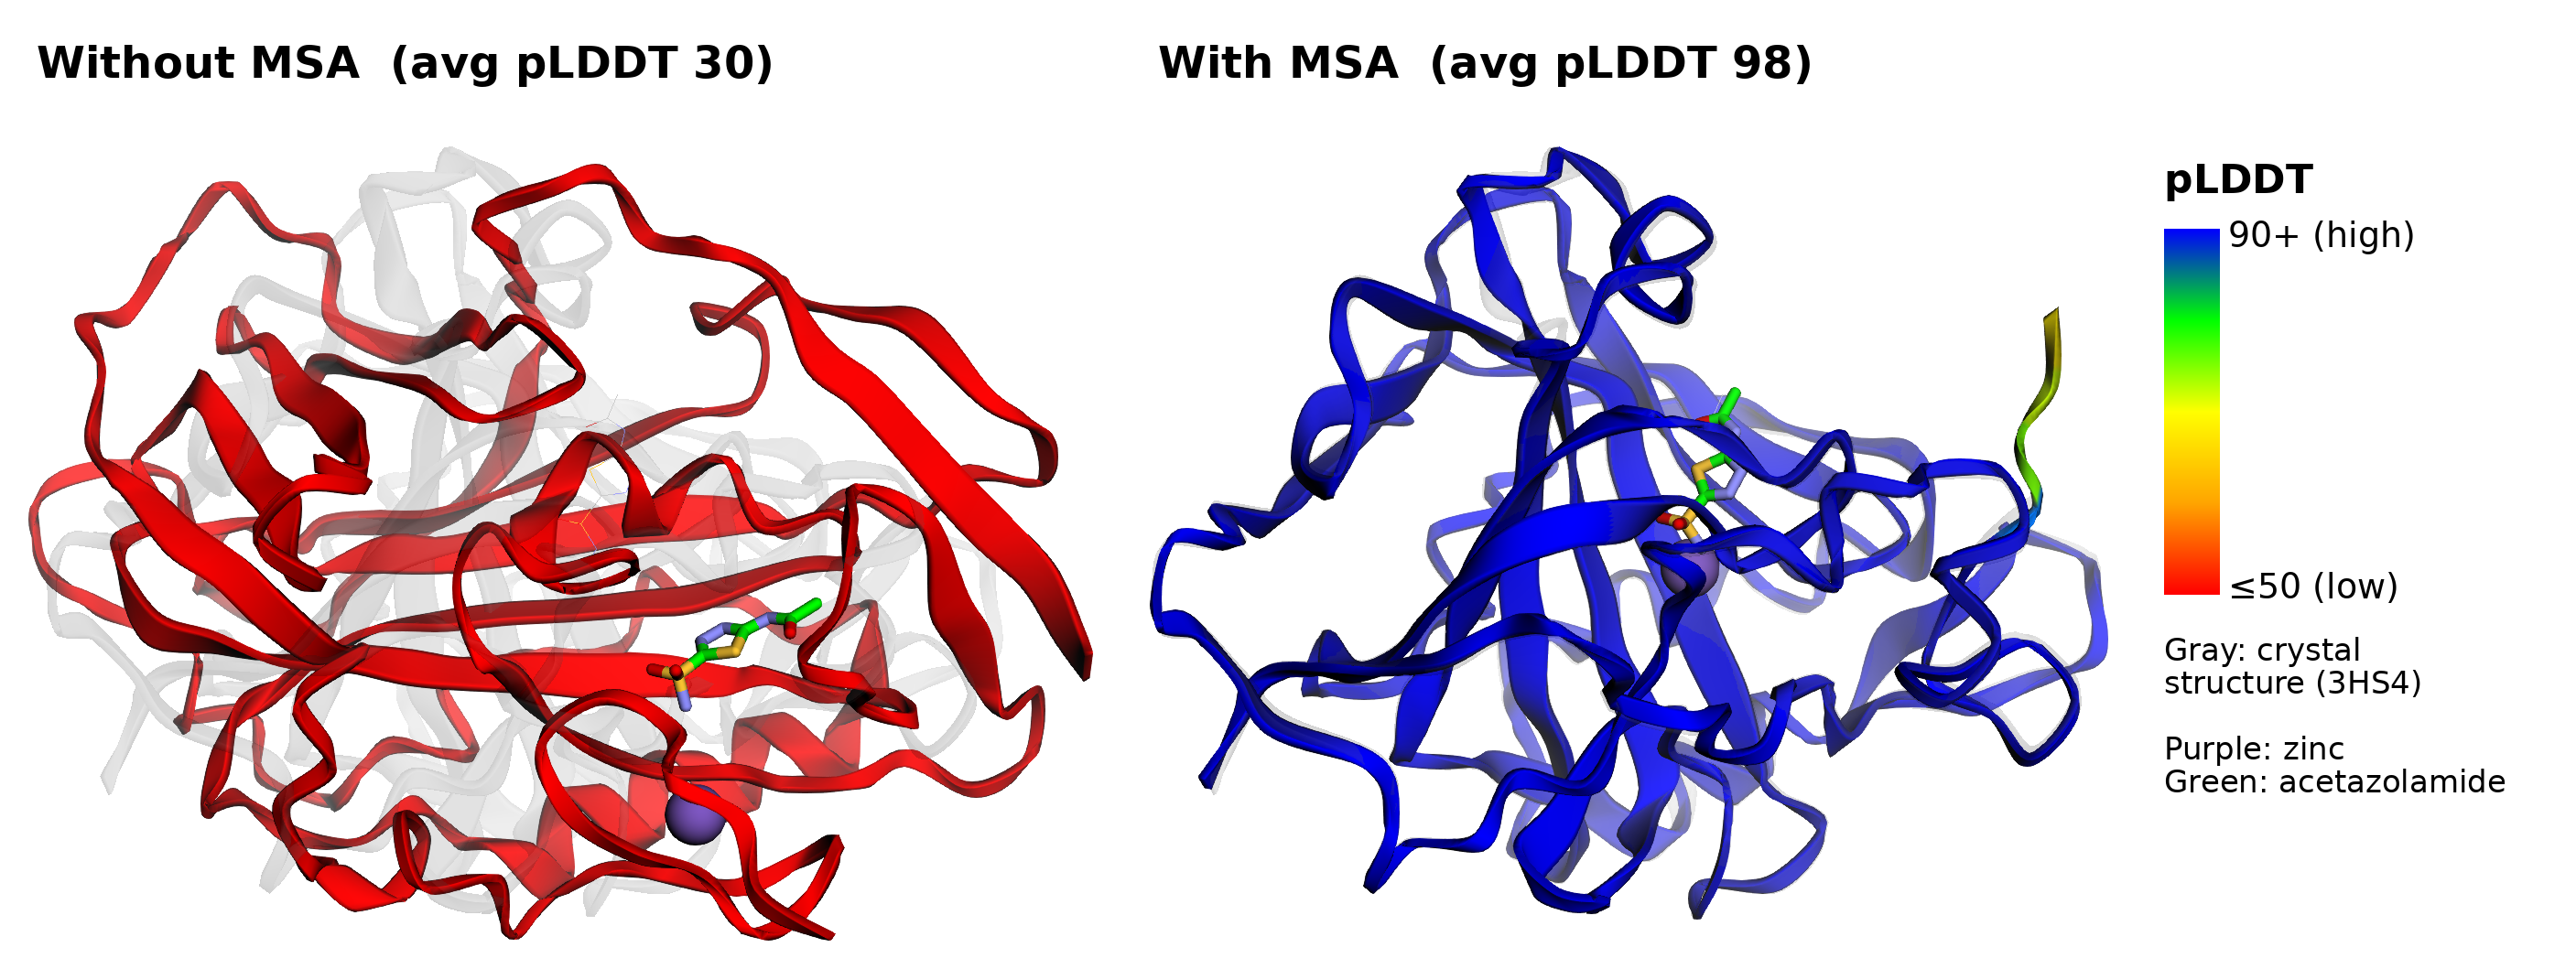
图 2:同一个碳酸酐酶 II、锌与 acetazolamide 查询,分别在无 MSA(左)和有 MSA(右)两种情况下折叠。两个预测都按 pLDDT 着色,并叠加在实验晶体结构上(灰色,PDB 3HS4;Sippel 等,2009)。
叠加到晶体结构上看,基于 MSA 的预测与之高度吻合:蛋白质主链偏差 0.2 Å (Cα RMSD),锌离子偏差小于 0.1 Å,acetazolamide 重原子偏差 0.4 Å RMSD。单序列预测则发生了错误折叠,Cα RMSD 为 22 Å。
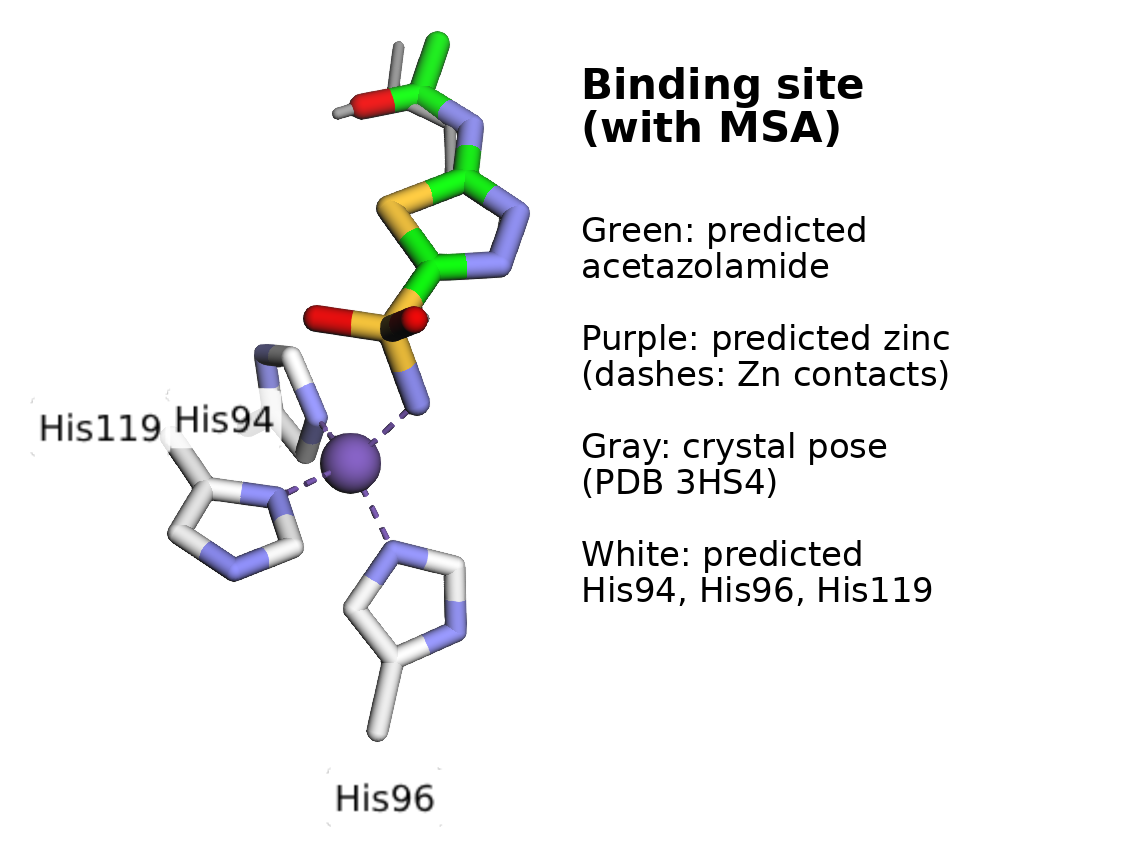
图 3:基于 MSA 的预测中结合位点的特写。预测出的锌离子(紫色)由 His94、His96、His119 以及 acetazolamide 的磺酰胺氮(绿色)配位。晶体姿态(灰色)几乎完全被预测结果遮住。
碳酸酐酶 II 与 acetazolamide 是 Protein Data Bank 中研究得最充分的复合物之一,与之高度相似的结构很可能就在 OpenFold3 的训练数据里。请把这个例子看作对工作流程、以及 MSA 有多重要的演示,而不是衡量新靶点预测准确度的基准。
把 OpenFold3 的结果与其他工具或已发表基准比较时,要做到同类相比:单序列结果对单序列结果,基于 MSA 的结果对基于 MSA 的结果。
帮助降低成本:空闲时缩容到零
没有请求排队时,异步 endpoint 可以缩到零实例,新请求到达时再扩回来。这种模式很适合结构预测工作,因为它往往是突发的。
aas = boto3.client("application-autoscaling") resource_id = f"endpoint/{endpoint_name}/variant/AllTraffic"
aas.register_scalable_target( ServiceNamespace="sagemaker", ResourceId=resource_id, ScalableDimension="sagemaker:variant:DesiredInstanceCount", MinCapacity=0, MaxCapacity=4, )
Scale out and in to keep about 4 queued requests per instance
aas.put_scaling_policy( PolicyName="openfold3-backlog", ServiceNamespace="sagemaker", ResourceId=resource_id, ScalableDimension="sagemaker:variant:DesiredInstanceCount", PolicyType="TargetTrackingScaling", TargetTrackingScalingPolicyConfiguration={ "TargetValue": 4.0, "CustomizedMetricSpecification": { "MetricName": "ApproximateBacklogSizePerInstance", "Namespace": "AWS/SageMaker", "Dimensions": [{"Name": "EndpointName", "Value": endpoint_name}], "Statistic": "Average", }, "ScaleInCooldown": 600, "ScaleOutCooldown": 300, }, )
队列空置一段时间后,目标跟踪会把 endpoint 缩到零;在我们的测试中大约需要 15–20 分钟。不过,目标跟踪不会把 endpoint 从零再扩回来。要在请求到达而没有实例运行时拉起实例,需要再加一条由 HasBacklogWithoutCapacity 指标触发的步进扩缩策略:
cw = boto3.client("cloudwatch")
step = aas.put_scaling_policy( PolicyName="openfold3-scale-from-zero", ServiceNamespace="sagemaker", ResourceId=resource_id, ScalableDimension="sagemaker:variant:DesiredInstanceCount", PolicyType="StepScaling", StepScalingPolicyConfiguration={ "AdjustmentType": "ChangeInCapacity", "MetricAggregationType": "Average", "Cooldown": 300, "StepAdjustments": [{"MetricIntervalLowerBound": 0, "ScalingAdjustment": 1}], }, )
cw.put_metric_alarm( AlarmName=f"{endpoint_name}-has-backlog-without-capacity", Namespace="AWS/SageMaker", MetricName="HasBacklogWithoutCapacity", Dimensions=[{"Name": "EndpointName", "Value": endpoint_name}], Statistic="Average", Period=60, EvaluationPeriods=2, DatapointsToAlarm=2, Threshold=1, ComparisonOperator="GreaterThanOrEqualToThreshold", TreatMissingData="missing", AlarmActions=[step["PolicyARN"]], )
当请求到达一个零实例的 endpoint 时,它会在队列里等待实例启动。从零扩容后的第一个请求耗时更长,因为其中还包括告警触发、实例启动,再加上预测本身的时间。同一波突发里的后续请求则以正常速度运行。这种取舍对批处理工作负载很合适。若用于交互式场景,可设 MinCapacity=1 保留一个热实例。更多细节请参阅自动扩缩异步 endpoint。
清理
要停止产生费用,用完后删掉你创建的资源。如果配置了 autoscaling,先把它移除:删除 Amazon CloudWatch 告警,再注销可扩展目标。然后删除每个 endpoint、它的 endpoint 配置和模型;如果部署过多 GPU endpoint,也要一并删除:
1. If you configured autoscaling, remove it before deleting the endpoint
cw.delete_alarms(AlarmNames=[f"{endpoint_name}-has-backlog-without-capacity"]) aas.deregister_scalable_target( ServiceNamespace="sagemaker", ResourceId=resource_id, ScalableDimension="sagemaker:variant:DesiredInstanceCount", )
2. Delete the endpoints, endpoint configurations, and models
(include only the ones you deployed)
from sagemaker.core.resources import EndpointConfig
for m, ep in ((model, endpoint), (multi_gpu_model, multi_gpu_endpoint)): endpoint_config = EndpointConfig.get(endpoint_config_name=ep.endpoint_name) m.delete() ep.delete() endpoint_config.delete()
如果不再需要请求和结果对象,也可以把它们从 s3://
结论
借助 SageMaker JumpStart 上的 OpenFold3,研究与药物发现团队只需几行代码,就能把一个开放、可审查的结构预测模型部署到自己的 AWS 账户里。异步推理负责处理耗时很长的折叠和突发式批处理,多 GPU 实例让多个预测并行跑。网络隔离帮助你把专有序列保密;又因为可以自带 MSA,你无需把序列发到外部服务器就能享受 MSA 带来的好处。配合缩容到零,当队列空置足够久、endpoint 完成缩容后,你就不再为 endpoint 实例付费。其他费用(例如 Amazon S3 存储)仍然照常产生。
本文中的代码是供试验用的示例代码。在把它用于专有或受监管数据之前,请与你的安全和法务团队协作,确保满足所在组织的安全、监管与合规要求。
要上手,请在 SageMaker JumpStart 中搜索 OpenFold3,或从模型卡片打开示例 notebook。想进一步了解本文用到的功能,请参阅异步推理和自动扩缩异步 endpoint。若要讨论结构生物学工作负载,请联系你的 AWS 客户团队。
关于作者