在线AI教程 / AI工具
[Amazon Bedrock] Build autonomous AI agents with Amazon Bedrock and Spring AI
人工智能 用 Amazon Bedrock 和 Spring AI 构建自主 AI agents Java 团队已有成熟的 JVM 工具链、continuous integrati
人工智能
用 Amazon Bedrock 和 Spring AI 构建自主 AI agents
Java 团队已有成熟的 JVM 工具链、continuous integration and continuous delivery(CI/CD)流水线和运维套路,可要把 AI agents 从原型推到生产仍不容易:agent 框架默认并不解决可扩展性、治理、安全和运维上的问题。Amazon Bedrock 与 Spring AI 补上这些缺口,让 Java 团队能构建会做规划、调用工具与 API、并在多轮对话里保持上下文的自主 AI agents。Agentic AI 正从 prompt-response 式交互,走向执行复杂多步任务的自主系统。
Java 仍是企业软件里使用最广的编程语言之一。团队已有 CI/CD 流水线、运维专长,以及围绕 JVM 建立起来的成熟模式。Spring AI 通过熟悉的 Spring 模式把 AI 能力带进 JVM:auto-configuration、dependency injection 和 composable advisors。开发者可以用写 REST API、安全和数据访问时同一套惯例来构建 AI agents。
Amazon Bedrock AgentCore 是一个用任意框架或模型、规模化构建、连接和优化 agents 的平台。有了 AgentCore,你就能规模化地构建、部署和运营 AI agents。它不依赖框架、也不依赖模型:你带上自己偏好的 agent 框架和 foundation model(FM)即可。借 AgentCore,你能用上生产所需的基础设施:托管 runtime、memory、browser automation、code execution 和 identity management。
本文里,我们展示如何借 spring-ai-agentcore、用 Java 结合 Spring AI 与 Amazon Bedrock 构建自主 AI agents。我们探究两套系统的关键实现模式。第一套是单 agent 旅行助手,演示工具调用与 memory;第二套是多 agent intelligent document processing(IDP)系统,展示 specialist agents、rules engine 与告警如何协同。
前置条件
跟着这篇实操走,你需要:
Java – JDK 21(必需) Spring Boot – 4.1(配 Spring AI 2.0 与 spring-ai-agentcore 2.0) Maven – 3.9+。 Node.js – 18+(用于 React frontend) Terraform – 1.5+。 Docker – 带 Buildx,用于多架构构建。 AWS Command Line Interface(AWS CLI) – v2,已配好凭证。 一个 AWS 账户。
什么才算一个 agent
一次 chat completion 调用能生成文本,但它没法决定下一步做什么、伸不到外部系统里、也记不住昨天发生过什么。agent 可以,因为它把三种能力合到了一起:
规划(Planning) – 给定一个目标,模型把它拆成步骤、排出优先级,并在新信息到来时修正计划。 工具使用(Tool use) – 除了生成文本,模型还能选择并调用外部函数,例如 API、数据库和 code interpreters,从而在真实世界采取行动。 记忆(Memory) – 上下文跨轮次(短期)、跨 session(长期)延续,因此每个决策都建立在此前发生过的事之上。
一个 Retrieval Augmented Generation(RAG)应用的工具使用有限(只有检索),但没有规划循环。agent 三者兼备,在一个目标导向的循环里运转,直到任务完成、或它判定无法继续。
下图展示一条端到端 agentic pipeline 里的这些能力,从请求到有依据的回答。
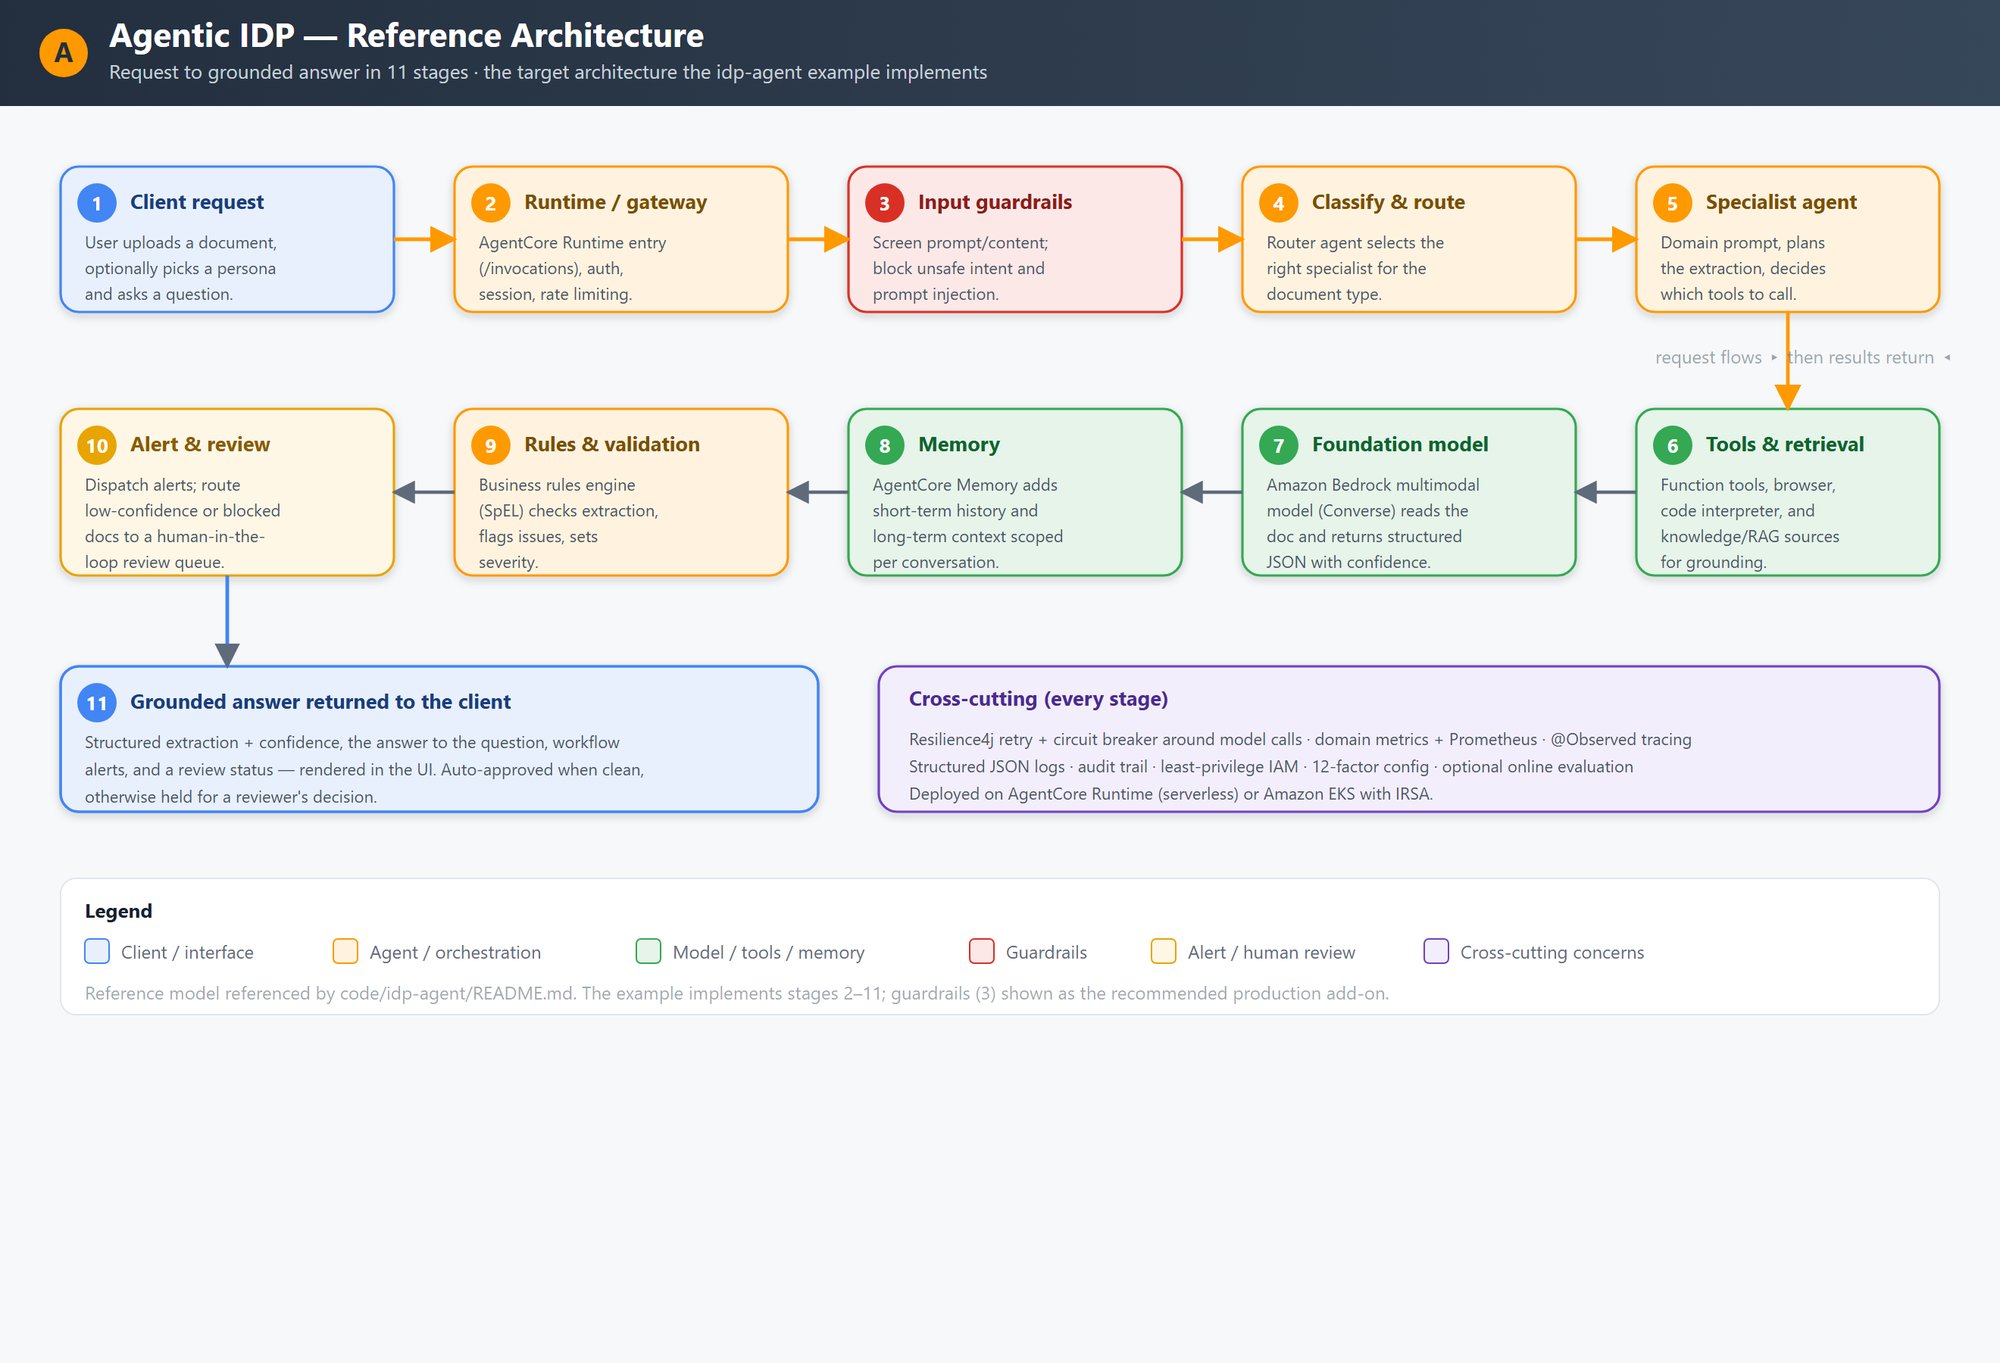
图 1:Agentic 参考架构。一次请求依次经过 runtime、guardrails、分类、specialist agent、工具、foundation model、memory、rules 和人工评审,最终得到一个有依据的回答,韧性与可观测性作为横切关注点贯穿其中
这条 pipeline 有 11 个阶段。客户端提交一份文档和一个问题。请求先经过 runtime gateway 做认证与限流,再由 input guardrails 筛查有害内容。一个 router 给文档分类,并把它路由给某个 specialist agent;后者规划自己的工作流,按需调用工具、Amazon Bedrock foundation model、memory 和 rules engine。低置信度或被标记的结果先进入人工评审队列,之后有依据的回答才返回客户端。韧性、可观测性、日志,以及最小权限的 AWS Identity and Access Management(IAM)贯穿所有阶段。
方案概览
方案由两套可部署系统组成,二者共用同一批模式:
Travel agent – 一个单 agent 自主系统,带工具调用(天气查询、行程搜索)、流式回答、对话 memory 和韧性模式。这是推荐的起点。 IDP 多 agent 系统 – 一个多 agent intelligent document processing 平台,含五个 specialist agents(Lawyer、Mortgage、Insurance、Tax、General)、rules and workflow engine、告警与可观测性。它展示的是规模化下的生产模式。
两套系统共用下面这套架构:
Spring Boot 应用,配 Spring AI ChatClient、Spring AI agentcore 和 Amazon Bedrock Converse API。 AgentCore runtime(Amazon Bedrock AgentCore 的一项能力)定义托管部署的契约(POST /invocations、GET /ping)。 通过 AgentCore memory(Amazon Bedrock AgentCore 的一项能力)承载对话记忆,兼顾短期与长期上下文。 用 注解方法做工具调用。 结构化输出映射到 Java records。 为 AWS Graviton 优化的 ARM64 容器镜像。 用分模块的 Terraform 做基础设施供给。
旅行助手是推荐的起点。下图展示一个 Spring Boot agent 如何与 AgentCore runtime、工具、memory,以及 Amazon Bedrock 上可用的模型交互。
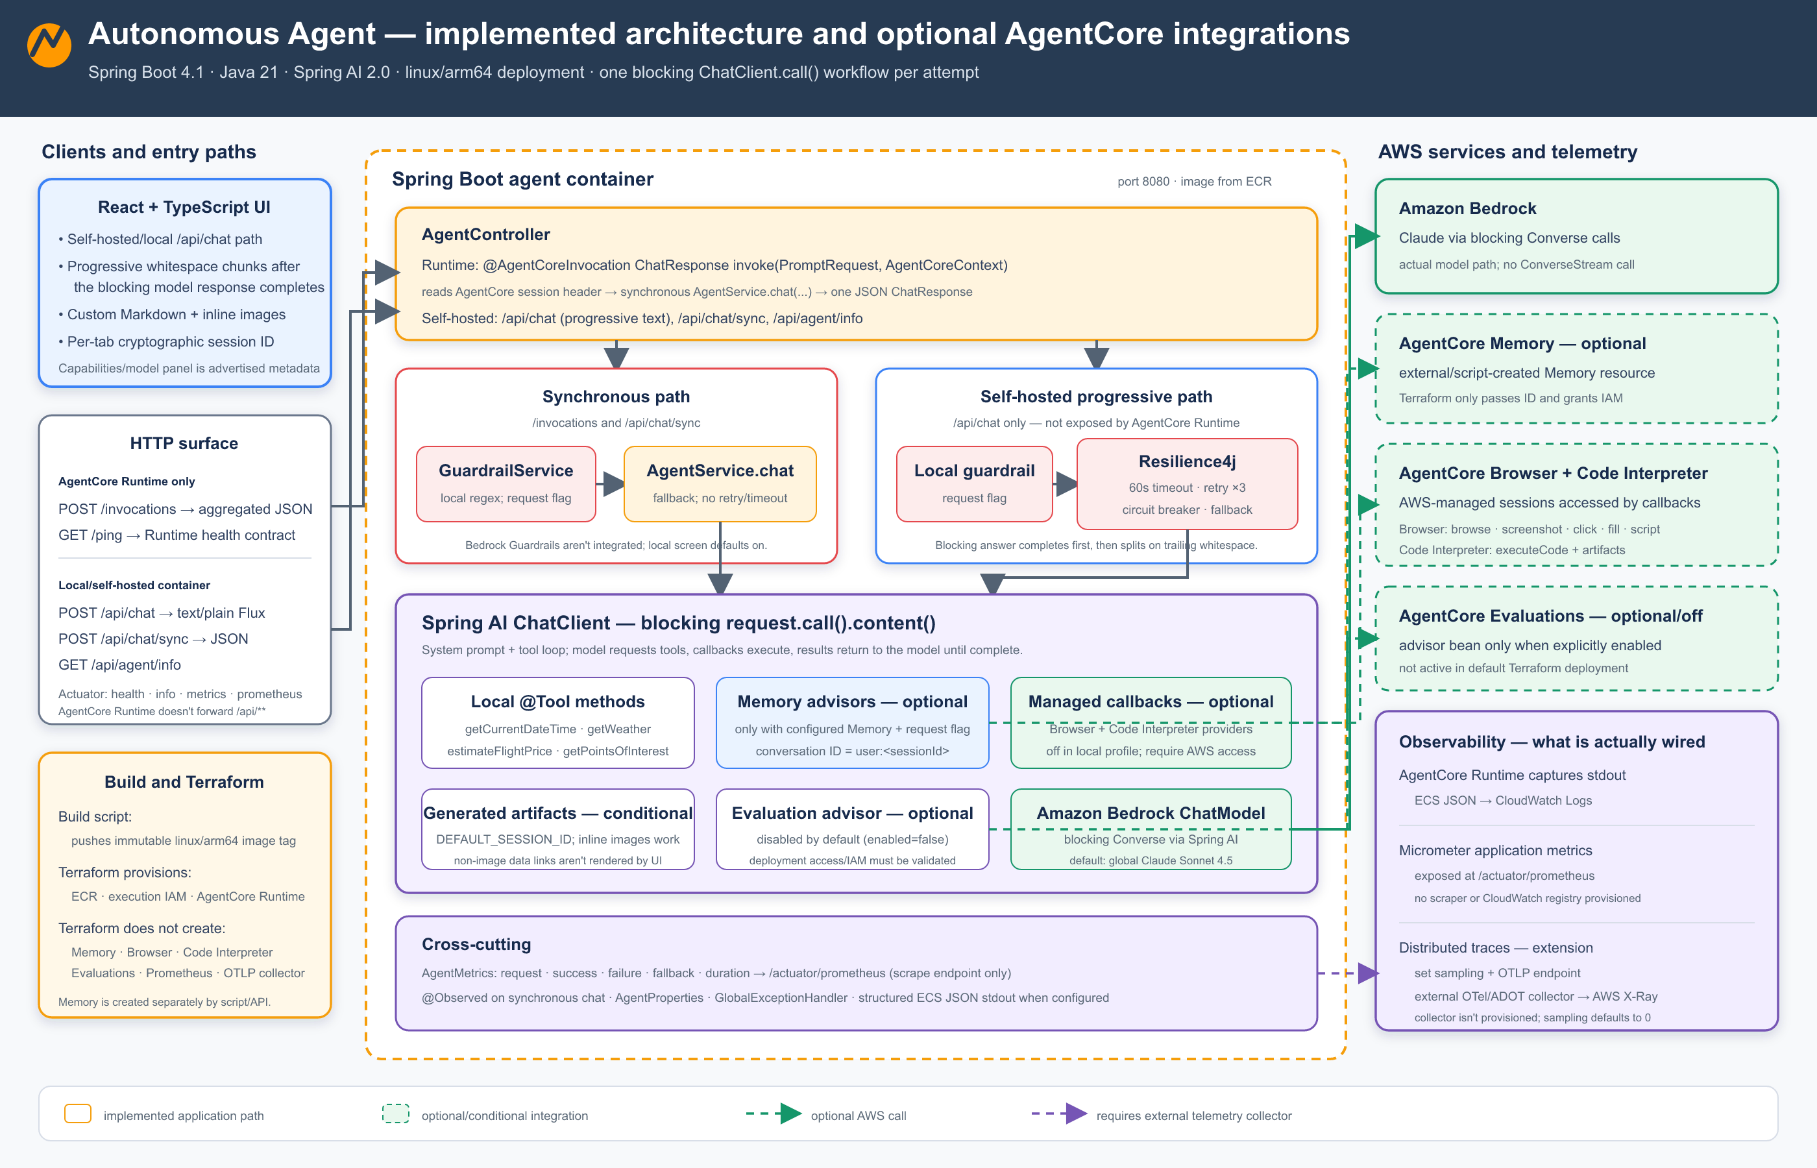
图 2:单 agent 旅行助手。Spring Boot 应用同时暴露供 React UI 用的 REST endpoints 与 AgentCore runtime 契约;它经 Converse API 调用 Amazon Bedrock,而工具调用、流式传输与 memory 都在同一份代码库里跑。
旅行助手跑的是一个 Spring Boot 应用,带两个入口:AgentCore runtime 要求的 /invocations 与 /ping 契约。Spring AI 经 Converse API 编排对 Amazon Bedrock 的调用,并在同一进程内本地解析工具调用。Server-Sent Events 在 token 生成时就把它流式推给客户端。AgentCore memory 同时提供一个 session 内的短期上下文和跨 sessions 的长期上下文,因此 agent 无需外部状态管理就能留住对话历史。
下图展示 IDP 多 agent 系统的架构。
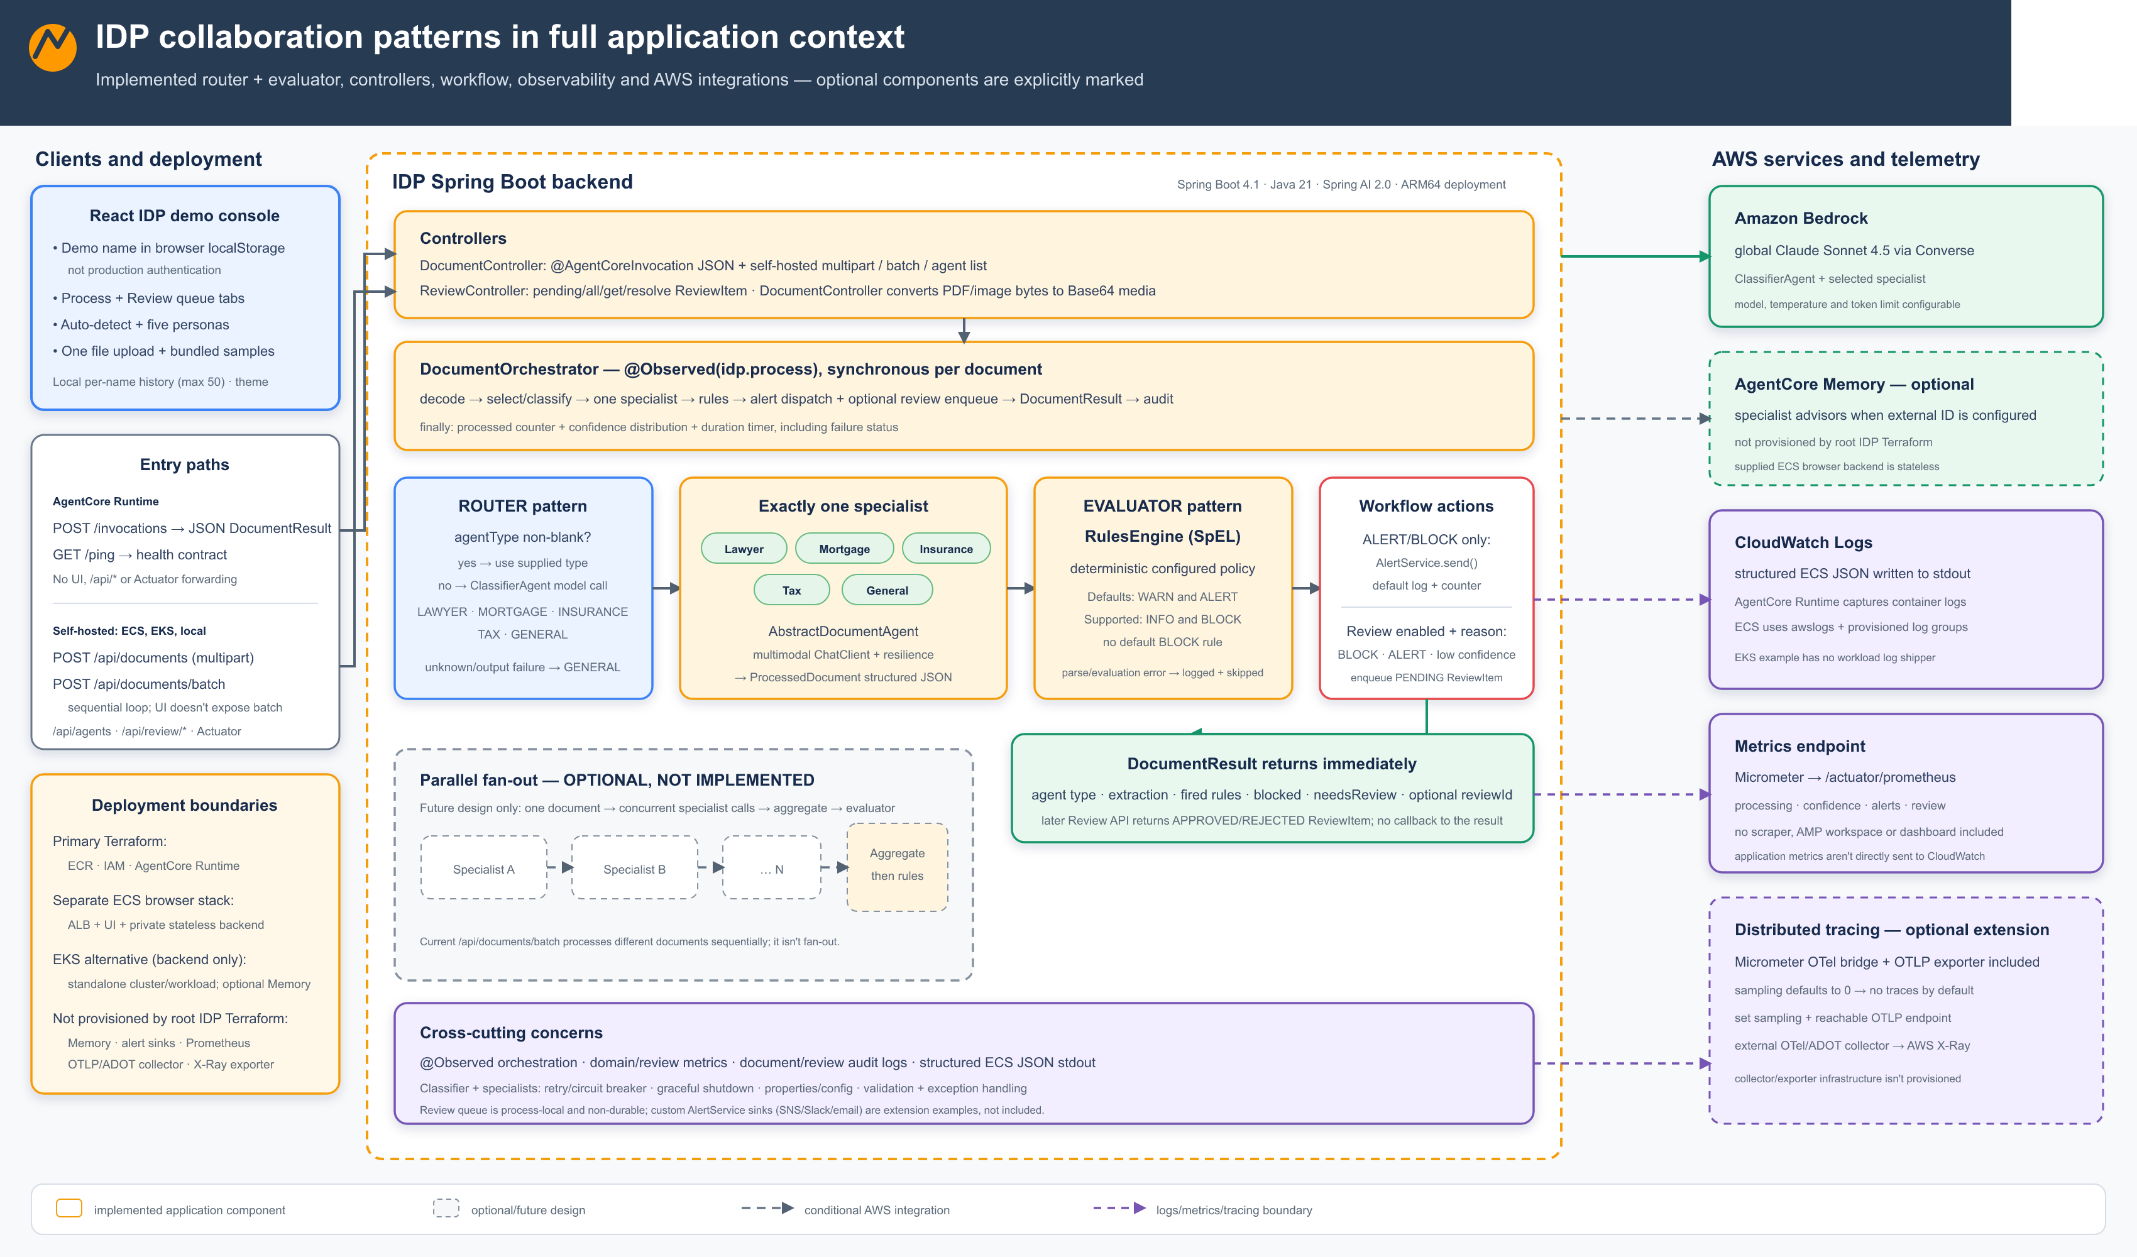
图 3:IDP 多 agent 系统架构。specialist agents 通过共用的 ChatClient 模式处理文档,结果流经 rules engine 与 alert service。
IDP 多 agent 系统把文档路由给五个 specialist agents(Lawyer、Mortgage、Insurance、Tax 和 General),每个都建在一个共用的 AbstractDocumentAgent 模板之上。一个 ClassifierAgent 读每份文档,并把它转给合适的 specialist。specialist 用 Amazon Bedrock 的多模态 Converse API 抽取带置信度分数的结构化 JSON。rules engine 拿 application.yml 里的 Spring Expression Language(SpEL)表达式对抽取结果求值。ALERT 或 BLOCK 级别的规则经 AlertService 派发。低置信度文档进入人工评审。指标、审计轨迹、韧性与可观测性贯穿所有阶段。
Agent 协作模式
多个 agents 一起工作时,它们怎么协调决定了系统行为。本方案用三种模式:
下图并排比较本方案用的三种协调模式。
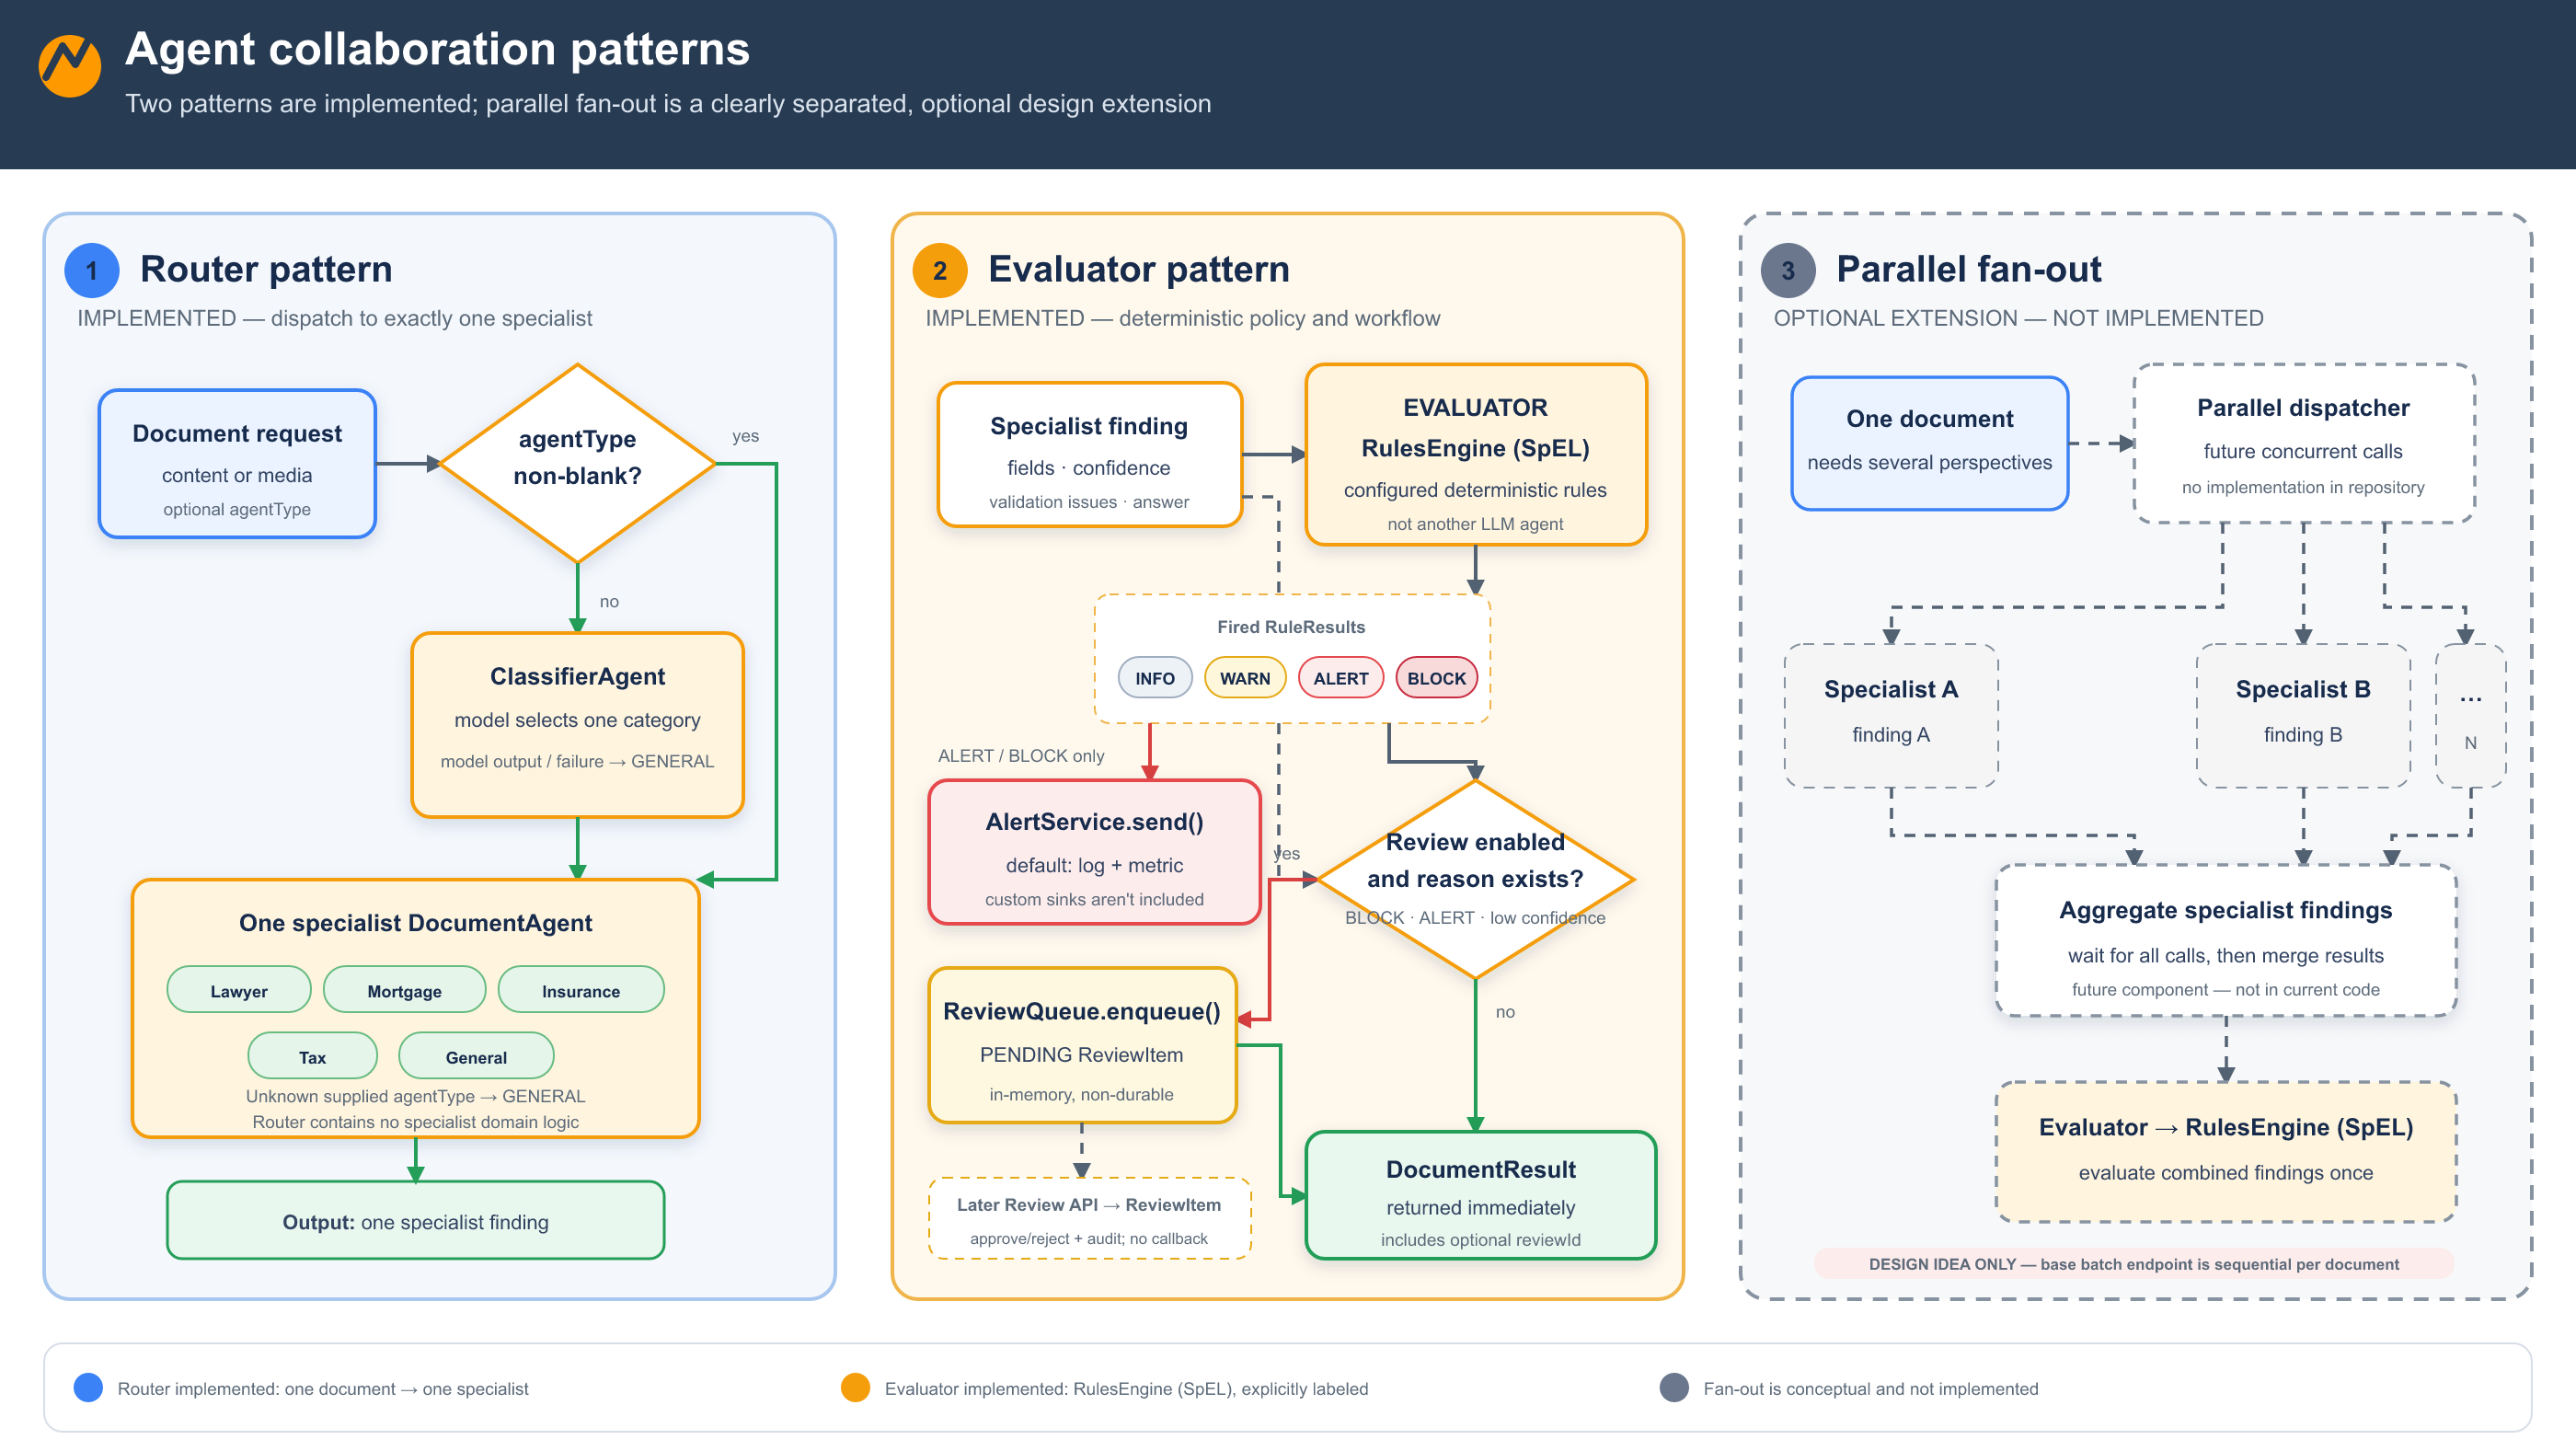
图 4:Agent 协作模式
三种模式并排展示。router 按文档类型把每条请求派给一个 specialist。evaluator 把 specialist 的发现结果送过一个 rules engine,后者套用严重级别,并派发告警或阻断以转人工评审。parallel fan-out 把一条请求并发发给多个 specialists,在 rules engine 跑之前把结果聚合起来。
Router pattern: 一个轻量 orchestrator 检查进来的请求,把它路由给合适的 specialist。在 IDP 多 agent 系统里,router 查看文档类型元数据,转发给 Lawyer、Mortgage、Insurance、Tax 或 General agent。router 不持任何领域逻辑,它只是一层派发。
Parallel fan-out(可选扩展): 基础方案实现了 router 和 evaluator 两种模式。batch endpoint 顺序处理文档。当一份文档同时需要好几个视角时,你可以把 parallel fan-out 作为即插即用的扩展加上:并发派发给 specialists,在 rules engine 跑之前聚合它们的结果。这样整段分析的墙钟时间由最慢的那一次 agent 调用决定,而不是所有调用之和。
Evaluator pattern:specialists 返回发现结果后,一个 rules engine 拿可配置的业务规则对合并后的输出求值。触发 ALERT 或 BLOCK 严重级别的规则,经可插拔的 AlertService 派发去人工评审。
实操
下面几节带过一遍关键实现模式,从 AgentCore runtime 契约起步,依次到工具调用、memory、韧性和多 agent 编排。
满足 AgentCore runtime 契约
Amazon Bedrock AgentCore runtime 管理 agent 生命周期与扩缩容。当前费率见 Amazon Bedrock AgentCore pricing 与 Amazon Bedrock pricing。runtime 把进来的请求路由给你的 agent,并监控它的健康。你的 agent 必须暴露两个 endpoint:
POST /invocations – 接收请求,以 JSON 或 Server-Sent Events(SSE)流式返回响应。 GET /ping – 报告健康状态(Healthy 或 HealthyBusy)。长时任务必须报 busy 状态,否则 runtime 可能把这个 agent 缩容掉。
下图展示 Spring AI 的开发者模型如何映射到 AgentCore runtime、Memory、Browser、Code Interpreter 和 Evaluations。
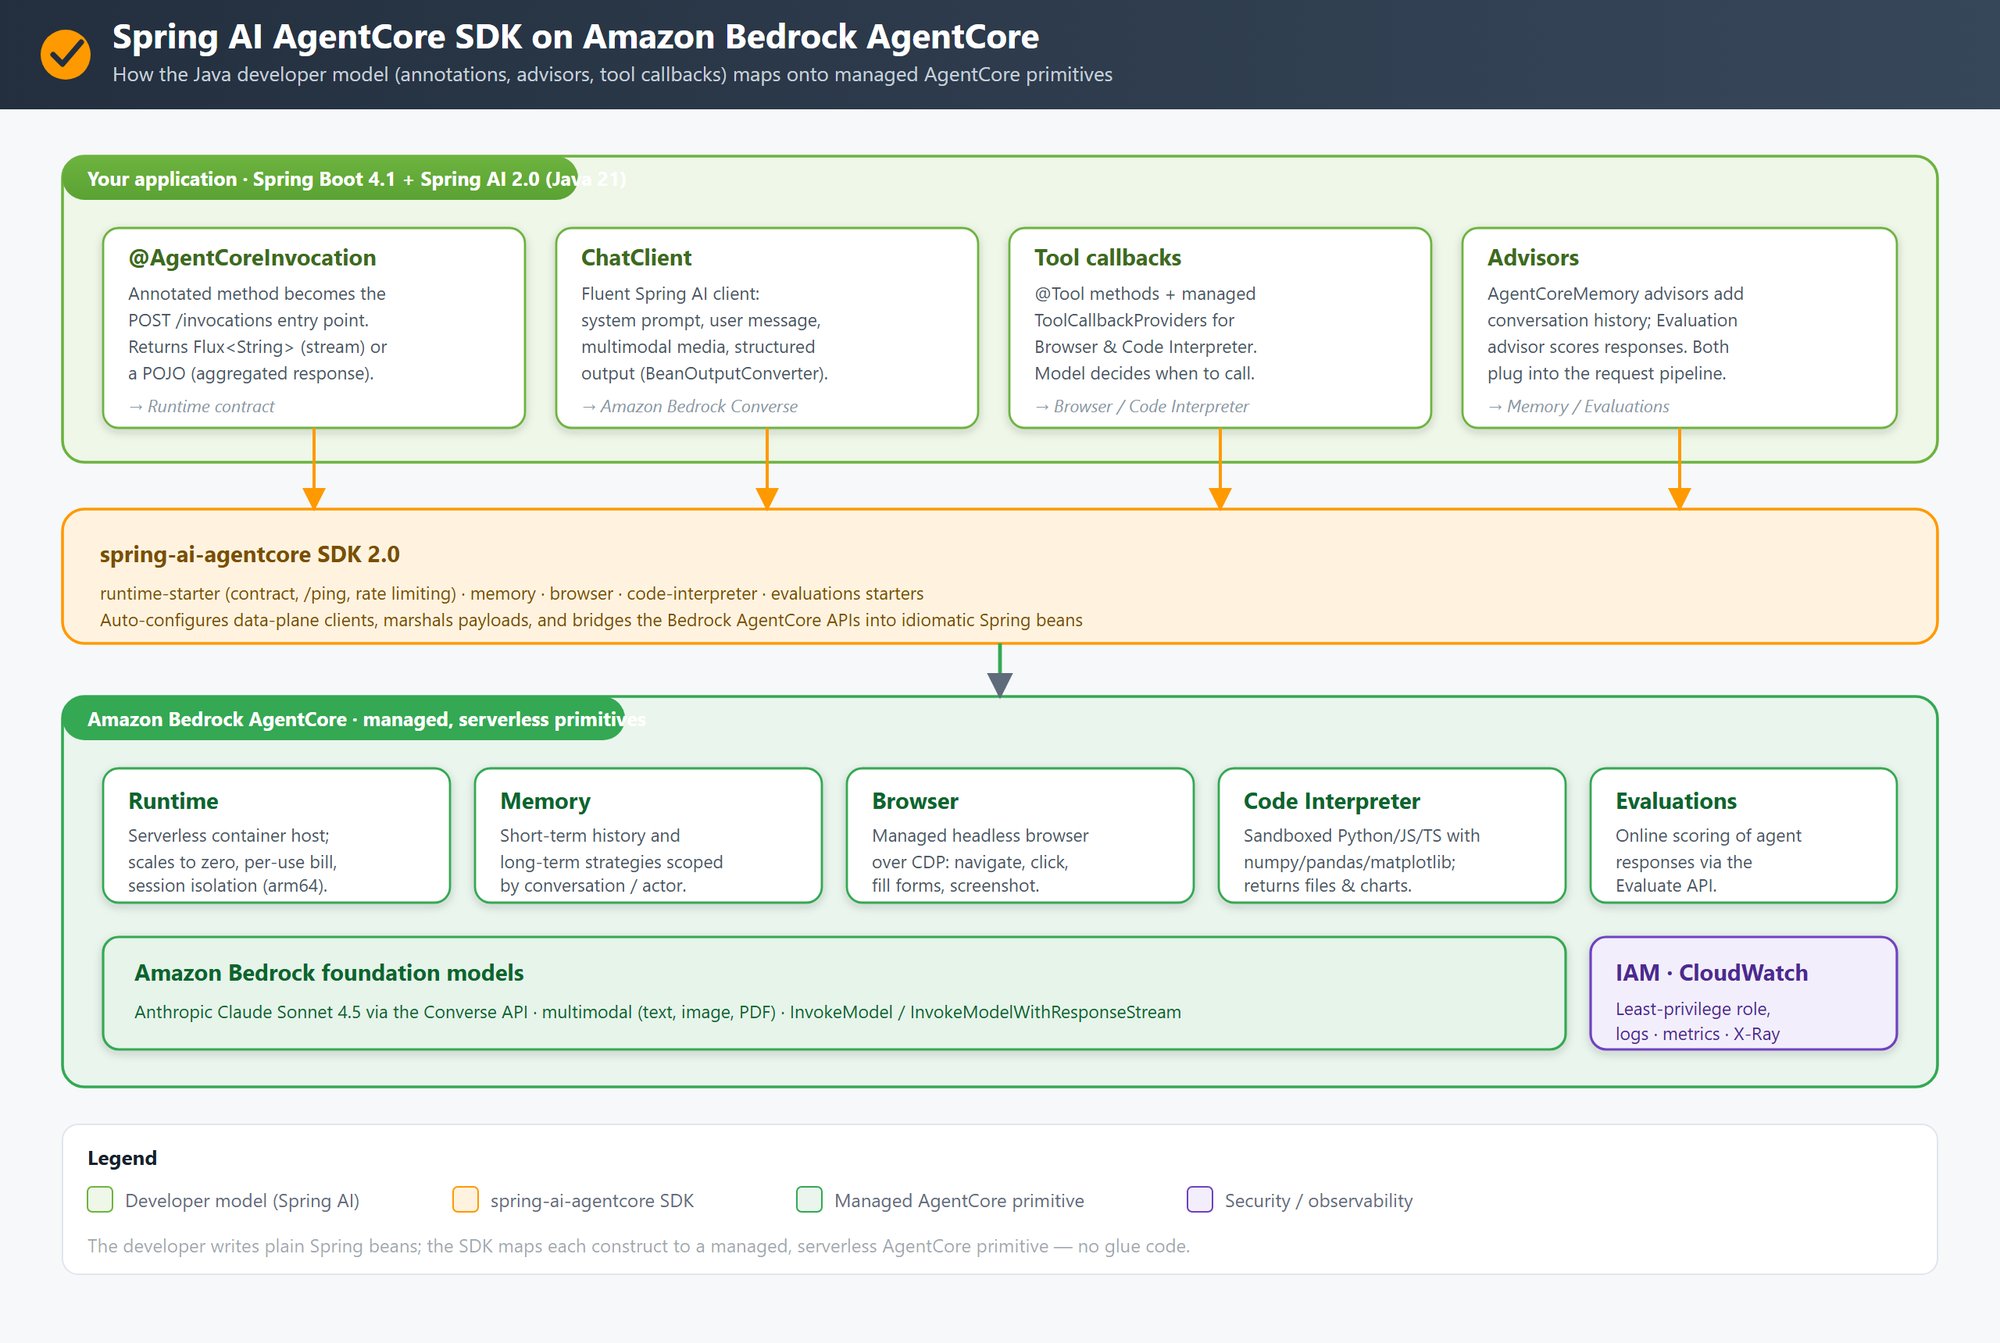
图 5:Amazon Bedrock AgentCore 上的 Spring AI AgentCore SDK。注解、ChatClient、tool callbacks 和 advisors 经 spring-ai-agentcore SDK 映射到 AgentCore runtime、AgentCore memory、AgentCore Browser、AgentCore Code Interpreter 和 AgentCore Evaluations。
由 spring-ai-agentcore SDK 连起来的两层。应用层用 Spring AI 组件 接 endpoint、ChatClient 做模型交互 callbacks,以及管 memory 与 guardrails 的 advisors。基础设施层提供 AgentCore runtime、AgentCore memory、AgentCore Browser、AgentCore Code Interpreter 和 AgentCore Evaluations,全都是 Amazon Bedrock AgentCore 的能力。SDK 把两层桥接起来,于是开发者写标准 Spring AI 代码,而生产基础设施交给 AgentCore。
有了 Spring AI AgentCore SDK,一个注解就能自动处理这份契约:
public class TravelAgent { private final ChatClient chatClient;
public TravelAgent(ChatClient.Builder builder) { this.chatClient = builder.build(); }
public Flux
关于流式的一点说明:上面那个最小示例直接返回模型流,对 chat UI 很理想。当 agent 要做带多个参数的工具调用时,请先用阻塞式 call() 组装回答,再把结果切块做流式传输,这样工具参数才能可靠绑定。旅行助手用同一个 service method 同时服务 AgentCore runtime 与 React UI:
public class AgentController { private final AgentService agentService;
public AgentController(AgentService agentService) { this.agentService = agentService; }
// One annotation wires up POST /invocations + GET /ping, JSON/SSE framing, and health.
public Flux
// The same app also serves the React UI from the same code base. (value = "/api/chat", produces = MediaType.TEXT_PLAIN_VALUE + ";charset=UTF-8") public Flux
实现工具调用
有了工具调用,模型能在推理过程中调用外部函数。在 Spring AI 里,你给一个方法加 ,由模型决定何时调它、带什么参数: (description = "Get a short weather forecast for a city") public String getWeather( (description = "City name") String city) { return forecastService.lookup(city); }
你在 ChatClient 上注册工具,模型自己决定何时调用它们:
ChatClient chatClient = chatClientBuilder .defaultSystem(properties.getSystemPrompt()) .defaultTools(new DateTimeTools(), new TravelTools()) .build();
要结构化输出,就请求一个 Java record 类型。要多模态输入,就把媒体附到 user message 上:
ProcessedDocument review = chatClient.prompt() .system(personaSystemPrompt) .user(u -> u.text(question).media(mimeType, fileResource)) .call() .entity(ProcessedDocument.class);
注意: 我们在 Amazon Bedrock 上用 Anthropic Claude Sonnet 4.5 验证过这个例子。Spring AI 把 record 的 schema 加进 prompt,再把回复解析回 Java 类型。其它模型家族的行为可能不同,当前支持情况请参考 Spring AI structured output 文档和 Amazon Bedrock 文档。这是 best-effort,也就是说模型偶尔会返回不匹配 schema 的输出。要更严格的结果,用带原生 schema 强制的 provider,或用 Spring AI 的校验与重试。
模型把工具定义作为 context 的一部分收到,推理出「什么时候一次工具调用有助于满足用户请求」,再返回一个结构化的 tool call 响应。Spring AI 拦下它,调用被注解的方法,把结果回喂给模型做进一步推理。
加入对话 memory
真实世界的 agents 必须记住用户在一场对话里早先说过什么(working memory),以及随着时间学到了什么(persistent memory)。Spring AI AgentCore SDK 经 advisor 模式与 AgentCore memory 集成:advisor 是在 prompt 抵达模型之前用上下文把它丰富的拦截器。
chatClient.prompt() .advisors(agentCoreMemory.advisors) .advisors(a -> a.param( ChatMemory.CONVERSATION_ID, "user:" + sessionId)) .user(prompt) .stream() .content();
session ID 变成 actor:session 形式的 conversation ID,因此每个用户的历史彼此隔离。对面向用户的部署,请从经过校验的 OAuth 2.0(JWT)身份里推出 actor,而不要用客户端传来的值,这样用户就无法访问彼此的历史。
此外,AgentCore memory 提供长期记忆支持,用下面这些策略从对话里识别并捕捉关键洞察:
Semantic – 关于用户的事实信息(例如「User works in finance」) User preference – 明确的设置与选择(例如「Metric units preferred」) Summary – 压缩后的对话历史,用于跨 sessions 的连续性。 Episodic – 过去的交互与汲取的经验。
长期记忆抽取是异步且可选的。你在创建 memory 时选启用哪些策略,AgentCore 在每场对话之后于后台抽取并归并记录,因此它从不阻塞 agent 的回答。按工作负载挑策略:旅行助手用 user preference,好让它记住单位和座位偏好;sessions 跨很多轮时用 summary;agent 该复用过去任务的经验时用 episodic;要留住关于用户的持久事实用 semantic。
配置 rules engine
读文档只是一半活儿,按发现去行动是另一半。IDP 多 agent 系统带一个 rules engine,让运维人员不碰代码就能加业务检查。这是一个进程内的规则求值器,把 SpEL 条件套到抽取结果上,不是 AWS Step Functions 那类工作流编排服务。规则放在 application.yml 里,每个条件都是一条针对抽取结果求值的 SpEL 表达式:
idp: review: enabled: ${REVIEW_ENABLED:true} confidence-threshold: ${REVIEW_CONFIDENCE_THRESHOLD:0.7} rules:
- id: legal-unsigned
agentType: LAWYER condition: "field('signaturePresent') == 'false' || missing('signaturePresent')" severity: ALERT message: "Document appears unsigned; get all parties to sign before relying on it."
- id: mortgage-high-dti
agentType: MORTGAGE condition: "field('dtiRatio') != '' && T(java.lang.Double).parseDouble(field('dtiRatio')) > 0.43" severity: WARN message: "Debt-to-income ratio exceeds 0.43; likely needs manual underwriting."
- id: low-confidence
agentType: ALL condition: "confidence < 0.6" severity: WARN message: "Low extraction confidence; consider human verification."
严重级别控制引擎行为。INFO 和 WARN 只记日志,ALERT 则经可插拔的 AlertService 派发。默认实现记日志并发一个指标,但你可以提供自己的 bean,换成 Amazon Simple Notification Service(Amazon SNS)、Slack 或邮件。BLOCK 会把文档扣下转人工评审。由于规则是运维配置、而非终端用户输入,它们构成一个安全且可审计的扩展点。新增工作流是一次配置改动,不是一次部署。
evaluator pattern 由 rules engine 和一个可插拔的 AlertService 实现。默认实现把告警记进日志并发一个指标。你提供自己的 bean,就能路由到 Amazon SNS、Slack 或邮件:
public class LoggingAlertService implements AlertService {
public void send(RuleResult result, AgentType agentType, ProcessedDocument document) { registry.counter("idp.alerts.sent", "severity", result.severity().name(), "type", agentType.name()).increment(); logger.warn("ALERT [{}] rule={} type={} message=\"{}\"", result.severity(), result.ruleId(), agentType, result.message()); } }
生产就绪模式
下面这些模式处理的是原型通常略过的常见生产要求。
韧性
每次模型调用都带 Resilience4j retry(指数退避)、一个在模型调用反复失败或超时时快速失败的 circuit breaker,以及一个 timeout。流式路径发一条 fallback 消息,而不是把原始错误抛出去。当流量超出你账户与 Region 的 service quotas 时,AgentCore runtime 返回 HTTP 429,由 retry 处理。当前限额见 Amazon Bedrock AgentCore quotas documentation。
Twelve-factor 配置
每个可配值(Region、model ID、memory ID、超时、限流、system prompt)都是一个绑定到带类型 @ConfigurationProperties 类的环境变量。应用无状态、启动快、缩容时把进行中的轮次排空,并作为一个不可变 ARM64 镜像交付,从开发到生产原样晋级。
安全与身份
Agentcore runtime 默认使用 AWS Identity and Access Management(IAM)认证。对面向用户的 agents,加一个 OAuth 2.0(JWT)authorizer(如 Amazon Cognito),并从经过校验的身份里推出 memory actor ID(actorId)。IAM execution role 遵循最小权限:
Amazon Elastic Container Registry(Amazon ECR)pull。 限定范围的 Amazon CloudWatch Logs 与 AWS X-Ray。 Amazon Bedrock InvokeModel actions。 为该 agent 的 workload identity 限定范围的 workload access tokens(GetWorkloadAccessTokenForJWT)。 限定到具体 Memory resource ARN 的 AgentCore memory actions。
AgentCore Gateway(Amazon Bedrock AgentCore 的一项能力)强制入站认证(作为 OAuth 2.0 resource server,经 Cognito、Okta、Auth0 或你自己的 OIDC provider 校验 JWT bearer tokens),并支持在 gateway 层配限流。限流默认 fail-open,因此它应当补强、而非替代你的核心安全控制。
Responsible AI 控制
会在真实世界采取行动的自主 agents,需要把安全控制当成一等关切。示例随附一个轻量进程内预检 GuardrailService 的替代演示,它筛掉不允许的意图和 prompt injection,由 guardrailsEnabled 标志按请求开关。生产部署把 Amazon Bedrock Guardrails 用作施加到每条请求上的标准控制,而不是一个按请求的开关。
要把这个演示服务升级到生产,就在 agent 前面挡上 Amazon Bedrock Guardrails。Guardrails 在模型调用之外施加可配置策略,同时覆盖输入与输出:
内容过滤。按可配置阈值,对 prompt 与 response 一并拦掉有害或离题内容。 拒绝话题。防止 agent 卷入你定义为范围之外的话题。 敏感信息过滤。检测并脱敏 prompt 与 response 里的 PII,支撑 GDPR、HIPAA 之类要求。
对会检索外部知识的 agents,打开 grounding checks,在 agent 依据带有真实世界副作用的工具调用行动之前,降低幻觉风险。
要把 Bedrock Guardrails 接进 Spring AI,实现调 ApplyGuardrail API 的 CallAdvisor 与 StreamAdvisor 函数,并在 ChatClient 上用 defaultAdvisors 注册。由于策略存在 guardrail 里,安全团队可以独立于应用发布周期更新过滤规则。
可观测性
示例用 Micrometer Observation API(@Observed)做埋点,产出计时器;加上 tracing bridge(OTLP 到 AWS X-Ray)后,它们就变成分布式 trace span。系统发出领域指标:
idp.documents.processed{type,status} idp.extraction.confidence{type} idp.alerts.sent{severity,type} idp.processing.duration{type}
这些指标经 /actuator/prometheus 暴露。应用还往标准输出发结构化 JSON 日志,由 Amazon Bedrock AgentCore runtime 采集进 Amazon CloudWatch Logs。
本文未实现的可选扩展:示例带了 Micrometer OpenTelemetry bridge 与 OTLP exporter 依赖,但本文的部署没有配 OpenTelemetry collector,也没启用 trace sampling。把 TRACING_SAMPLING 设为非零值、把 OTLP_TRACES_ENDPOINT 指向 OpenTelemetry 或 AWS Distro for OpenTelemetry collector,并配置该 collector 把 traces 转发给 AWS X-Ray,就能加上分布式追踪。
本文未实现的可选扩展:示例没有实现自动化的评估或优化反馈闭环。你可以把应用指标、traces、审计事件和人工评审结论持久化成一份评估数据集,从而补上它。随后 AgentCore evaluations 或一条独立的评估流水线,就能拿带版本的 prompts、模型、工具和路由规则,与质量、安全、时延、成本阈值作比较。只在评估与人工批准之后再晋级变更。
部署方案
这个 GitHub repository 含两个 AI agent 应用,演示自主 AI 的不同用例。本指南展示如何用 Amazon Bedrock AgentCore runtime 把它们部署到 AWS。
下图展示部署架构:一个 Arm64 镜像经分模块的 Terraform 晋级到 AgentCore runtime,另有一条可选的 Amazon Elastic Kubernetes Service(Amazon EKS)路径。
可选:跑在 Amazon EKS 上。 已经标准化到 Kubernetes 的团队可以把同一个 Arm64 镜像跑在 Amazon EKS 上,用既有集群对 /ping endpoint 做扩缩容与健康检查,并用 IAM Roles for Service Accounts(IRSA)为 pod 级访问 Amazon Bedrock 与 AgentCore memory 提供限定范围、最小权限的凭证。容器完全相同,因此应用里什么都不用改。
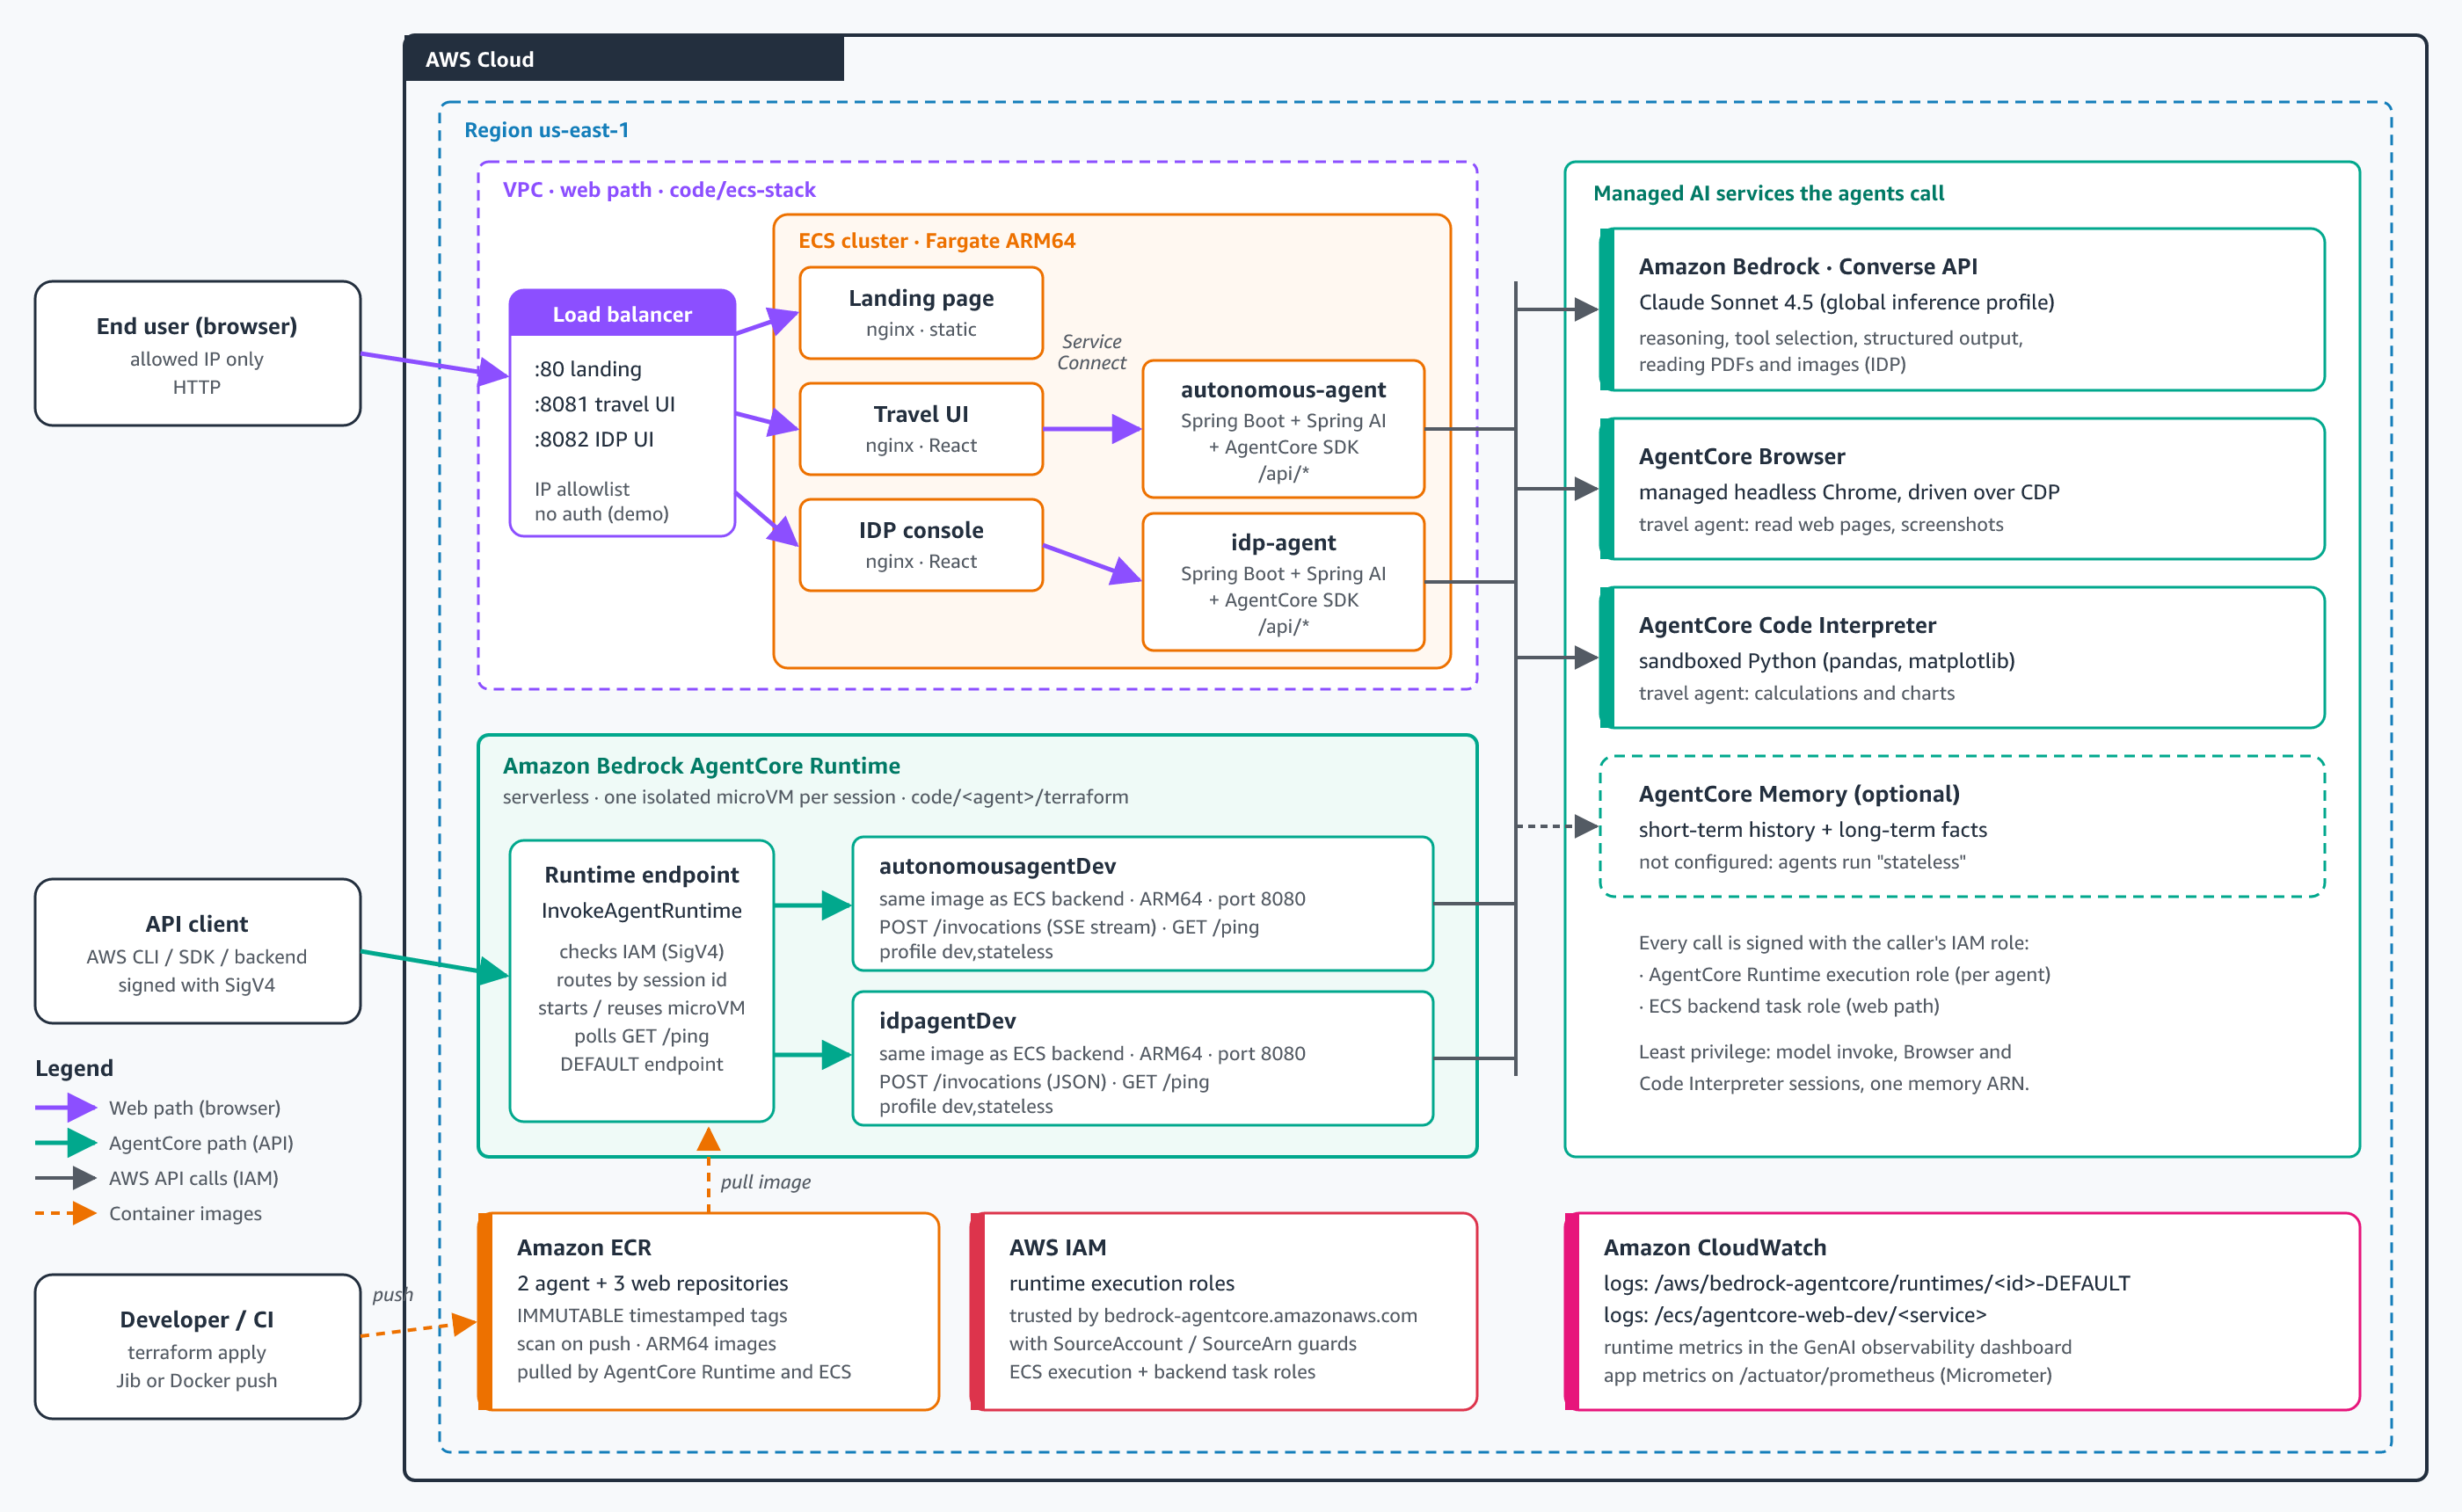
图 6:部署架构。分模块的 Terraform 供给 Amazon ECR、一个最小权限 IAM execution role 和 Bedrock AgentCore runtime,另有一条复用同一个 Arm64 镜像、配 IRSA 的可选 Amazon EKS 路径。
三个阶段:构建与发布、Terraform、在 AWS 上跑。CI 流水线把应用打成一个 linux/arm64 镜像,以不可变 tag 推到 Amazon ECR。三个 Terraform modules 分别供给 ECR repository、一个最小权限 IAM execution role 和 AgentCore runtime。agent 以无服务器方式跑在 AgentCore runtime 上,调用 Amazon Bedrock 与 AgentCore memory。可选的 Amazon EKS 路径复用同一个镜像,用 IRSA 提供限定范围的 pod 级凭证。
按下面这些步骤部署任意一个应用。
第 1 步:克隆 repository
打开终端跑:
git clone
第 2 步:进入你要部署的那个 agent 的目录
部署自主 agent: cd build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai/code/autonomous-agent 部署 IDP 多 agent 系统: cd build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai/code/idp-agent
第 3 步:配置 Terraform variables
部署基础设施之前,在 terraform 目录下的 terraform.tfvars 文件里配好你的 Terraform variables。
基础配置
多数设置方案都给了默认值,但你可以在 terraform.tfvars 文件里定制下面几项:
AWS Region:资源部署所在的 AWS Region。 Environment:用于资源命名的环境 ID(如 dev 或 prod)。 bedrock_model:Amazon Bedrock foundation model(例如 global.anthropic.claude-sonnet-4-5-20250929-v1:0)。各 Region 的模型可用性见 Supported models by AWS Region in Amazon Bedrock。
第 4 步:跑部署脚本
Linux/macOS:
./scripts/deploy.sh dev
Windows PowerShell:
.\scripts\deploy.ps1 dev
部署脚本做这些事:
建一个 Amazon ECR repository。 构建 Java 应用。 创建并推送 Docker container image。 创建一个 IAM execution role。 部署 AgentCore runtime。
第 5 步:跑应用
部署完成后,用下面这些命令运行应用。
Linux/macOS:
./scripts/run.sh dev
Windows PowerShell:
.\scripts\run.ps1 dev
清理
AgentCore runtime 能缩容到零、按调用计费,因此空闲的 agent 几乎不花钱。主要的可变成本是 Amazon Bedrock token 用量,外加少量 Amazon CloudWatch 与 Amazon ECR 存储。当前费率见 Amazon Bedrock AgentCore pricing 与 Amazon Bedrock pricing。为避免之后继续产生费用,用完后把基础设施拆掉:
Linux/macOS:
./scripts/cleanup.sh dev
Windows PowerShell:
.\scripts\cleanup.ps1 dev
用 AWS CLI 删掉不再需要的 AgentCore memory 资源和 Amazon ECR 镜像。
结语
本文里,你学到了如何用 Java 结合 Spring AI 与 Amazon Bedrock 构建自主 AI agents。我们讲了把模型变成 agent 的三种能力:规划、工具使用与 memory,也展示了 Amazon Bedrock AgentCore 的各项服务如何把 agent 送进生产。Spring AI AgentCore SDK 通过注解和熟悉的 ChatClient,把这些能力映射到惯用的 Spring 写法上。最后我们勾勒了多 agent 协作的架构模式,包括 router pattern、由 rules engine 实现的 evaluator pattern,以及作为可选扩展的 parallel fan-out。
对 Java 团队最要紧的一点:构建生产级 agents 不必离开你熟悉的环境。你已经信赖的那些模式(dependency injection、configuration properties、advisors、Actuator、Micrometer)可以直接带进 agentic 世界。生产所要求的 runtime、memory、identity 和治理,由 AgentCore 提供。
下一步可以考虑:
通过 AgentCore Gateway 和 Model Context Protocol(MCP) 接上企业系统 加上 Amazon Bedrock Knowledge Bases(全托管的 RAG 能力)与网页搜索,让 agent 基于你的数据推理。 实现 Amazon Cognito JWT 认证,并按用户隔离 memory。 定制 Amazon Bedrock Guardrails 策略:加领域专属的拒绝话题、收紧内容过滤阈值,并启用按你的知识源调过的 grounding checks。 用 AgentCore Evaluations 给生产 traces 打分,在评审之后晋级 prompt 或模型变更。
每一项都是在你已经建好的地基上做增量添加,不是推倒重写。
关于作者