在线AI教程 / AI工具
[Amazon Bedrock] 使用 NVIDIA NeMo Switchyard 将 coding agent 请求路由到 Amazon Bedroc…
人工智能 使用 NVIDIA NeMo Switchyard 将 coding agent 请求路由到 Amazon Bedrock 上的正确模型 Claude Code、Open
人工智能
使用 NVIDIA NeMo Switchyard 将 coding agent 请求路由到 Amazon Bedrock 上的正确模型
Claude Code、OpenAI Codex CLI 这类 coding agent 以任务为单位工作。开发者提出一处改动,agent 便读取文件、编辑代码、运行测试,直到完成为止。一个任务可能只需几次模型调用,也可能需要几十次。开发者付费买的是整个任务,而不是某一次调用。
单看每 token 的价格,并不能告诉你一整个任务要花多少钱。总成本取决于模型需要多少轮、每轮要重放多少历史,以及任务有多经常需要重试、或者干脆跑不完。每一次尝试都要付费,包括那些最终没跑完的任务上的尝试。所以,当你在多个模型之间路由 coding agent 的请求时,要用「每个已解决任务的成本」来衡量路由好坏:所有运行的总成本,除以测试通过的运行次数。
NVIDIA NeMo Switchyard 是一个开源库,帮助 AI agent 决定每个请求由哪个模型来处理。你来定义它可用的模型,以及它遵循的策略。它的 LiteLLM 集成 支持两种策略。Stage 路由会读取请求历史里最近的工具活动和结果,再从两个候选模型中挑一个。Random 路由从配置好的模型里挑选,可带权重,用于流量切分和 A/B 对比。你还可以考虑另一个选择:LiteLLM 最近也内置了原生的 Switchyard stage router,作为一种自动路由策略。
本文里,你会用 AWS Cloud Development Kit (AWS CDK) 在自己的 AWS 账户中部署 LiteLLM——一个面向大语言模型 (LLM) 的开源网关——并带上 Switchyard 路由插件。LiteLLM 调用 Amazon Bedrock 上的模型。然后用示例自带的基准运行器,分别测量路由模型组和单模型基线组的「每个已解决任务成本」,好让你拿自己的工作负载来评估路由效果。
注意:该示例从 crates.io 安装 switchyard-server 0.3.0,并运行已发布的 LiteLLM v1.102.0 镜像。NVIDIA 把 switchyard-server 0.3.0 定位为演示与评估组件,其配置可能随版本变动。本示例用的是实验性的 Switchyard LiteLLM 集成,其配置和 API 也可能随版本变动。这是示例代码,仅供非生产用途。部署前请与安全和法务团队协作,满足组织在安全、监管和合规方面的要求。请在非生产账户中部署该示例,先测试再正式依赖它。
解决方案概述
图 1 展示了该解决方案的架构。LiteLLM 和 Switchyard 插件跑在同一个容器镜像里,该镜像位于私有子网中,运行在 AWS Fargate 上的 Amazon Elastic Container Service (Amazon ECS)。
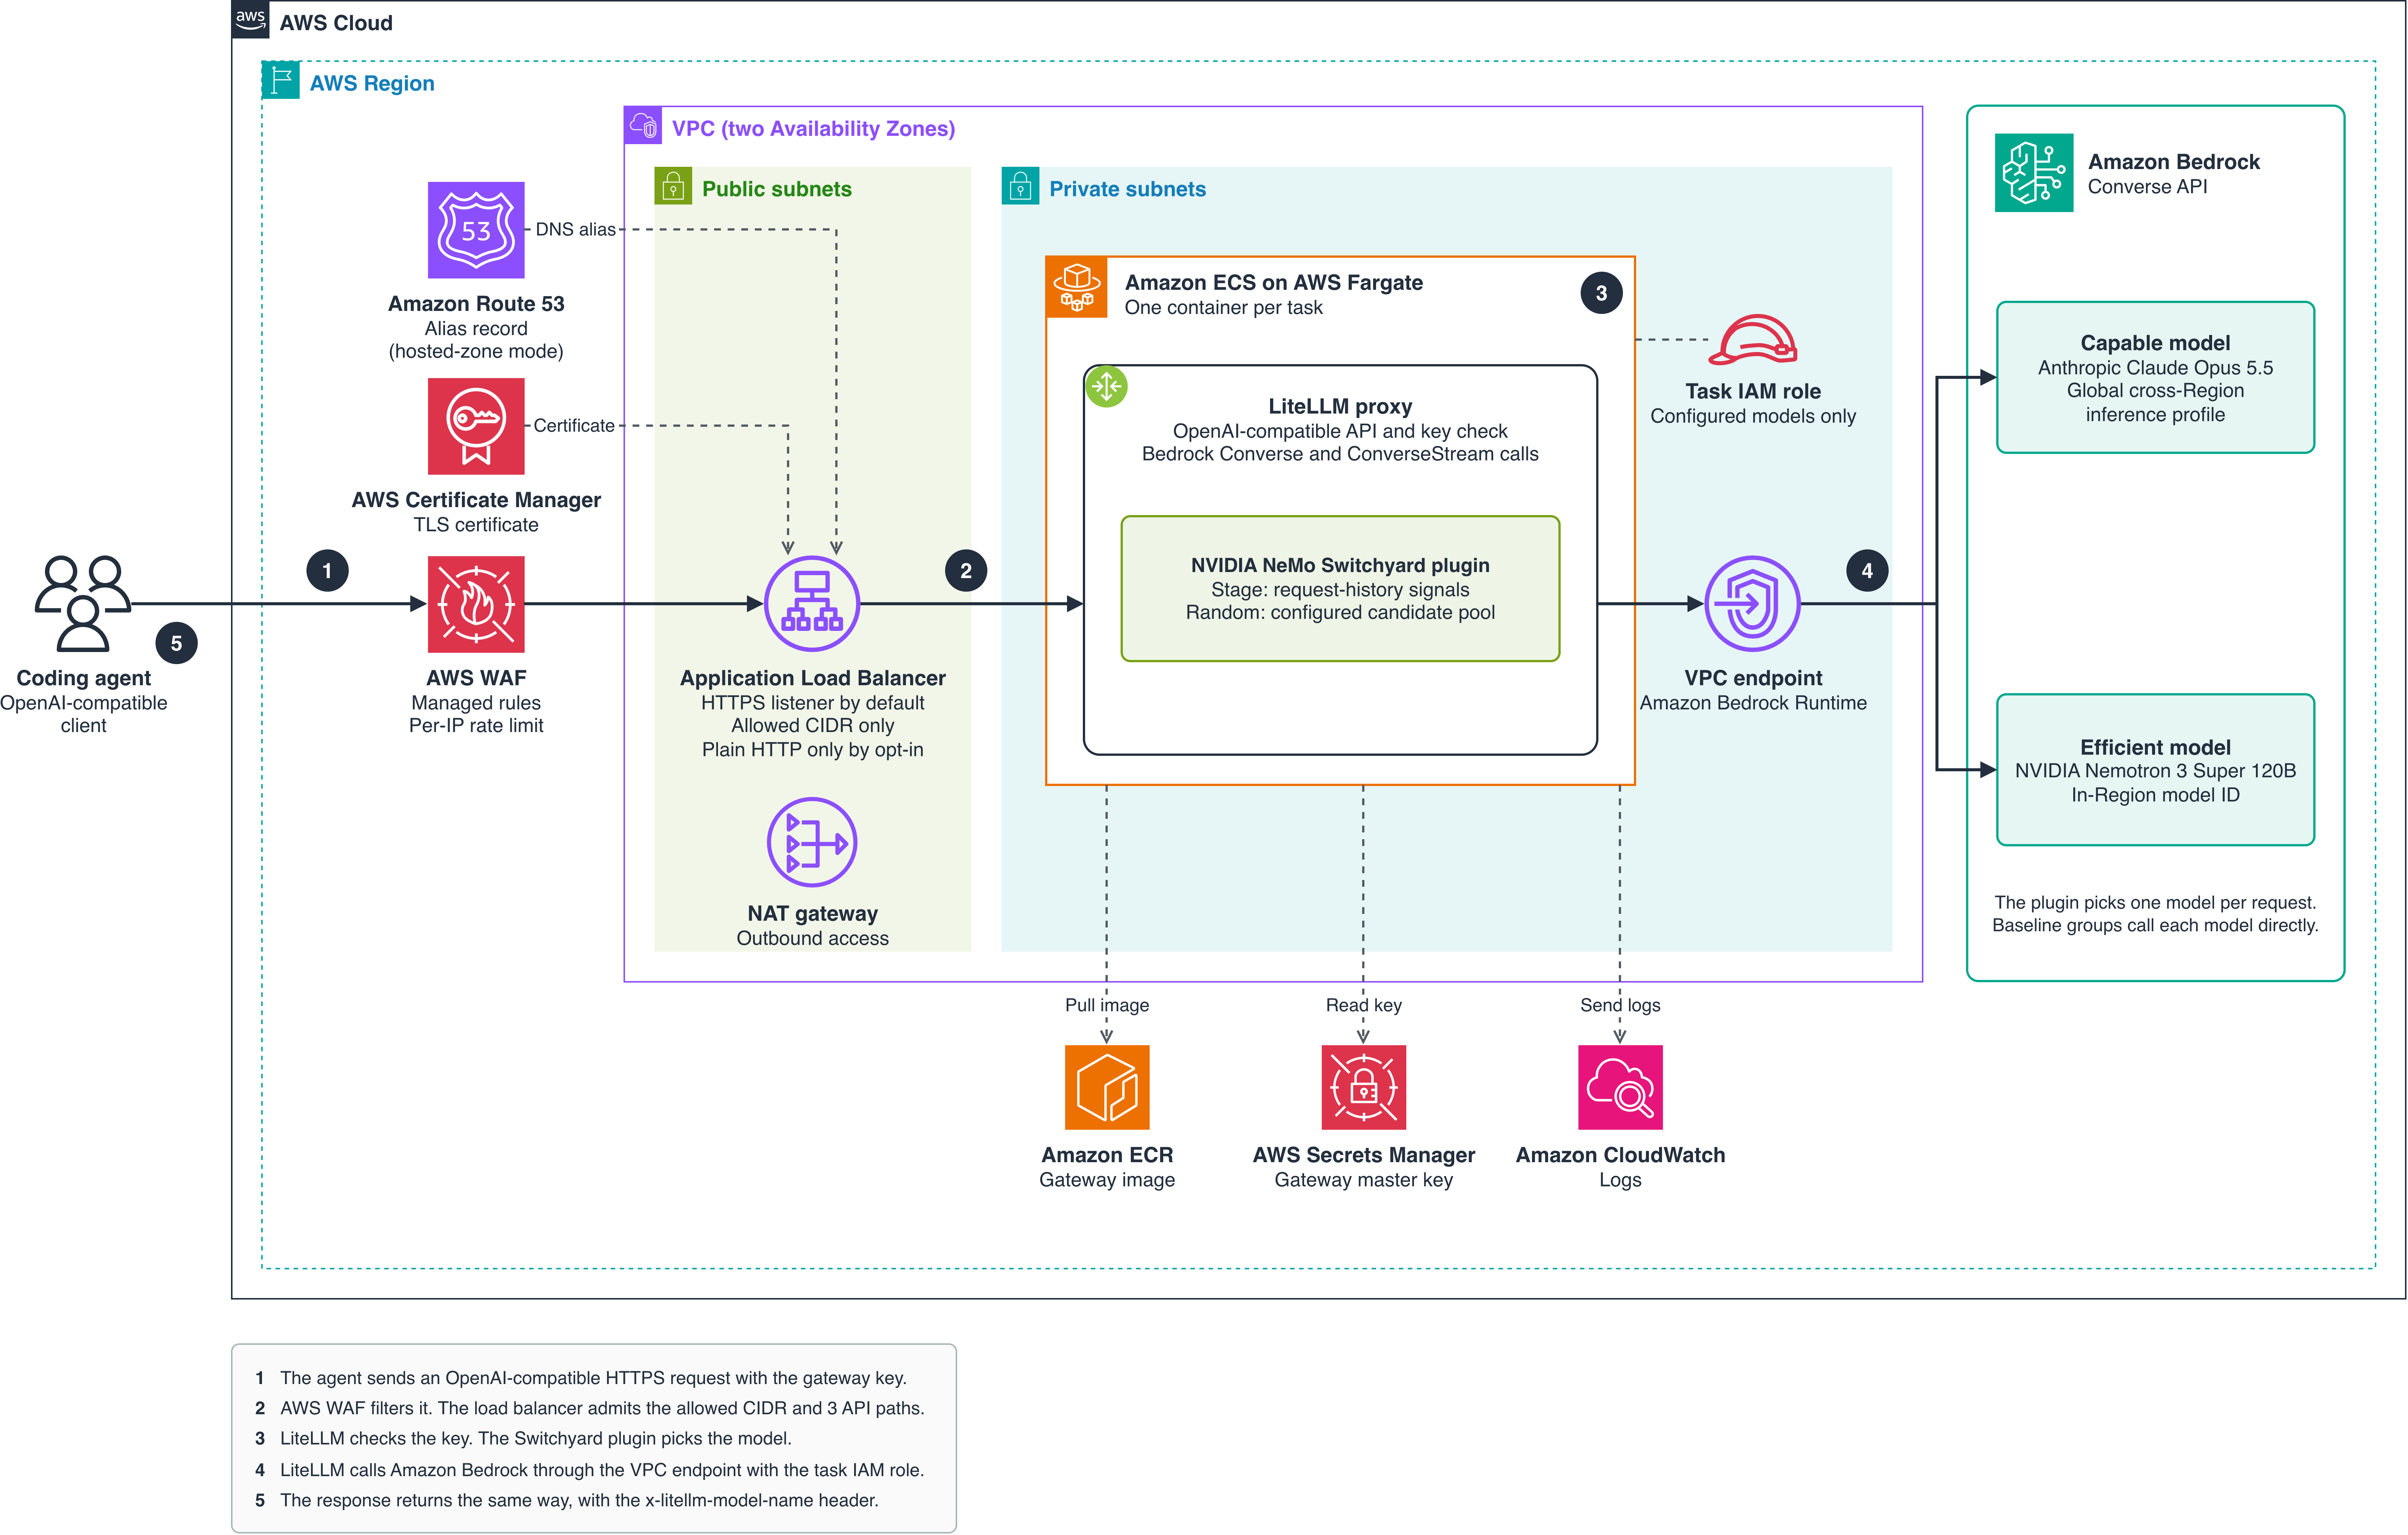
图 1:解决方案架构
请求会经过下面这些步骤,编号与图中一致。
coding agent 发送一个兼容 OpenAI 的请求,model 字段设为 switchyard(即 Switchyard 负责路由的 LiteLLM 模型组),并在 Authorization 头里带上共享的网关密钥。endpoint 是你自己的主机名,走 HTTPS,负载均衡器上配有 AWS Certificate Manager (ACM) 证书,且只允许你放行的 IPv4 CIDR 段访问。借助 Amazon Route 53 里的托管区域,Route 53 把该主机名解析到负载均衡器。 AWS WAF 依据 IP 信誉、已知恶意输入和按 IP 限速规则过滤请求。Application Load Balancer 只把 /v1/chat/completions、/v1/models 和 /health/liveliness 转发到私有子网里的 ECS 任务,其余路径一律返回 404。 该任务只跑一个容器:内嵌 Switchyard 插件的 LiteLLM。LiteLLM 校验网关密钥,再调用插件来挑模型。Stage 在能力更强的模型与成本更低的高效模型之间做选择;它会读取请求历史里的工具活动和结果,因此 agent 必须发送完整的对话历史。Random 则从带权重的模型池里挑选。两种策略都不会调用裁判模型。 LiteLLM 通过 Amazon Bedrock 的 Converse 或 ConverseStream API 调用选中的模型,凭证来自该任务的 AWS Identity and Access Management (IAM) 角色。调用经由 Amazon Virtual Private Cloud (Amazon VPC) 里的 Amazon Bedrock Runtime interface endpoint,因此推理流量始终留在 AWS 网络内。 响应或 token 流经 LiteLLM 和负载均衡器返回。x-litellm-model-name 响应头会标出实际作答的模型。响应体里的 model 字段仍是 switchyard。
LiteLLM 在容器内监听 4000 端口,是负载均衡器的目标;任务的安全组只允许负载均衡器接入。路径白名单让 LiteLLM 的管理界面、API 文档和密钥管理路由都无法从外部访问。Amazon Elastic Container Registry (Amazon ECR) 存放网关镜像。AWS Secrets Manager 生成网关密钥背后的 secret,容器启动时再加上 sk- 前缀。任务定义通过 LITELLM_CONFIG_TEXT 和 SWITCHYARD_CONFIG_TEXT 传入配置文件,启动脚本在拉起 LiteLLM 前把它们写到 /tmp。日志统一进一个 Amazon CloudWatch 日志组 /
该插件支持 Stage 路由(需要恰好两个候选模型)和 Random 路由(至少需要两个,并按权重切分流量以做 A/B 测试)。由分类器驱动的策略,例如 Task 和 Composite 路由,需要中间的模型调用,而这个集成并不支持。完整清单见 Switchyard 路由概览。
先决条件
要跟着本文走一遍,你需要准备:
一个非生产用的 AWS 账户,且在 Amazon Bedrock 上能访问 Claude Opus 5.5 和 NVIDIA Nemotron 3 Super 120B。这一对模型已在 US East (N. Virginia) 测过。其他 AWS Region 请查看各模型的区域可用性以及 tool-calling 支持情况。 装好 AWS Command Line Interface (AWS CLI) v2,配好凭证并显式指定 AWS Region;所在账户和 Region 要已 为 AWS CDK 完成 bootstrap。 Node.js 20 或更高版本、npm、带 BuildKit 的 Docker,以及 Python 3.11 或更高版本。 一个你自己拥有的主机名,并且要么其域名有公开的 Route 53 托管区域,要么在部署 Region 里有对应的 ACM 证书。只做简短的纯 HTTP 测试则两者都不需要。
演练
你要定义模型组、配置 Stage、部署并测试网关,再测量成本。先克隆示例仓库:
git clone cd sample-route-coding-agent-requests-Amazon-Bedrock-nemo-switchyard
第 1 步:在 LiteLLM 中定义模型组
一个 LiteLLM 模型组就是一个对外的模型名,背后挂一个或多个 deployment。示例把配置放在 profiles/ 下的部署 profile 里。每个 profile 都由 litellm.yaml(定义模型和网关设置)与 switchyard.toml(控制 Switchyard 如何挑模型)配对组成。下面这段 profiles/stage/litellm.yaml 的摘录定义了被路由的 switchyard 组、两个单模型基线组,以及插件注册:
model_list:
- model_name: switchyard
litellm_params: model: bedrock/converse/global.anthropic.claude-opus-5-5 aws_region_name: os.environ/AWS_REGION
- model_name: switchyard
litellm_params: model: bedrock/converse/nvidia.nemotron-super-3-120b aws_region_name: os.environ/AWS_REGION
One-model baseline groups, same model strings as the routed candidates.
- model_name: claude-opus-5-5
litellm_params: model: bedrock/converse/global.anthropic.claude-opus-5-5 aws_region_name: os.environ/AWS_REGION
- model_name: nemotron-super-3-120b
litellm_params: model: bedrock/converse/nvidia.nemotron-super-3-120b aws_region_name: os.environ/AWS_REGION
The same object selects a deployment and applies supported request changes.
router_settings: plugins:
- switchyard_gateway.configured.ROUTING_PLUGIN
litellm_settings: callbacks:
- switchyard_gateway.configured.ROUTING_PLUGIN
drop_params: true request_timeout: 600 num_retries: 2 general_settings: master_key: os.environ/LITELLM_MASTER_KEY
两个候选都共用 model_name: switchyard,因此客户端发送 "model": "switchyard",由 Switchyard 挑一个候选。要把能力更强的模型列在前、高效模型列在后,因为 Stage 按这个顺序读取角色。
claude-opus-5-5 和 nemotron-super-3-120b 这两个组是单模型基线。每组始终用自己的模型作答,这样你就能在同一次部署里,把路由组的成本和通过率与每个模型单独跑的结果对比。Stage 插件本身会拒绝候选不足两个的组,因此镜像注册了一个小包装器 switchyard_gateway.configured.ROUTING_PLUGIN:对含两个及以上唯一候选的组套用 Switchyard,单模型组则直接放行。配置把这个包装器注册了两次,一次用来挑模型,一次用来应用 Switchyard 记录下的请求改动。
每个模型都用 bedrock/converse/
这个文件里不放任何凭证。LiteLLM 从环境变量读取网关密钥,任务角色提供 AWS 凭证。切勿在 litellm_params 下添加 aws_access_key_id、aws_secret_access_key 或 api_key 这类凭证:stack 会把整份 litellm.yaml 以明文复制进任务定义和 AWS CloudFormation 模板。
stack 会依据这个文件推导任务角色的 Amazon Bedrock 权限。对于 global cross-Region inference profile,基础模型资源用 作为 Region、末尾再带一个 ,因此也会匹配到前缀相同的其他 model ID。部署前请先审视推导出的策略。
global. 前缀表示这是一个 global cross-Region inference profile,Amazon Bedrock 可能会在全球受支持的商业 AWS Region 里处理这些请求。如果处理位置很重要,请改用 geographic profile 或 in-Region model ID。对 Nemotron 3 Super,该 profile 用的是 in-Region model ID nvidia.nemotron-super-3-120b,测试时你可以换成任意模型。
第 2 步:配置 Stage 路由
Switchyard 从 switchyard.toml 读取算法和设置。默认 profile profiles/stage/switchyard.toml 配置的是 Stage:
Model inventory is in litellm.yaml. This file configures selection behavior.
algorithm = "stage"
Prefer the efficient candidate when history signals are inconclusive.
picker = "efficient_first" confidence_threshold = 0.5
Inspect the three most recent tool results for execution signals.
recent_window = 3 only_on_wrong_signal_escalation = true
这几项设置的作用如下:
picker = "efficient_first":当历史里的信号不明确时,Stage 用高效模型。新请求还没有工具结果,因此会发给 Nemotron 3 Super。 confidence_threshold:Stage 为执行信号打分所用的置信度阈值,取值 0 到 1。 recent_window = 3:Stage 检查最近三个工具结果。 only_on_wrong_signal_escalation = true:Switchyard 的默认值。它控制 Stage 何时添加可选的 escalation note,而这个 profile 没有设置任何 note。
Stage 还接受可选的 handoff note 和逐层 system prompt(escalation_note、deescalation_note、capable_system_prompt、efficient_system_prompt)。示例 profile 一个都没设置。
要做 A/B 测试,profiles/random/ 里的 Random profile 用的是同一批模型,只是设成 algorithm = "random" 和 weights = [0.5, 0.5],按声明顺序给每个唯一候选一个权重。要部署它,在第 3 步的 cdk diff 和 cdk deploy 命令里加上 -c routingProfile=random。
stack 在 synth 时会一并校验这两个文件,preflight 脚本跑的是同样的检查。只想单独检查某处 profile 改动、不调用 AWS 时,运行 npm run validate:profile -- stage。无效设置会在 LiteLLM 启动时把它拦下,不受支持的 message 结构则在推理前就失败。
可选:在本地运行网关
在部署之前,你可以先在自己的机器上试跑网关。Docker Compose 构建的是同一个镜像,读取的也是 stack 部署到 Amazon ECS 的那同一批 profile 文件。在仓库根目录运行:
npm ci cp .env.example .env
export LITELLM_MASTER_KEY="sk-$(openssl rand -hex 24)" eval "$(aws configure export-credentials --format env)"
ROUTING_PROFILE=stage docker compose up --build --wait GATEWAY_URL=http://127.0.0.1:4000 ROUTING_PROFILE=stage scripts/smoke-test.sh
你导出的这个密钥优先于 .env 里的占位值,所以 Compose 和 smoke test 用的是同一把。AWS 凭证只来自你的 shell,绝不写进 .env 或 profile 文件。Compose 只在 127.0.0.1 上发布网关。本地没有负载均衡器,因此 smoke test 会跳过针对封闭路径的检查。本地网关依旧会调用 Amazon Bedrock,这些调用照样计费。用完之后运行 docker compose down。
第 3 步:部署网关
网关在你拥有的主机名上提供 HTTPS。把 GATEWAY_DOMAIN 设为该主机名,把 HOSTED_ZONE 设为包含它的、已存在的 Route 53 公开托管区域。随后 AWS CDK 会创建经 DNS 验证的 ACM 证书和别名记录。在仓库根目录安装依赖、跑一遍只读的 preflight 检查,然后部署:
npm ci
export AWS_REGION=us-east-1 export AWS_DEFAULT_REGION="$AWS_REGION" eval "$(aws configure export-credentials --format env)" export CDK_DEFAULT_REGION="$AWS_REGION" export CDK_DEFAULT_ACCOUNT="$(aws sts get-caller-identity --query Account --output text)" export ALLOWED_CIDR="$(curl -4 -fsS --connect-timeout 5 --max-time 15 )/32" export GATEWAY_DOMAIN=llm-gateway.example.com export HOSTED_ZONE=example.com
scripts/preflight.sh npx cdk diff -c allowedCidr="$ALLOWED_CIDR" \ -c domainName="$GATEWAY_DOMAIN" -c hostedZone="$HOSTED_ZONE" npx cdk deploy -c allowedCidr="$ALLOWED_CIDR" \ -c domainName="$GATEWAY_DOMAIN" -c hostedZone="$HOSTED_ZONE"
如果你的域名 DNS 不在 Route 53 里,就改用一张现成的 ACM 证书:把 CERTIFICATE_ARN 设为部署 Region 中该主机名对应的 ACM 证书,并在两条命令里把 -c hostedZone="$HOSTED_ZONE" 换成 -c certificateArn="$CERTIFICATE_ARN"。这样 AWS CDK 就不会创建证书和 DNS 记录。部署完成后,再建一条 CNAME 记录(或 Route 53 别名),把主机名指向 LoadBalancerDnsName 这个 output。
必填的 allowedCidr 用来限定哪些网络能访问负载均衡器,命令里把它设为你当前的公网 IPv4 地址。务必只留你自己的 /32:凡是共用同一个放行地址的任何人(比如办公室 NAT 或 VPN 出口)都能访问这个 endpoint。缺了 allowedCidr、用了 0.0.0.0/0 这种对全网开放的范围,或者给了 IPv6 范围,stack 都会拒绝 synth。
preflight 会检查配置、你的工具以及 AWS 访问权限,包括 profile 里每个模型的访问权限,全程不发推理请求。AWS CDK 构建网关镜像、发布到 Amazon ECR 并部署 stack。部署会打印出这些 output:
输出含义 GatewayUrl基础 URL。兼容 OpenAI 的 API 在 /v1 下。 MasterKeySecretArn网关密钥背后的 Secrets Manager secret。完整密钥是 sk- 加上 secret 的值。 MasterKeyCommand一条打印网关密钥的命令。 SmokeTestCommandsmoke test 命令,已填好 stack 名、Region 和 profile。 RoutingProfile当前生效的路由 profile,默认是 stage。 ClusterName, ServiceNameECS 集群和服务。轮换密钥的步骤会用到它们。 LoadBalancerDnsName仅在使用 certificateArn 时出现:供主机名指向的那个名称。
给客户端的一律是 https:// URL。80 端口只为重定向到 HTTPS 而开放;配成 http:// 的客户端,在重定向到达之前就已经把密钥和第一个请求以明文发出去了。
为容纳 agent 的长响应,负载均衡器的空闲超时设为 10 分钟。web ACL 使用 Amazon IP 信誉列表和 known bad inputs 规则组,并把每个 IP 限制为每 5 分钟 2,000 次请求。它略去了针对跨站脚本、SQL 注入和 body 大小的通用规则,因为 agent 请求里的源代码会触发这些规则。allowedCidr 范围和网关密钥依然生效。
用纯 HTTP 快速测试。 没有 HTTPS 设置时,synth 会报错停下。要在没有域名的情况下做个简短测试,可以选择在负载均衡器的 DNS 名称上启用纯 HTTP:
npx cdk deploy -c allowedCidr="$ALLOWED_CIDR" -c allowPlainHttp=true
设了 allowPlainHttp=true 后,AWS CDK 每次 synth 这个 stack 都会打印一条警告。Authorization 头里的网关密钥、你的 prompt、agent 发出的工具结果与源代码,以及模型响应,在客户端和负载均衡器之间都以未加密形式过网。这个开关只用于从你自己的 /32 拿非敏感代码做一次简短测试。之后记得轮换密钥,用完运行 cdk destroy。若日后要把同一个 stack 切到 HTTPS,带上 HTTPS 设置、不带 allowPlainHttp 重新部署一次即可。
第 4 步:测试网关
在部署时用的同一个终端里,读取 AWS CloudFormation 的 stack output,拼出网关密钥:
export STACK_NAME=SwitchyardGateway
output() { aws cloudformation describe-stacks --region "$AWS_REGION" --stack-name "$STACK_NAME" \ --query "Stacks[0].Outputs[?OutputKey=='$1'].OutputValue" --output text }
export GATEWAY_URL="$(output GatewayUrl)" export LITELLM_MASTER_KEY="sk-$(aws secretsmanager get-secret-value --region "$AWS_REGION" \ --secret-id "$(output MasterKeySecretArn)" --query SecretString --output text)"
向 switchyard 模型组发一个请求:
curl -sS -i --connect-timeout 10 --max-time 180 "$GATEWAY_URL/v1/chat/completions" \ -H "Authorization: Bearer $LITELLM_MASTER_KEY" \ -H "Content-Type: application/json" \ -d '{"model":"switchyard","messages":[{"role":"user","content":"Reply with the word hello."}],"max_tokens":128}'
看到 HTTP 200 和响应体就成了。x-litellm-model-name 响应头会以完整的 LiteLLM 模型字符串给出被选中的模型。新请求没有可供打分的工具结果,因此 Stage 选中高效模型 bedrock/converse/nvidia.nemotron-super-3-120b。
要检查健康状况、鉴权和路由,运行 smoke test:
ROUTING_PROFILE="$(output RoutingProfile)" scripts/smoke-test.sh
smoke test 会检查 health endpoint、/ui 这类封闭路径是否拿到负载均衡器自己的 404、不带密钥的请求是否拿到 401,以及 /v1/models 是否列出所有模型组。对 Stage,它会检查普通请求是否选中高效模型、以及一段记录了反复失败的历史是否会升级到能力更强的模型。随后它给每个基线组各发一个请求。这些请求和 smoke test 都会产生计费的 Amazon Bedrock 调用。
想试自己的 agent,就把 $GATEWAY_URL/v1 当作它兼容 OpenAI 的 base URL,把网关密钥当作 API key,模型填 switchyard。Stage 要求每个请求都带上完整的、受支持的请求历史。上游 adapter 支持文本消息、function tool call 和文本工具结果,不受支持的 message 结构会在推理前失败。负载均衡器转发 Chat Completions 路径,但不转发 OpenAI Responses 或 Anthropic Messages 路径。用这些 API 的客户端会一直拿到 404,直到你加上对应路径、对着本地容器测过并重新部署。
第 5 步:测量每个已解决任务的成本
示例里的 coding runner bench/run.py 让一个小型 coding agent 能够列出并读取文件、替换源文件,并通过网关运行随附的单元测试。任务在测试最终通过时算作已解决,默认上限是六个模型轮次。先列出任务,再从路由组上的 slugify 开始:
python3 bench/run.py --list-tasks python3 bench/run.py --tasks slugify --model switchyard --max-turns 6
终端会显示任务、被选中的模型、工具动作、测试结果和最终的代码 diff。每次运行都把起始文件、最终工作区、transcript、patch 和结果存到 bench/results/ 下。
任务agent 要做什么 slugify修复一个生成 URL slug 的短函数。 roman写一个把整数转成罗马数字的函数。 calc写一个不用 eval 的表达式解析器,要支持优先级、幂运算符、函数和错误处理。 lru_ttl写一个线程安全的 least recently used (LRU) 缓存,带逐条过期和精确计数。
为了给算术解析器任务留出跑测试、尝试修复的余地,把轮次上限调高:
python3 bench/run.py --tasks calc --model switchyard --max-turns 12
跑完之后,runner 会为每个模型组打印一行,列有 RUNS、SOLVED、ERRORS、COST/TASK 和 COST/SOLVED。每个已解决任务的成本,就是该组所有运行的估算成本除以测试通过的运行数。runner 依据 x-litellm-model-name 头里的模型和响应中的 token 用量,用 bench/run.py 里的 PRICES 表给每一轮定价。某一轮若命中缓存输入、模型没有 PRICES 条目,或响应缺少该头或 token 计数,就保持未定价,而不是记成零。往 profile 里加模型时记得补一条 PRICES 条目,并查 Amazon Bedrock 定价 了解最新价格。在两个任务上跑几次足以演示整个流程,但不足以对成本或质量下结论。
只要某组里有任何一次运行未定价,该组就会显示 n/a 并附原因;没有任何运行被解决时,COST/SOLVED 显示 -。想看清成本花在哪儿,就去查每一轮:终端会打印服务该轮的模型,bench/results/ 下的 transcript 也记着它。
要比较整段对话,bench/multiturn.py 会在每个 coding 任务上跑一个 agentic 循环:把项目文件放进第一个 prompt,每次编辑后把测试输出回喂进去。它还会跑四段脚本化的对话,各七轮,把简单轮次与设计、调试、写代码轮次交替安排,并在每一轮重放完整历史。带廉价检查的轮次(预期文本、字数上限、要点列表,或针对返回函数的断言)会记录检查是否通过。设计类回答不计分。
python3 bench/multiturn.py --tasks slugify --scripts backend api --max-spend 2
--max-conv-cost 选项(默认 1 USD)给每段对话设上限,--max-spend 则让 runner 不再开启新对话。汇总里按每个模型组列出:通过的 coding 对话数、通过的对话检查数,以及每段 coding 对话、每段对话和总计的估算成本。
这些 runner 会在你的机器上执行模型写出来的 Python。跑测试的子进程环境里没有凭证,但它并不是操作系统级 sandbox:代码能读到你的用户能读的任何文件,也能连网。请用一次性的开发环境,磁盘上别放长期有效的 AWS 凭证,并保护好 bench/results/ 下的文件——里面有 prompt、模型响应、工具输出和生成的代码。
解读结果
示例里的任务都很小,只作示意。要判断路由是否适合你的工作负载,请换成或补上能代表自己代码库的任务,并在读 runner 输出时记住以下几点。
先看 SOLVED,再读 COST/SOLVED – 解决任务更少的组,COST/TASK 可能更低,但每个已解决任务的成本反而更高,因为失败的运行只加成本、不加已解决的任务。先比过各组解决了多少任务,再去比路由组与各基线组的 COST/SOLVED。 把难任务单独拎出来看 – 汇总数字可能掩盖了真正决定结果的某一个任务。按任务拆开看。Stage 是依据历史里的失败来做判断的,因此没法提前把难任务路由到能力更强的候选模型。升级后的那一轮还会重放整段失败尝试,可能让一次恢复比一开始就用能力更强的候选模型更贵。如果少数几个难任务吃掉了大部分成本,可以考虑把它们路由到专门的模型组,或者换一个能解决更多此类任务的高效候选模型。 重复次数要够 – 模型输出每次运行都不一样。每组只跑寥寥几次时,一两个已解决任务的差别可能只是噪声。加大 --repeats,直到你在意的差异稳定下来;在据某段差距采取行动之前,先做一次统计检验,比如对解决率用 Fisher's exact test。 把轮次上限算进去 – --max-turns 设得太低,会亏待那些先探索再动手改的模型,因为留给它们修复失败编辑的轮次更少了。把上限设成与 agent 实际运行方式相符的值。 把输出上限算进去 – 如果某组的回复撞到了 max_tokens,测得的成本只是下界,而变短的回复也会让后续轮次重放的历史变短。比较对话成本前,先到 transcript 里查一下有没有被截断的回复。 把成本当估算看 – runner 是按 token 用量和 PRICES 表估算成本,不是按你的账单。prompt 缓存、批量推理和价格变动都会影响实际成本。请用 Amazon Bedrock 定价 和你的 AWS Cost and Usage Reports 核实。 测你真正要跑的那套设置 – 结论只对你测过的模型、profile 设置和任务成立。换了候选模型、改了 Stage 设置,或切到 Random profile,都要重新测量。
拿这些读数,为每个工作负载在三个选项里做选择:路由组、单模型组,或换了候选模型 / 设置的 profile。改动模型、prompt 或 agent 行为时,把同一套测量再跑一遍。
清理
为避免继续产生费用,把 stack 删掉。AWS CDK synth 这个 app 时需要一个 allowedCidr 值,但这里填什么都无所谓:
npx cdk destroy -c allowedCidr=203.0.113.0/24
CloudFormation 删除 master key secret 时不留恢复窗口,所以还需要的话先把密钥复制出来。网关镜像会留在 Amazon ECR 里的 AWS CDK bootstrap 仓库中。
结论
本文里,我们演示了如何在 AWS 上部署带 NVIDIA NeMo Switchyard 路由插件的 LiteLLM,如何为 Amazon Bedrock 上的模型配置 Stage 和 Random 路由,以及如何测量路由模型组与单模型基线各自的「每个已解决任务成本」。由于 agentic 任务的总成本取决于轮次、历史和重试,单看每 token 的价格并不可靠。在自己的任务上测量「每个已解决任务成本」,才能给你选配置的依据。
想上手,就在开发账户里部署示例仓库,拿自己工作负载里的任务测一测 Stage 路由和单模型基线。想了解更多,请看 Switchyard LiteLLM 插件指南 和 Amazon Bedrock User Guide。欢迎在评论区留言提问。
关于作者